 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
当你的大模型应用从本地开发环境进入到真正的业务生产阶段,最直观的挑战莫过于:随着请求并发数的暴增,曾经“好用”的单机环境开始变得捉襟见肘。
如果你还在纠结如何让模型吞吐量翻倍、如何处理复杂的张量并行(Tensor Parallelism),那么从实验级的本地框架迁移至生产级的 vLLM 部署,是每位开发者必经的进阶之路。
1. 从 Prototype 到 Production:为什么 vLLM 是必然选择?
许多开发者最初使用 Ollama 进行快速验证,但当业务需求演变为多用户并发访问、需要严格的 OpenAI 兼容接口时,vLLM 凭借其高效的 PagedAttention 内存管理,成为了当之无愧的生产首选。然而,vLLM 的高性能不仅依赖于算法,更依赖于底层的硬件并行策略。
我们在之前的文章中详细探讨过 Ollama 的入门部署,但面对生产环境,你需要考虑的不再只是“跑通”,而是“算得快”且“成本优”。
2. 算力选型:根据吞吐目标精准“切卡”
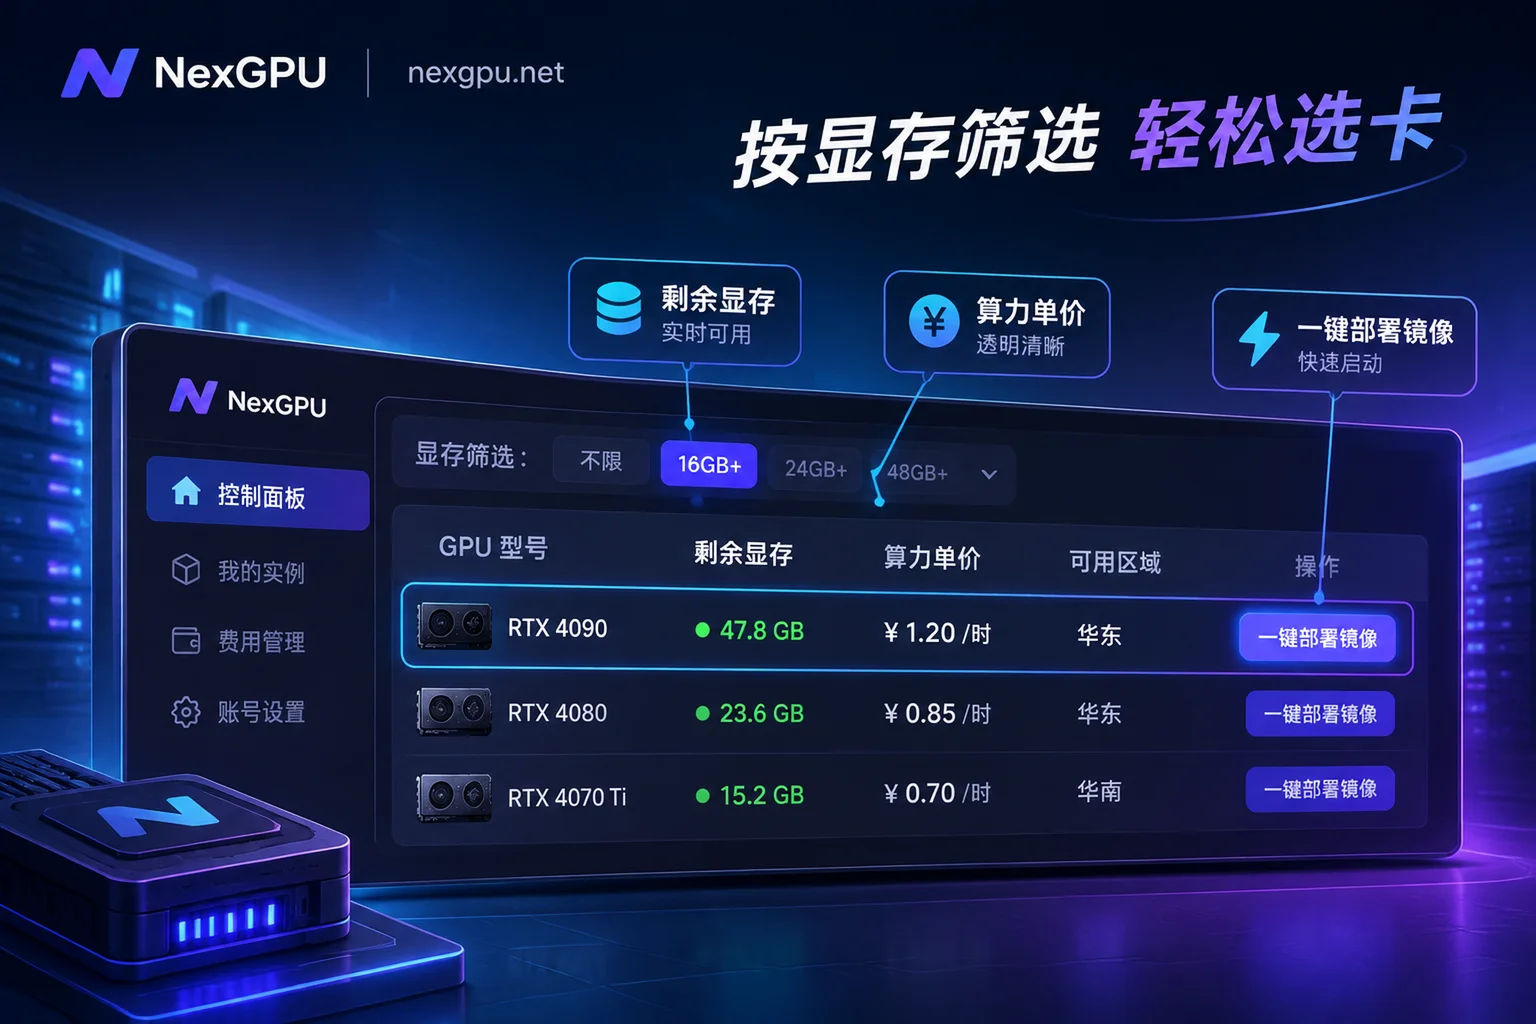
在生产部署中,显存是第一门槛,互联速度(如 PCIe/NVLink)则是第二瓶颈。NexGPU 提供的 GPU 市场 允许你按卡数、地区及价格灵活筛选,这在做分布式推理时尤为关键:
- 中小规模推理:推荐使用 RTX 4090 或 5090 集群,性价比极高,适合高并发下的轻量化模型服务。
- 超大规模模型(MoE/235B+):通过 多卡节点筛选 租用 A100/H200,利用多卡并行(TP/PP)分摊计算压力。
3. 一键式部署:NexGPU 镜像加速上线流程
与其浪费时间在安装 CUDA 驱动、配置各种版本的 vLLM 依赖环境上,不如直接使用我们预置的 镜像模板。这些模板预装了驱动与常用推理框架,拉起后即是 OpenAI 兼容接口,直接对接到你的后端服务。
如果你有特定的 CUDA 环境需求,也可以通过 自定义 Docker 镜像 进行部署。这种“开机即用”的模式,将部署时间从“小时级”压缩到了“分钟级”。
4. 精算 ROI:为什么按秒计费是生产环境的“救命稻草”?
很多开发者在选型时忽略了“隐形成本”。在 NexGPU 的计费系统 中,算力费按秒计量,实例停机后仅保留存储成本。这意味着你可以根据业务流量的高峰与低谷,实现算力的自动伸缩——高峰期开多台集群,低谷期一键停机保盘,将“云成本”转化为“效益成本”。
进阶参考:如果你在多卡推理利用率上遇到了瓶颈,请参阅我们之前的 多卡利用率排查指南,从并行设置到负载排查,系统性地优化你的推理吞吐量。
立即行动
无需实名认证,注册即刻开始你的生产环境构建。现在就去 NexGPU 市场,选一张最适合你模型的显卡,开启 vLLM 高性能推理之旅。


