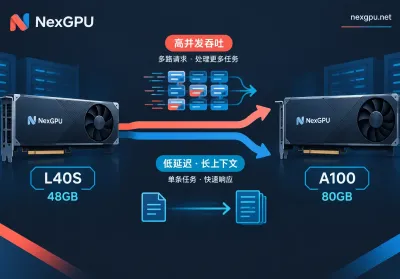
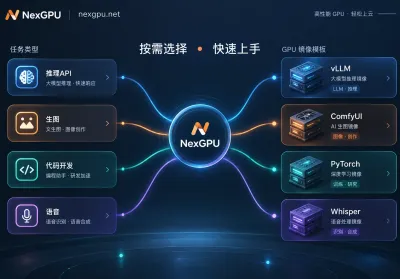
先说结论:单卡装得下、请求多、能用 FP8 的推理,优先选 L40S;单路对话要求快、上下文很长、模型大到必须多卡张量并行的,优先选 A100(尤其是 80GB SXM 版)。 如果说不清自己的任务属于哪一类,可以用同一个镜像在两张卡上各跑一轮同样的请求,这比反复对照参数表更可靠。下面按你手上要跑的任务逐项判断。先用三个问题对一下自己的任务模型多大,打...
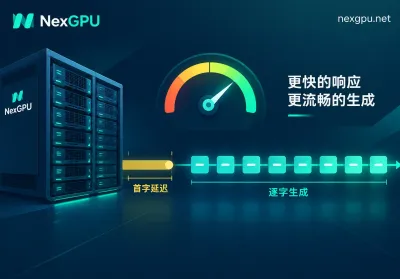
推理延迟高,先别急着换卡。建议先把延迟拆成两段:首字延迟(TTFT)和逐字延迟(TPOT,也叫 ITL)。首字慢通常出在预填充阶段,原因多是 prompt 太长,或者请求在排队。出字卡顿通常出在解码阶段,常见原因是显存带宽不够,或者正在生成的请求被新请求打断。这两类问题的瓶颈不同,处理方法也不同,搞错方向时调参往往没有效果。下面按排查顺序展开:先测,再...
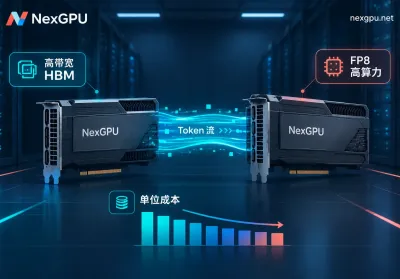
先说结论:请求并发高、模型能放进单卡(7B/13B,或 FP8 量化后的 30B 级),并且推理框架能开启 FP8 时,L40S 的每百万 Token 成本通常更低。并发低、要求逐字输出快、上下文很长,或者要把 70B 以上未量化模型切到多张卡上跑,A100 80GB 更合适,多卡时最好选 SXM 版本。两张卡的优势对应的是推理过程中的不同阶段。弄清楚...
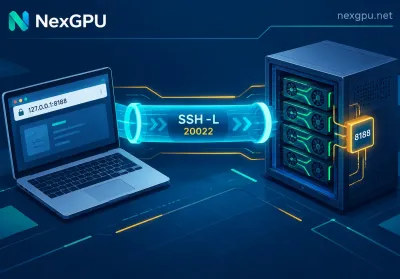
租来的 GPU 实例多数跑在容器和 NAT 网络后面,对外只开一个高位 SSH 端口,控制台上并没有一排随你勾选的端口。所以"端口映射"在实际操作里是两条路:SSH 本地端口转发(隧道)——不在公网上多开任何端口,本地浏览器访问 http://127.0.0.1:端口 就直达实例里的服务。第一次跑通、自己一个人用、调试阶段,选这条。平台公网端口映射——...
先问自己要跑什么任务租云 GPU 之前,先明确交付目标:是对外提供高并发 API 推理服务,还是自己做创意生图生视频,或是写代码做微调实验,还是批量转写音频?任务性质直接决定镜像模板的类型。生产级大模型推理或高并发 API 服务:直接选 vLLM 或 TGI(Text Generation Inference)镜像。这类镜像预编译好 PagedAtte...
0 条留言
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客