 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在本地通过 Ollama 运行开源大模型,已经成为开发者和 AI 爱好者的“标准操作”。然而,随着模型参数量的提升和对上下文长度要求的增加,显存往往成为了难以逾越的瓶颈。很多人面临的现状是:模型跑不起来,或者为了跑模型而被迫购买昂贵的硬件。
与其投入巨大成本购买难以升级的物理机,不如尝试 NexGPU 按小时计费的云端算力方案。通过 NexGPU,你可以根据当前任务实时租用显卡,无论是入门级的显存适配,还是企业级的高并发推理,都能找到最优解。
为什么选择 NexGPU 运行 Ollama?
1. 精准选卡,告别显存焦虑
NexGPU 的 GPU 市场 采用了极其直观的筛选方式。每一台机器都明确标注了显存、地区与实时价格。如果你在运行大模型时遇到 OOM(显存溢出),只需在后台查看 模型选卡指南,根据目标模型的量化需求选择最匹配的显存配置,避免“大马拉小车”的成本浪费。
2. “开机即用”的极简部署体验
传统的云服务器搭建环境往往耗时耗力,而在 NexGPU,你只需要在创建实例时选择预装好的 Ollama 镜像模板。这些镜像已经预置了驱动、CUDA 环境与必要依赖,拉起服务后即刻获得 OpenAI 兼容接口。如果你的代码有特定的 CUDA 版本依赖,NexGPU 也完美支持自定义 Docker 镜像。
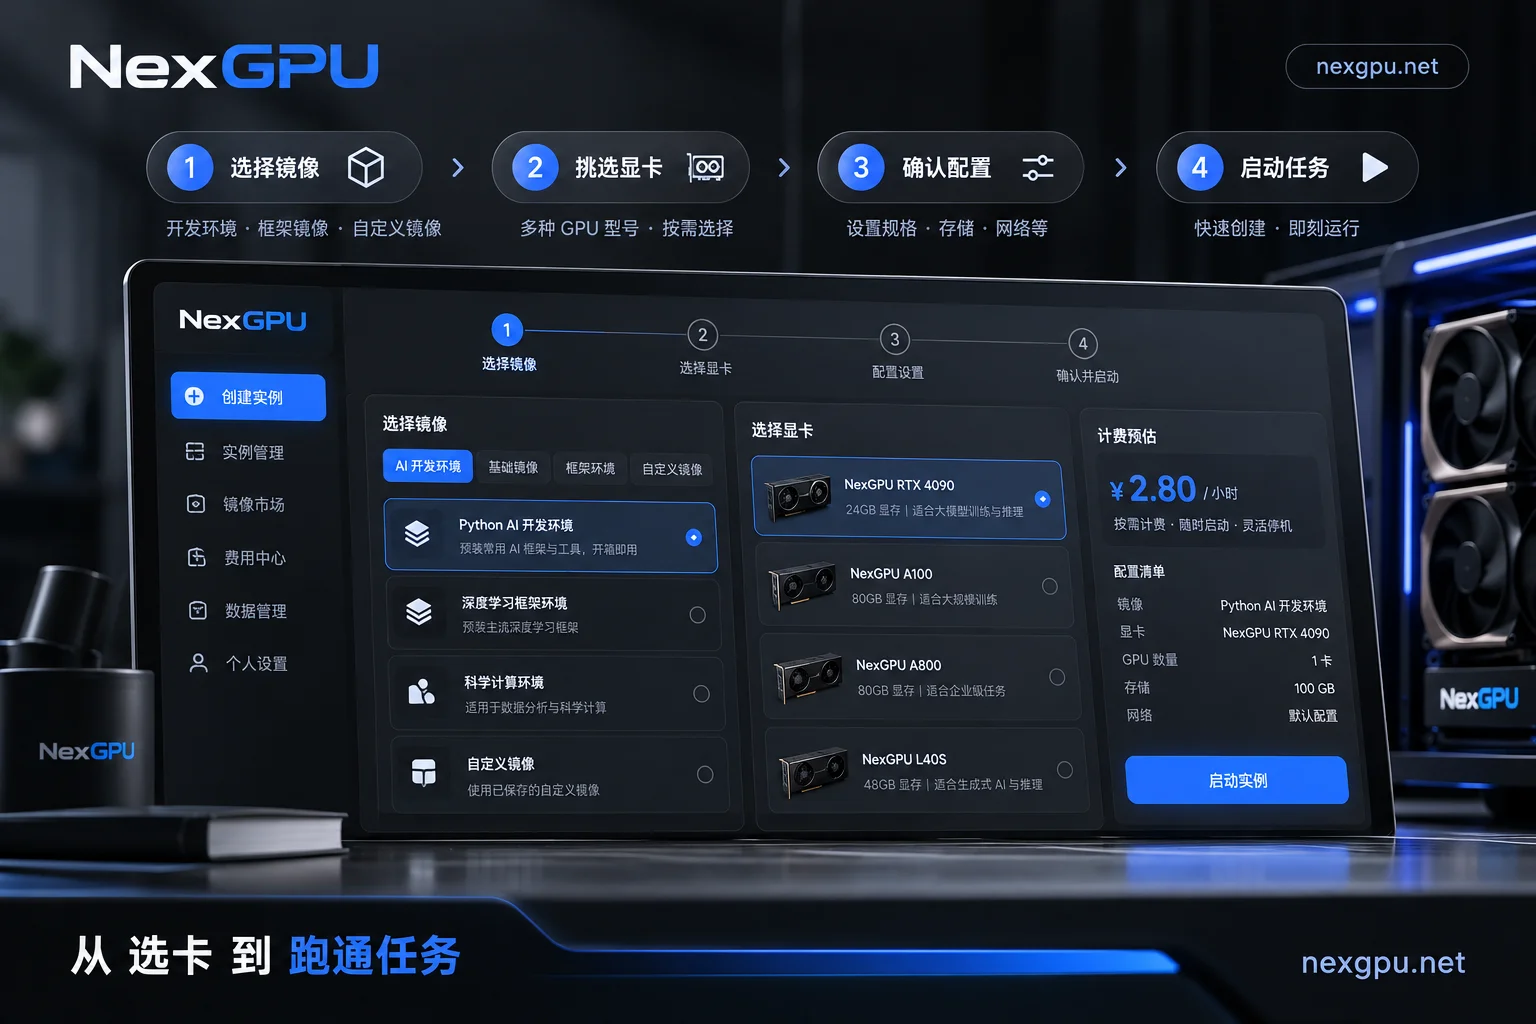
3. 灵活计费,把每一分钱花在刀刃上
NexGPU 坚持按秒计量、按小时计费,且没有任何最低消费或预付门槛。实例运行期间才计费,停机后仅收取存储费用。这意味着你可以把“租卡”视为开发者的“按需充电站”——训练或推理任务结束后,一键销毁即可立即释放资源,账单透明且实时可见。了解更多计费规则。
4. 从个人到企业的无缝扩展
对于初学者,你可以轻松租赁单张 RTX 3090 或 4090 进行调试;对于研发团队,NexGPU 提供了高性能多卡节点(A100/H100/H200 等),支持 RDMA 高速互联与私有网络,轻松应对复杂的分布式推理与微调需求。
下一步,如何开始?
如果你已经准备好迁移或升级你的 Ollama 推理环境,可以参考以下路径:
- 查看当前模型需求: 访问 NexGPU 模型选卡指南,快速定位适合你模型的显存档位。
- 快速入门: 查看 新手入门文档,从注册到连接服务器仅需几分钟。
- 获取算力支持: 直接进入 GPU 市场 挑选适合的机器,开启你的 AI 算力自由之旅。
注:站内关于 vLLM 高并发迁移 以及 DeepSeek 模型部署 的实战指南,也能为你提供进一步的参考。


