 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
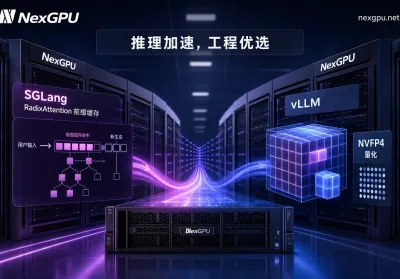
vLLM v0.26.0 发布后,SGLang部署还值不值得做?共享前缀吞吐领先 29% 的选型与落地指南
一、vLLM v0.26.0 上线后,SGLang部署的价值坐标变了吗2026 年 7 月 28 日,vLLM 发布 v0.26.0,带来三项重磅更新:NVFP4 模型量化支持、DeepSeek-V4 专用路由算子(官方称 E2E TPOT 降低 2.94%)以及基于对象存储的 KV Cache 分级卸载(fact_1)。一周后的 8 月 5 日,De...
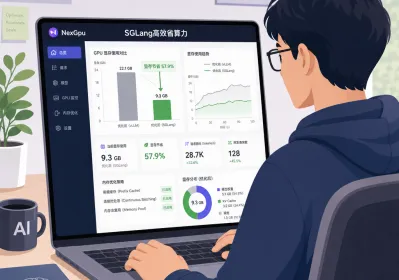
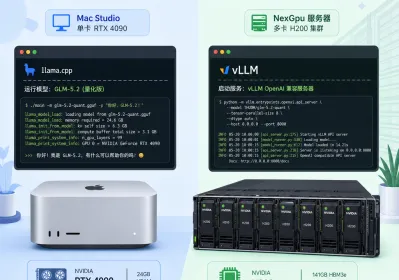

一、vLLM v0.26.0 上线后,SGLang部署的价值坐标变了吗2026 年 7 月 28 日,vLLM 发布 v0.26.0,带来三项重磅更新:NVFP4 模型量化支持、DeepSeek-V4 专用路由算子(官方称 E2E TPOT 降低 2.94%)以及基于对象存储的 KV Cache 分级卸载(fact_1)。一周后的 8 月 5 日,De...
