消费级显卡什么时候不够用:四条越界信号和换卡的判断口径

消费级显卡(RTX 3090、4090 这类 24GB 档位)不是「玩具」,单卡轻量推理、LoRA/QLoRA 小参数微调、常规图像视频生成,它的性价比都很好。真正会卡住的是四种情况:模型权重就放不下 —— 70B 级别的模型即使 4-bit 量化也装不进 24GB。微调把显存需求翻了好几倍 —— 推理能跑的模型,全参数微调未必能跑。上下文拉长或并发上...

云 GPU 镜像模板怎么选:按任务定模板,避开编译坑和存储费陷阱

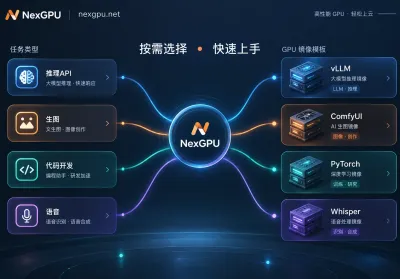
先问自己要跑什么任务租云 GPU 之前,先明确交付目标:是对外提供高并发 API 推理服务,还是自己做创意生图生视频,或是写代码做微调实验,还是批量转写音频?任务性质直接决定镜像模板的类型。生产级大模型推理或高并发 API 服务:直接选 vLLM 或 TGI(Text Generation Inference)镜像。这类镜像预编译好 PagedAtte...

TensorRT-LLM大模型推理加速教程:免编译部署5步

判断 TensorRT-LLM 当前怎么部署提速,只看 3 个条件:你的版本是否已是 1.2、GPU 是 Hopper 还是 Blackwell、模型权重是什么精度。NVIDIA 在 1.2 版正式移除了独立 TensorRT 编译后端,传统 trtllm-build 离线编译链路被彻底废弃,取而代之的是 PyTorch 原生执行后端,这让 Tenso...
H200租用价格下探到 $3.82/小时后,8×H200 单节点与 16 卡 H100 跨节点哪种更划算?

2026 年 8 月的按量 GPU 市场出现了一个值得注意的变化:搭载 141GB HBM3e 的 H200 租用价格下探到 $3.82 - $4.50/GPU-小时(例如 Jarvislabs 报 $3.99/hr、RunPod 报 $4.39/hr)[fact_1]。这一价格水平让「H200租用」从单纯的高端算力选项,变成了与 H100 正面竞争的...

2026年AI服务器租用选型与成本优化指南:如何兼顾算力性能与按量预算?

在生成式AI与大模型快速演进的背景下,AI服务器租用已成为广大AI开发者、算法工程师以及创业团队获取弹性算力的首选途径。随着大模型微调与高并发推理需求爆发,传统“直接买断硬件”的方式面临设备贬值快、初期投资大和运维成本高的挑战。因此,如何根据具体业务场景选择合适的GPU云服务器,并在保证算力性能的同时最大化降低使用成本,是每个算力采购决策者必须面对的核...