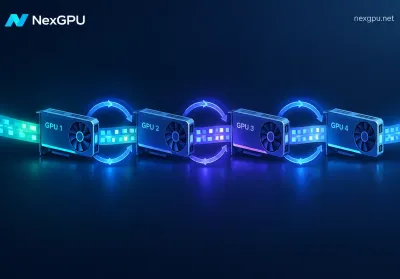
简单说,KV Cache 按序列切分,就是把同一个请求的 KV Cache 按 token 位置(序列长度这一维)拆开,分给多张 GPU 保存。比如一个 128K token 的请求放到 4 张卡上,每张卡只存其中约 32K 个位置的键(K)和值(V),不用每张卡都保留完整的 128K 上下文。框架文档和论文里一般把这种做法叫上下文并行(Context...
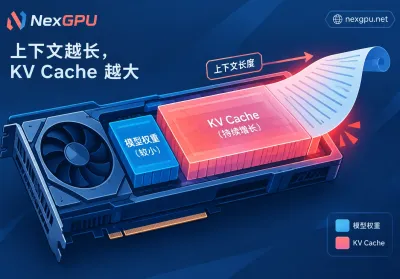
长上下文推理报 OOM,多数时候不是模型权重装不下,而是 KV Cache 随上下文长度和并发数一起增长,占满了显存。可以按这个顺序处理:先确认 OOM 出在哪一步,再估算 KV Cache 有多大,然后按改动代价从低到高依次尝试:限制长度和并发、把 KV Cache 量化成 FP8、开启分块 Prefill 和前缀缓存、把 KV Cache 卸载到 ...
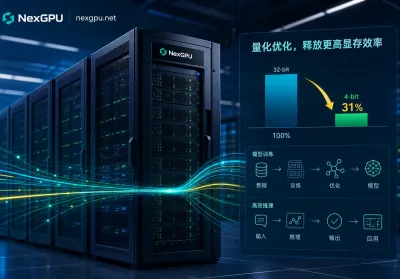
先回答:量化省的不是同一块显存,收益也不能简单相加要算清FP8与INT4量化对GPU显存的影响,第一步先把显存占用拆成四笔互不替代的账:权重占的固定空间、随并发与上下文线性增长的KV Cache、计算过程中的中间张量、以及推理引擎与CUDA上下文的常驻开销。权重量化压的是第一笔,FP8 KV Cache压的是第二笔,中间张量与常驻开销基本不随量化下降—...
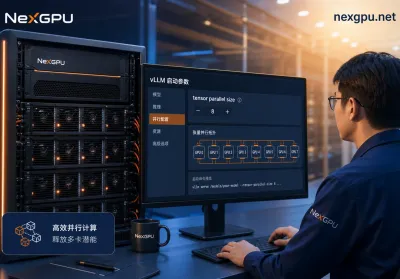
先给结论:vLLM多卡张量并行配置指南的参数决定顺序很多人以为把 --tensor-parallel-size 调得越大,多卡推理就一定越快,但实际上 TP 设多少要由显存分账和模型注意力头数共同决定,不是越大越好。正确的思路是:先按四笔显存账算出 TP 下限,再按注意力头数整除约束和卡间互联确定上限,然后依次调整 --gpu-memory-utili...
GPU利用率优化不是把利用率数字拉高,而是先打开监控面板,把 GPU 利用率、请求排队时长和前缀缓存命中率三个指标并列出来,再按下面的顺序排查:利用率数字→排队→带宽→重复计算→引擎选型。只看 nvidia-smi 的静态占用已经不够,需要结合请求分布和引擎参数做系统化判断。先给结论:GPU利用率优化的排查顺序是什么第一步,确认你看到的“利用率”数字到...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客