 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
MoE 的专家负载不均出现在两个阶段,表现和根因都不一样。动手排查之前,先判断自己属于哪一种:
- 训练或微调时:路由本身在退化。少数“热专家”接走了大部分 token,另一些专家几乎收不到输入,成了“死专家”。如果设置了容量上限(capacity factor),token 丢弃率还会跟着升高。根因通常在路由器和平衡损失上。
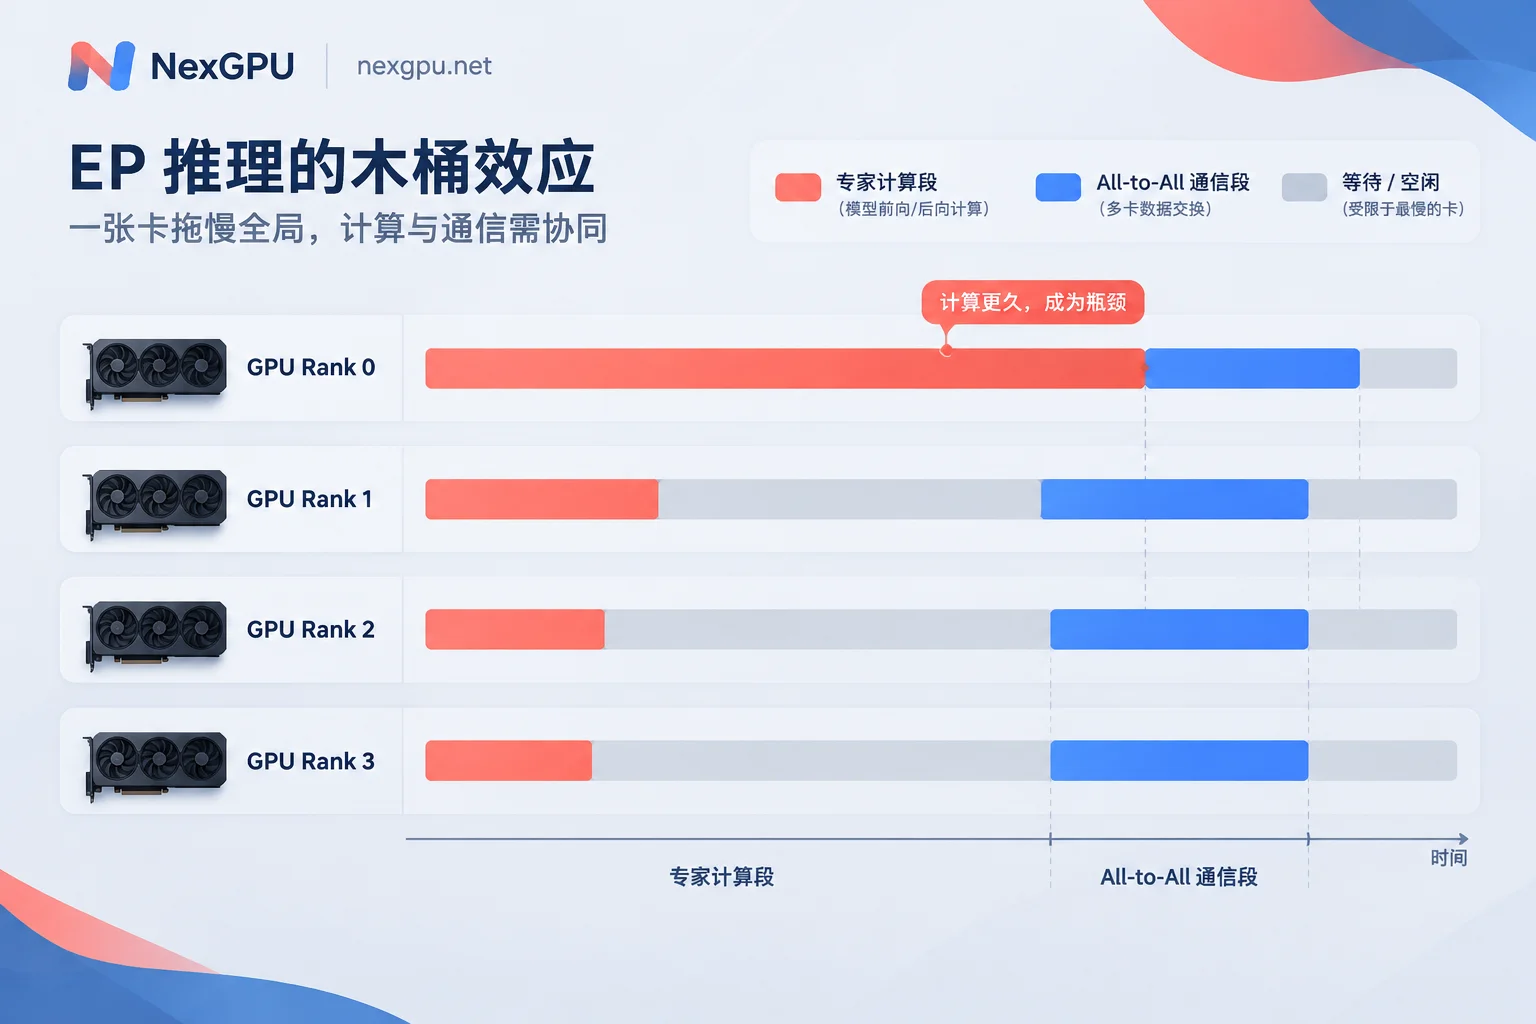
- 多卡推理并开启专家并行(EP)时:模型权重已经固定,问题表现为各 GPU 的计算耗时不一样,算得快的卡要在 All-to-All 通信处等算得慢的卡,TTFT 和 TPOT 的尾部延迟明显拉长。根因多半在请求数据分布和专家在各卡上的摆放方式。
如果你做的是推理,但用的是张量并行而不是 EP,每个专家的权重会被切到所有卡上,专家之间冷热不均一般不会造成卡与卡互相等待。这种情况下吞吐上不去,先按多卡推理为什么吞吐没有翻倍里的思路排查并行方式和互联。
训练或微调:按四步查路由
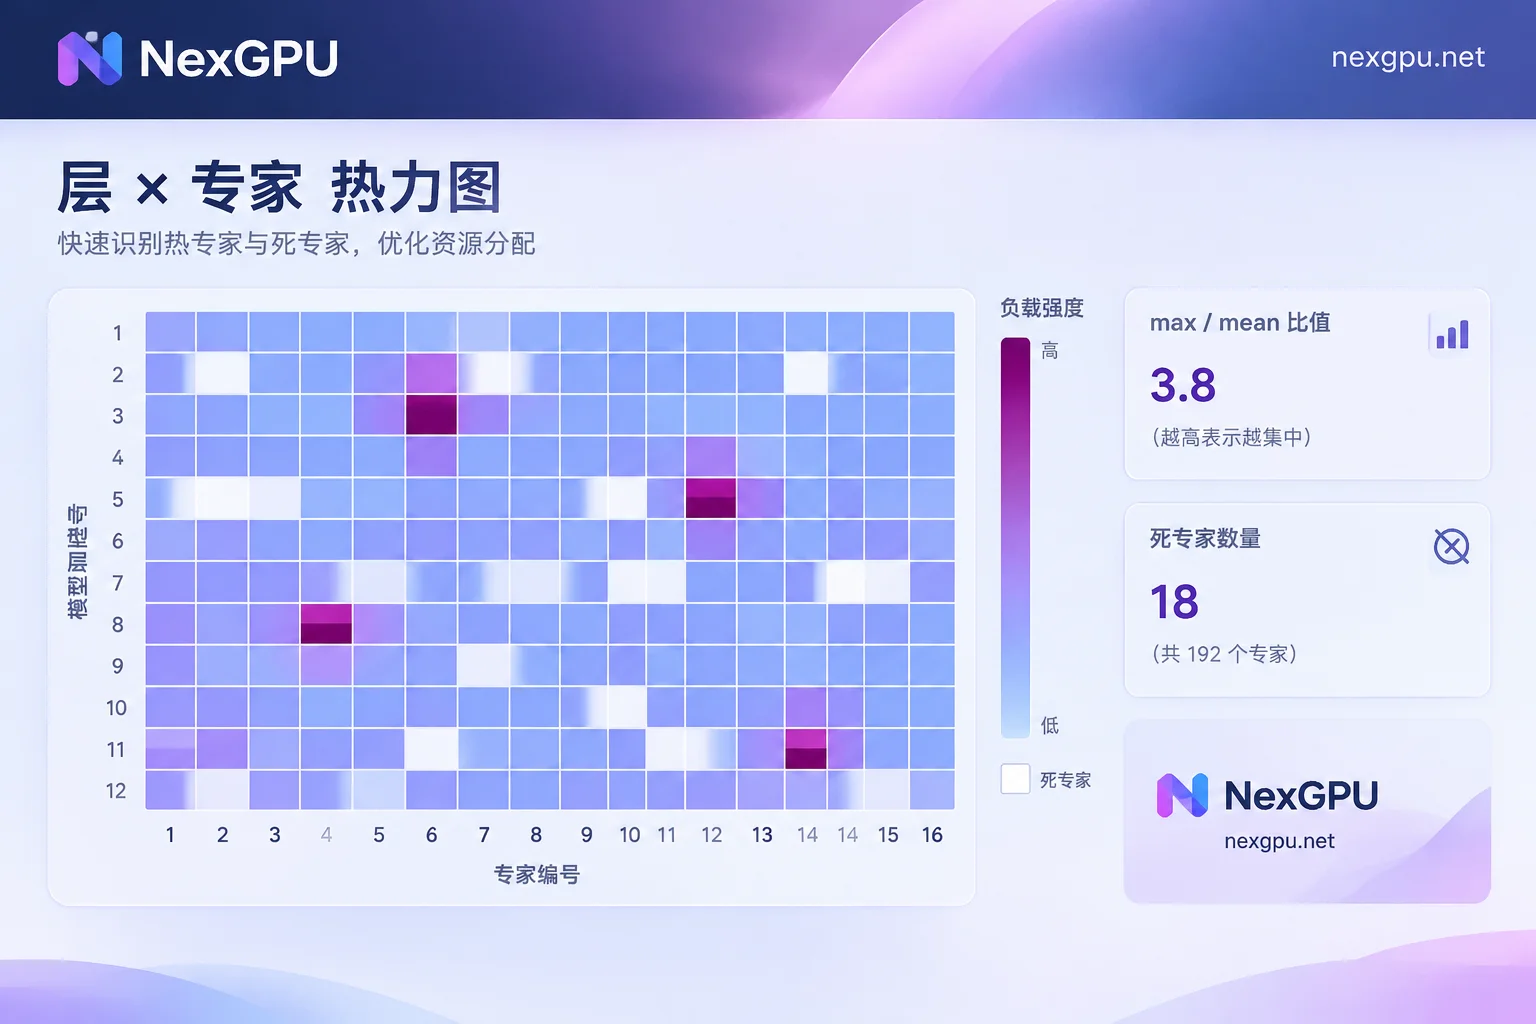
第一步:逐层统计每个专家分到多少 token
这一步要拿到两组数:每个专家实际分到的 token 占比 f_i,以及路由器给它的平均概率 p_i。按层画成直方图或热力图,看是否有极端倾斜。单卡跑一个小批量前向就能完成。以 Hugging Face Transformers 中的 Mixtral 为例:
import torch

@torch.no_grad()
def expert_load(model, batch, top_k=2):
    out = model(**batch, output_router_logits=True)
    mask = batch["attention_mask"].flatten().bool()  # 去掉 padding token
    report = []
    for layer, logits in enumerate(out.router_logits):
        logits = logits[mask]                        # [num_tokens, num_experts]
        chosen = logits.topk(top_k, dim=-1).indices.flatten()
        load = torch.bincount(chosen, minlength=logits.shape[-1]).float()
        report.append({
            "layer": layer,
            "max_over_mean": (load.max() / load.mean()).item(),
            "dead_experts": int((load == 0).sum()),
        })
    return report
读结果时看三点:
- max/mean 比值:最忙的专家比平均水平多出多少。这个比值没有通用阈值,要拿同一模型训练前和训练后对比,或者把不同层放在一起对比。
- 死专家数量:某层有专家完全收不到 token,说明那一层的路由已经塌缩。
- 变化趋势:用领域数据微调时,出现一定程度的专家分化是正常的。真正需要处理的是随训练步数持续恶化的倾斜。
第二步:确认平衡损失真的起了作用
辅助负载均衡损失(auxiliary balancing loss)是压制路由偏向的主要手段。它的曲线应该存在、不为零,并且在倾斜加剧时有所响应。如果曲线正常但倾斜照样恶化,可能是损失权重设得太低,压不住偏向。
微调时常见的几个坑:
- 损失根本没加进来:在 Transformers 的 Mixtral 实现中,只有打开
output_router_logits时,辅助损失才会按router_aux_loss_coef加到总损失里。很多微调脚本默认没打开这个选项。不同版本的实现可能有差异,以你所用版本的源码为准。 - 路由器被冻结了:用 LoRA 微调时,如果目标模块里没有门控层,路由器权重根本不会更新,辅助损失也就无从生效。这种情况下看到的不均,来自你的数据和原始路由的组合。
- 用的是无辅助损失方案:DeepSeek-V3 这类 auxiliary-loss-free 策略不靠损失项来做均衡,而是按负载动态调整每个专家的偏置(bias),这个调整不经过梯度。它的效果在损失曲线上看不出来,要直接确认偏置更新已经开启,并监控各专家偏置值的变化。
第三步:看 Router logits 有没有数值发散
如果门控层输出的 logits 越来越大,softmax 会变得非常尖锐,路由会接近“每个 token 只认一个专家”。建议额外记录两样东西:
- 每层 router logits 的最大绝对值;
- Router Z-Loss,即 logits 先做 logsumexp 再平方后的均值。
如果这两项和负载倾斜同步上升,问题更可能出在门控层的数值稳定性上。可以加入 z-loss 或对门控 logits 做归一化,再观察倾斜是否缓解。
第四步:检查平衡损失的统计范围和容量设置
- 统计范围:Megatron-Core 早期实现等框架可能只在单卡或局部批次内统计平衡损失。如果每个批次只来自同一个领域,强行在批次内做均衡,反而会抑制专家的自然分化。Qwen 团队提出的做法是在全局批次上统计平衡。这种情况下,不要一味调大损失权重,先确认统计口径。
- 容量与丢弃:设置了 capacity factor 时,token 丢弃率要单独监控。丢弃率高意味着有 token 直接跳过了专家计算,会影响效果。可以提高容量因子(代价是显存占用增加),也可以换成 MegaBlocks 这类基于 block-sparse 算子的无丢弃(dropless)MoE。
多卡推理(EP):先找出拖后腿的那张卡
用 Profiler 分清“算得慢”还是“传得慢”
在 vLLM、SGLang 上做 EP 部署时,按 rank 抓取每张卡的专家计算 kernel 耗时,以及 dispatch/combine(也就是 All-to-All)的等待时间。
- 某一张卡的专家计算明显偏长,其他卡的 All-to-All 等待也随之变长:这是典型的负载不均木桶效应。
- 所有卡的计算耗时都差不多,但通信普遍偏长:问题更可能在卡间互联或并行配置上,不是专家冷热造成的。可以参考张量并行和流水并行怎么选,重新评估并行方式。
用真实流量统计专家命中
用随机 prompt 压测时,专家分布往往看起来很均匀,到了线上才暴露倾斜。建议抽样真实请求,按层统计各专家 ID 的命中次数,重点看两类流量:多模态请求中的 vision token,以及垂直领域的指令。它们容易集中命中少数几个固定专家。确认了热点专家的 ID 之后,再查这些专家被放在了哪张卡上。如果几个热点恰好挨在一起,被分到同一个 rank,那张卡就会成为瓶颈。
处理办法:重映射或复制热点专家
vLLM 提供 Expert Parallel Load Balancer(EPLB),可以根据运行时的负载统计重新安排专家在各卡上的位置,也可以把热点专家冗余复制到多张卡上分流。需要注意两点:冗余副本会占用额外显存,重排本身也有开销。参数名称在不同版本之间有变化,开启前以你所用版本的 vLLM 文档为准。
在租用的 GPU 上排查时注意什么
- 按问题类型决定租几张卡:训练侧的路由统计(上面第一到第三步)用单卡跑小批量前向就能完成,不必一开始就租多卡。EP 推理的尾延迟问题必须在真正的多卡节点上才能复现,而且卡间互联方式会直接影响 All-to-All 的耗时,选节点时要把互联考虑进去。
- 环境直接用现成镜像:在 NexGPU 上可以从镜像模板里选 vLLM 或 PyTorch 镜像一键部署,省去自己配环境的时间,直接开始跑 Profiler 和统计脚本。
- 结果要先存好再销毁:Profiler trace 和每层路由统计都写到持久存储里。停机后算力费停了,但存储费照常收;实例销毁后所有费用停止,数据也随之删除。所以销毁前先把结果下载下来。
如果问题只能在多机 EP 下复现,需要评估多节点或集群资源,可以联系 NexGPU 销售沟通多卡方案。


