 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
多数情况可以按这条规则选:单台机器里的多张卡,并且卡之间有 NVLink 这类高速互连,就优先用张量并行(TP);模型大到一台机器装不下、需要跨机时,机内用 TP,机器之间用流水并行(PP)。 如果模型和 KV Cache 一张卡就能装下,先别切分模型。这种情况下用单卡,或者开几个独立副本,通常更省事。
下面说明这条规则的依据,以及几种需要另做判断的情况。
先回答三个问题
动手前先确认三件事:
- 显存够不够:模型权重加上 KV Cache,在你要用的精度(BF16、FP8、INT4 等)和上下文长度下,单卡能不能装下。不同模型的显存门槛差别很大,可以先查对应模型的选卡指南,也可以参考 48GB 显存能跑多大的模型。
- 卡之间怎么连:是 NVLink/NVSwitch,还是普通 PCIe;需要跨机时,节点之间走什么网络。在机器上执行
nvidia-smi topo -m可以看到卡间连接方式。 - 任务追求什么:在线服务更看重首字延迟和出字速度;离线批量推理更看重总吞吐;训练和微调又是另一套思路,后文单独说。
三个问题有了答案,选择基本就定了。
两种并行的区别
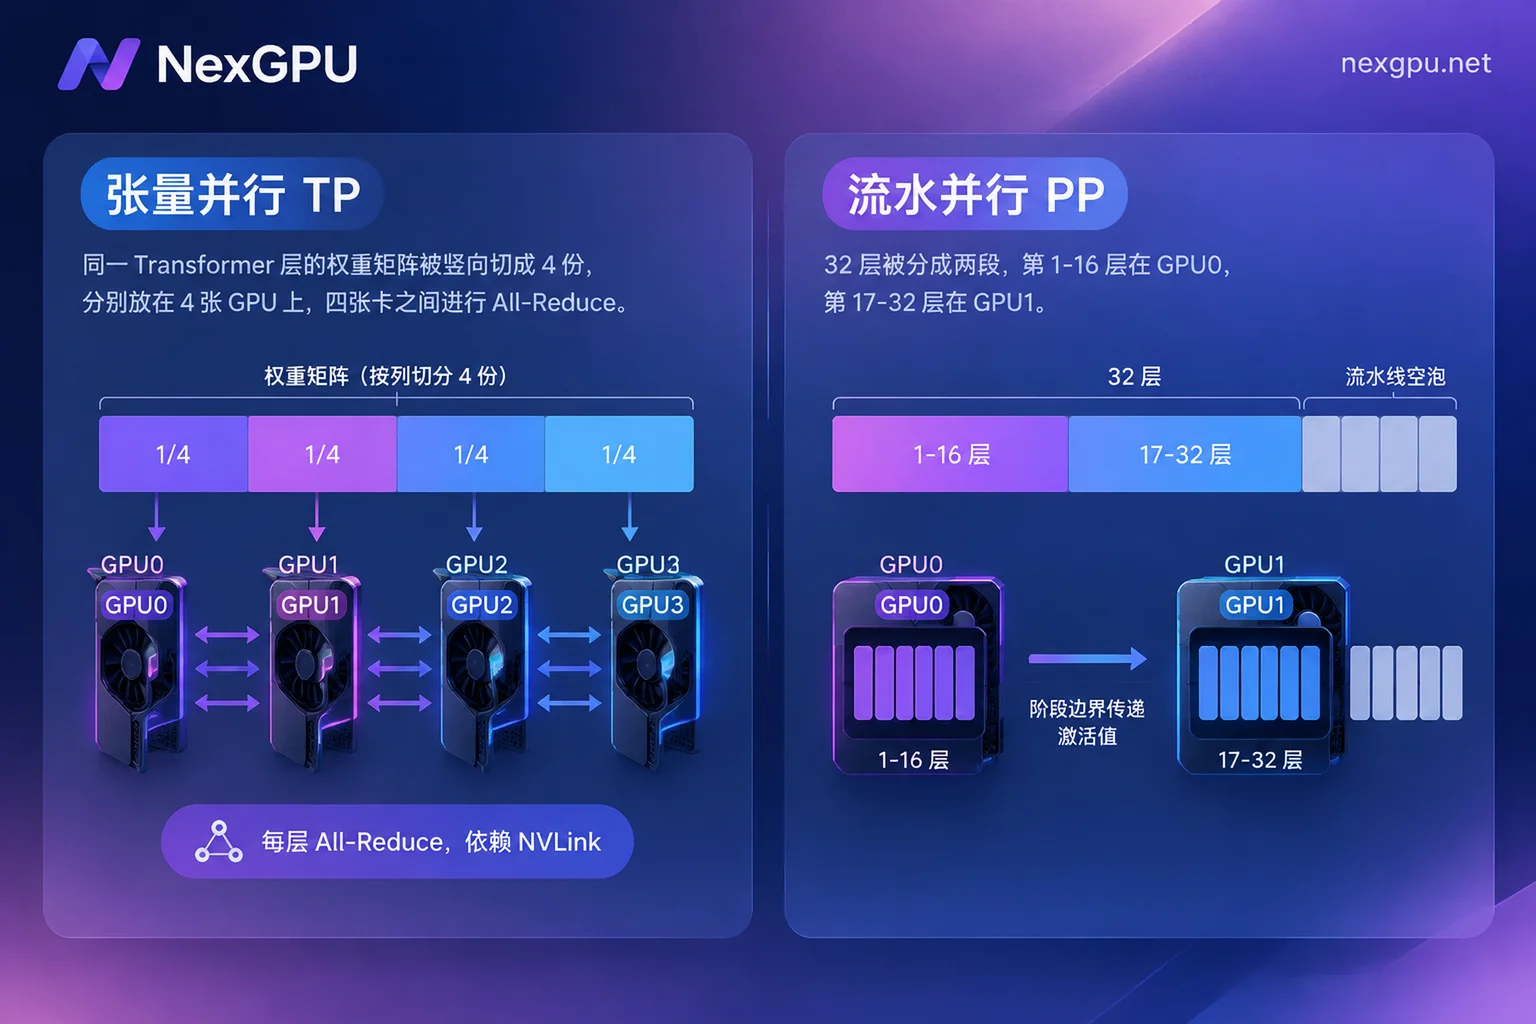
张量并行是在层内切分。 Transformer 每一层里注意力的 QKV 矩阵和 MLP 的权重矩阵,会被拆到多张卡上同时计算。每张卡都参与每一层的计算,每一层算完都要做 All-Reduce 或 All-Gather 来同步结果。
流水并行是按层分段。 连续的层被划成若干阶段,例如第 1–16 层放在卡 0,第 17–32 层放在卡 1。卡与卡之间只在阶段交界处传递一次中间激活值,用的是点对点通信。
两者的取舍都从这个区别来:
| 张量并行(TP) | 流水并行(PP) | |
|---|---|---|
| 通信频率 | 每层都同步,次数多 | 只在阶段边界传递 |
| 对互连的要求 | 带宽高、延迟低,通常需要 NVLink | 较低,可以跨节点网络 |
| 单请求延迟 | 可以降低,多卡同时算一个 token | 会增加,请求要依次经过各阶段 |
| 主要短板 | 互连慢时,通信开销会抵消计算收益 | 存在流水线空泡,并发低时卡会空闲等待 |
推理:单机和多机分别怎么设
单机多卡
模型单卡放不下时,先在一台机器内用 TP。以 vLLM 为例:
vllm serve <模型名或路径> --tensor-parallel-size 4tensor_parallel_size 通常设为 2、4 或 8,并且要能整除模型的注意力头数。整除不了,启动时就会报错。
用 TP 的好处是一个 token 的计算分给多张卡同时完成,首字延迟(TTFT)和每个 token 的生成时间(TPOT)都能下降,所以对延迟敏感的在线服务一般首选 TP。
单机 8 卡也装不下
超大模型、全精度或很长的上下文,可能 8 张卡也放不下。这时用混合并行:机内用 TP,数量等于单机卡数;机间用 PP,数量等于节点数。比如两台 8 卡机器:
vllm serve <模型名或路径> \
  --tensor-parallel-size 8 \
  --pipeline-parallel-size 2
这样安排,是因为通信量最大的 TP 留在机内高速互连上,跨机网络只承担 PP 那部分较少的传输。如果反过来让 TP 跨机,每一层的同步都要走网络,速度会明显变慢。
卡之间只有 PCIe
很多消费级卡和部分 PCIe 版本的数据中心卡没有 NVLink。在这种环境下把 TP 开得很大,层间同步的开销可能把多卡带来的收益抵消掉。可以这样处理:
- 能用量化让模型装进更少的卡,就先减少卡数;
- 确实需要多卡时,用 TP=2 和 PP=2 这类组合,在真实并发下各跑一遍,分别比较延迟和吞吐,不要直接按理论推算;
- 如果多卡吞吐远不如预期,可以参考 多卡推理为什么吞吐没有翻倍 逐项排查。
用了 PP 之后吞吐不高
流水并行有一个固有问题:前一个阶段没算完,后一个阶段只能等,这段空闲叫流水线空泡。请求少的时候,大部分卡会处在等待状态。要提高吞吐,需要有足够的并发请求,或者用 micro-batching、chunked prefill 等方式把流水线填满。所以 PP 更适合高并发服务和离线批量推理,不适合只有一两个用户、又要求响应快的场景。如果你遇到的主要问题是延迟,可以先看 大模型推理延迟高怎么优化,区分是首字慢还是出字慢。
训练和微调:先不用急着切模型
训练时的选择顺序和推理不同:
- 显存够用时,先用数据并行和显存优化,例如 DDP、ZeRO 或 FSDP。它们不切分模型的计算,实现简单,扩展效率也比较好。
- 单层参数或激活值超过单卡容量时,在单机内加入 TP。
- 规模扩展到多机时,采用常说的 3D 并行:TP 限制在单机 8 卡以内,以利用 NVLink;节点之间用 PP 和 DP 组合,减少跨机通信带来的瓶颈。
对大多数 LoRA 或中小模型的全参微调来说,第一步就够用了。
快速对照
- 单卡装得下:不切模型;需要更多吞吐时多开几个副本。
- 单机装得下,并且有 NVLink:只用 TP。
- 单机装得下,但只有 PCIe:尽量少用卡,并实测 TP 和 PP 两种组合。
- 单机装不下:机内 TP + 机间 PP。
- 训练或微调:先用 DP/ZeRO/FSDP,单层放不下再加 TP,多机用 3D 并行。
租卡前要确认的事
定好并行方案后,硬件要求也就明确了:用 TP 需要同一节点内有足够多的卡,并且最好有高速互连;用 PP 跨机需要多个节点之间网络可用。在 NexGPU 上,可以先到 价格与可租节点 页面筛选单节点卡数合适的机器,开机后先运行 nvidia-smi topo -m 确认互连方式,再决定 TP 设多少。如果对节点配置有疑问,可以通过 Telegram 中英双语客服确认。部署时可以直接用 vLLM 或 TGI 镜像模板,不用自己配环境。
费用上注意一点:试不同并行组合时,机器只是停机的话仍然会收存储费,销毁后才完全停止计费。测完的配置要及时销毁,需要保留的权重和测试结果先另外存好。
如果评估后确定需要跨节点的多机方案,或者需要长期使用固定规模的集群,可以 联系销售 沟通。联系前可以先按 企业 GPU 集群咨询需求清单 整理好模型规模、精度和并发目标,沟通会更快。


