 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
多卡推理吞吐要接近翻倍,前提是新增的卡在处理更多请求,而不是和原来的卡一起算同一个请求。
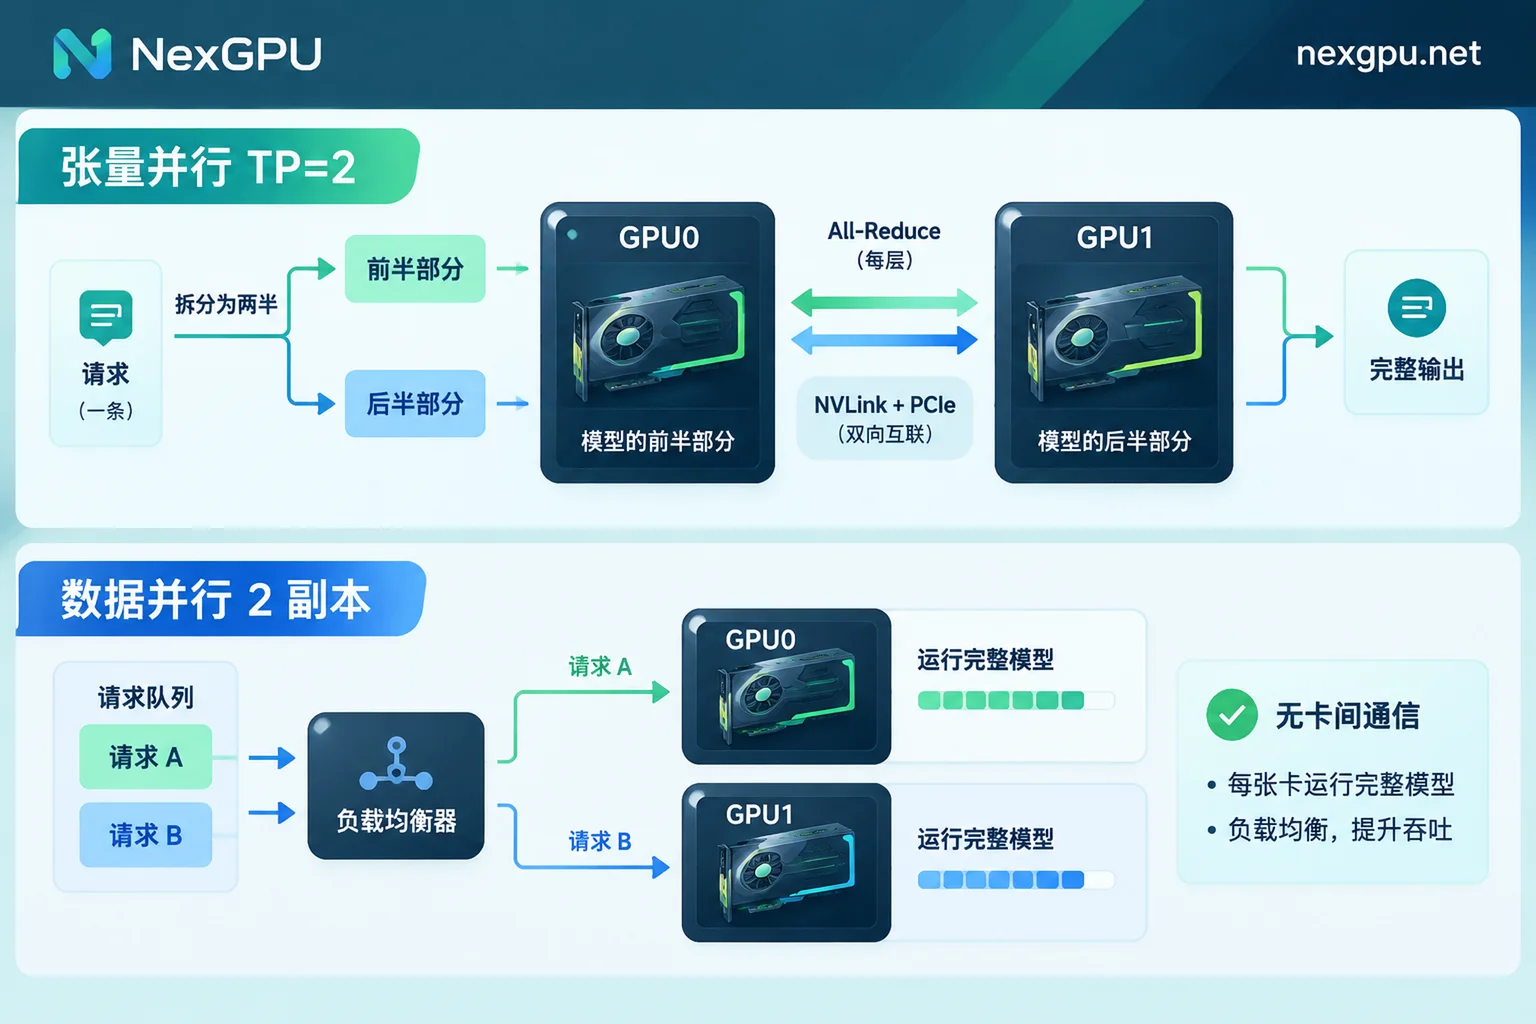
很多人从 1 卡换成 2 卡时,只把 tensor-parallel-size 从 1 改成 2。这是张量并行(TP):两张卡各算模型的一半,每一层都要交换中间结果。它主要解决两件事:模型单卡放不下,以及单个请求太慢。它的设计目标不是把吞吐翻倍。如果模型本来就能装进一张卡,改成 TP=2 后吞吐持平或略降,都是正常现象。
想让吞吐随卡数增长,通常要用数据并行(DP),也就是每张卡跑一个完整的模型副本,由前面的网关把并发请求分到各个副本上。
先确认:你用的是哪种并行
排查之前,先看启动参数或部署方式属于下面哪一种:
- 张量并行 TP:多张卡共同承载一个模型,同一个请求在多卡间切开计算。vLLM 里对应
--tensor-parallel-size。 - 数据并行 DP / 多实例:每张卡(或每组卡)各有一份完整模型,彼此独立接请求。可以用 vLLM 的数据并行参数,也可以用
CUDA_VISIBLE_DEVICES分别起多个实例,再在前面放一个负载均衡。 - 流水线并行 PP:按层把模型切成几段,每段放在不同的卡上,请求依次流过。vLLM 里对应
--pipeline-parallel-size。
只有 DP 是在增加能独立处理请求的副本。TP 和 PP 都是把一个副本拆到多张卡上,所以不会天然带来成倍的吞吐。
吞吐上不去的几个原因
1. TP 每一层都要跨卡通信
张量并行在注意力层和 MLP 层都要做集合通信(All-Reduce / All-Gather),而且是每一层都做。卡之间的互联带宽,决定了这部分开销有多大:
- 数据中心卡配有 NVLink / NVSwitch,通信损耗相对较小,TP 的收益比较明显。
- 消费级多卡大多只靠 PCIe 互联,通信等待会很显著,TP 开得越宽,收益递减得越快。
如果你租的是几张消费级卡,又给一个单卡就能放下的模型开了 TP,吞吐不升反降的概率不小。
2. Decode 阶段卡在显存带宽,而不是算力
生成 token 的 Decode 阶段,瓶颈主要是显存带宽。并发请求少、batch 小的时候,多给一张卡的算力也用不上,tokens/s 自然不会翻倍。
TP 对吞吐的帮助其实是间接的:多张卡的显存合起来,可以放下更大的 KV Cache 池,连续批处理(Continuous Batching)就能同时容纳更多请求。这只有在并发量足够高时才会显现。用单个请求或很低的并发去压测,看到的多卡收益会严重偏低。
3. TP 切得太宽,每张卡的活太碎
TP 宽度大、请求批次小的时候,每张卡分到的矩阵乘法(GEMM)尺寸很小,GPU 的流式多处理器(SM)喂不饱,利用率下降。4 卡 TP 跑一个中等模型、又只有少量并发,常常就是这种情况。
4. PP 有顺序依赖和调度气泡
流水线并行可以装下超大模型,但各段之间要按顺序传递,中间会有空等(bubble)。它没有增加并行的推理副本,单靠 PP 也换不来成倍的吞吐。
按模型大小选并行方式
模型 + KV Cache 单卡放得下:优先多副本(DP)。
副本之间在前向计算时不需要集合通信,这是最接近线性扩展吞吐的做法,vLLM 也建议单卡显存充足时优先用 DP 扩展服务吞吐。在 PCIe 互联的消费级多卡上,这一点更重要。代价是单个请求的延迟不会因为加卡而降低。
单卡放不下:用能放下的最小 TP 宽度,再按副本扩展。
比如两张卡刚好能装下模型,就设 TP=2,而不是直接上 TP=4。剩下的卡再组成第二个 TP=2 的副本做 DP。TP 尽量放在有 NVLink 的卡之间。
更关心单请求延迟(首字时间、出字速度):TP 才是对应的工具。
这时 TP 带来的低延迟是你要的结果,吞吐没翻倍并不代表配置错了。延迟问题的具体调法可以看大模型推理延迟高怎么优化。
模型大到一台机器装不下:再考虑 PP。
常见做法是机器内部用 TP,跨机器再叠加 PP。要接受流水线带来的气泡开销。
怎么测,结论才可信
- 用接近真实业务的并发去压测。 低并发下 TP 和 DP 的差距会被掩盖,也会让人误以为多卡没用。
- 同时记录吞吐和延迟。 吞吐看 tokens/s 或 req/s,延迟看首字时间和每 token 时间,因为 TP 和 DP 往往一个赢延迟、一个赢吞吐。
- 在同样的卡数下对比两种方案,例如两张卡分别测「TP=2 单副本」和「TP=1 双副本」,按你的业务目标选。
- 留意 KV Cache 余量。 单卡虽然放得下权重,但如果放完之后几乎没有空间给 KV Cache,并发上不去,这时 TP 扩大显存池反而可能更划算。
两张中端卡和一张大显存卡之间怎么取舍,可以参考两张 L40S 能替代一张 A100 吗,里面按瓶颈类型分开讨论了这个问题。
在 NexGPU 上做这组对比
上面的对比测试通常几个小时就能完成。在 NexGPU 上可以直接用 vLLM 等镜像模板部署,按小时计费、按秒计量,也没有最低消费。不同模型需要多少显存、该租哪张卡,可以先查官网的模型选卡指南。
计费上有一点需要注意:测试实例停机后仍然会收存储费,只有销毁后才完全停止计费。所以测完不用的配置要及时销毁,需要保留的模型文件和压测结果先另外存好。
如果测出来需要多机 TP + PP,或者要长期运行多副本服务,可以带上模型、目标并发和延迟要求联系 NexGPU 评估多卡方案。


