 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
如果你的团队要承接训练、微调或推理任务,正在犹豫是“买服务器放机房托管”还是“直接租 GPU”,结论如下:
- 负载还在变化、业务处于探索期、模型换代快:先租。租用没有启动成本,可以随用随停,也能按任务换卡。
- 负载长期稳定、卡几乎一直满负荷运行、架构两三年内不会大改,而且团队有人能管机房和硬件:自购托管才可能更省。
决定哪边划算的,不是某张卡的采购价或租用单价,而是你的卡在使用寿命内有多少时间在做有效计算。下面按这个思路把账拆开。
两种方式的钱花在哪
自购托管属于资本支出。 一台 8 卡数据中心级服务器(H100/H200 这一档)的整机采购价通常以数十万美元计,需要一次性付款或走融资。付款之后还要经历芯片采购周期、到货和上架调试,这段时间业务只能等。
租用属于运营支出。 租用不需要预付硬件款,按小时计费,开机即可使用,任务结束就停。
两种支出的性质不同:前者买的是「未来两三年的算力容量」,用不用都已经付了钱;后者买的是「实际用掉的时长」。
托管的真实成本远不止服务器
很多团队算托管成本时,只拿服务器价格除以使用年限,这样会严重低估。高密度 AI 服务器至少还要算上这些开销:
- 电力与机柜:单机柜功耗常在 30kW–40kW 甚至更高,普通机房的配电承受不了,需要找支持高密度的机柜。
- 散热:往往要用液冷(冷板式或浸没式)或后门热交换,这类机位更贵,也更难找。
- 网络:多线 BGP 或专线带宽按月付费。
- 合约期:机柜一般要签固定期限,业务缩水也照样付钱。
- 维保与备件:掉卡、过热降频、硬件损坏都要有人处理,需要准备备件或签维保合同。
- 运维人力:驱动、CUDA、容器编排、监控告警都要自己搭建和维护,出故障要人工介入。
- 折旧与换代:模型对显存和互联带宽的要求变化很快。两三年后,旧卡可能显存不够、互联也跟不上,资产贬值由自己承担。
租用时,这些开销大多由平台承担。预置镜像省掉了大部分环境搭建工作,换任务时也可以直接换一档卡。代价是要按时长付费,并且自己管好数据和实例的开关(后文会讲)。
盈亏点看持续利用率
公开的综合测算给出了一个参考区间:在硬件 2–3 年的生命周期内,持续利用率大约要达到 55%–65% 以上,自购托管分摊到每小时的成本才可能低于按需或预留的云算力。这个区间受电价、机柜价、采购价和租用单价的影响很大,只能作为方向参考,最终要用自己的数字来算。
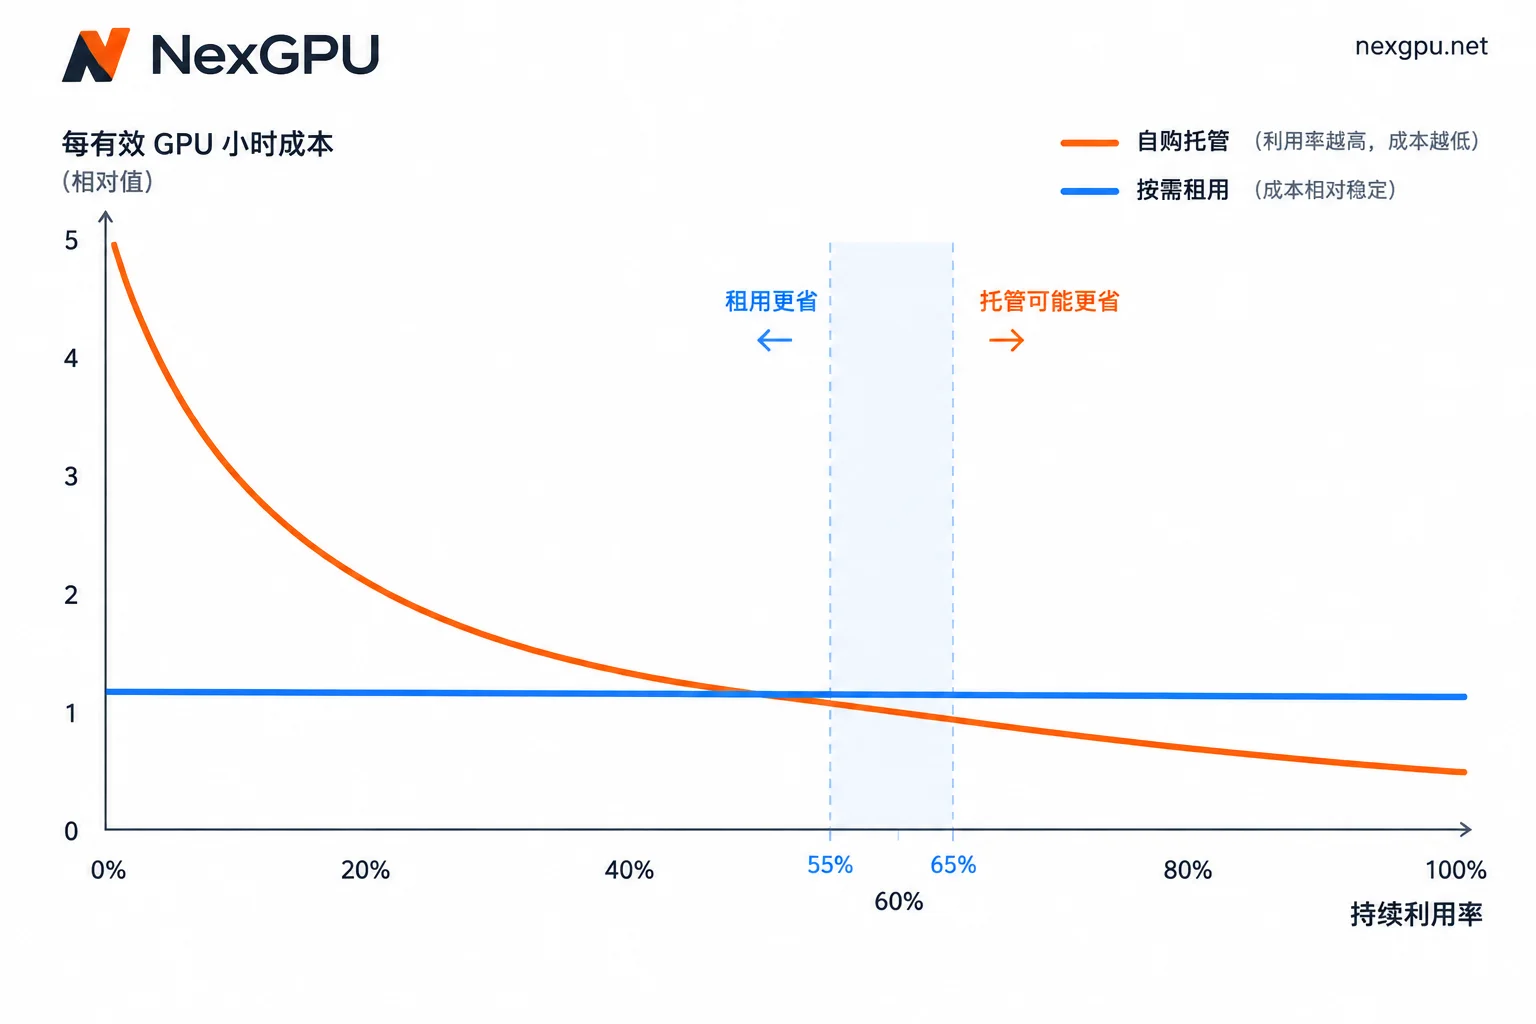
自己算可以分三步:
- 算托管的月总成本:硬件按 2–3 年折旧摊到每月,再加上机柜、电力、散热、带宽、维保费用和运维人力的分摊。
- 算每月有效 GPU 小时:只算真正在跑训练或推理的时间。开着但空转、等数据、调试环境的时间都不算。
- 两者相除,得到每有效 GPU 小时成本,再和同等级卡的租用单价比较。
第 2 步最关键。利用率从 80% 降到 40%,托管的有效单价就会翻一倍,因为固定成本一分都没少。租用则只在实例开着时收算力费。所以业务有明显起落、或者还在开发测试阶段时,托管往往算不过来。
如果你已经在比较按需和预留两种租法,可以接着看 竞价实例和预留 GPU 实例哪个更省钱。如果想把私有化部署也放进来一起比,可以参考 专有云与公有云 GPU 成本怎么比。
按场景怎么选
更适合租用的情况:
- 阶段性微调、探索性训练或做实验
- 推理流量有明显的高峰和低谷,或者刚上线、还不确定量级
- 还没确定最终用哪张卡,需要在消费级和数据中心级之间试
- 团队没有专职的硬件和机房运维人员
值得认真评估自购托管的情况:
- 7×24 小时的稳定推理服务,或长期不间断的训练任务
- 实测的持续利用率长期处于高位
- 模型架构和显存需求在两三年内比较固定
- 团队有能力管理机房合约、硬件故障和底层软件栈
动手前先确认两个硬条件:
- 数据合规:如果合规要求数据驻留在自己控制或指定的环境里,这一条会先于成本决定方向。
- 多卡互联:大规模训练对 NVLink、InfiniBand/RoCE 等互联方式有要求。无论自购还是租用,都要确认节点的实际拓扑,不能只看卡数。
两种方式也可以混用:稳定的基础负载放在自有或长期预留的资源上,突发的、实验性的部分按需租用。
拿不准时,先租一段时间测出利用率
多数团队拿不准,是因为不清楚自己真实的负载情况。成本最低的做法是先租卡跑真实任务,拿到数据后再决定要不要买。
- 用镜像直接搭环境。 以 NexGPU 为例,平台为 vLLM、TGI、Ollama、PyTorch、ComfyUI 等提供了镜像模板,可以一键部署,省掉配置驱动和 CUDA 的时间。
- 用真实负载跑几周,记录三项数据:每天实际的 GPU 占用时长、显存峰值、当前卡型是否合适。显存不够或者长期用不满,都说明卡选得不对。
- 管好费用边界。 NexGPU 的账单只有算力、存储、流量三项:停机后算力停止计费,但存储费照常计算,销毁实例后才全部停止计费。下单时的单价会一直锁定到销毁为止,没有最低消费,也不签合约。如果任务之间间隔较长,可以先把数据外移再销毁实例,做法见 租的 GPU 实例数据怎么保存。
- 把测得的利用率代入上面的三步算法。 同等级卡的租用单价可以在 NexGPU 价格页 查看。
算完之后,如果利用率长期偏低或波动很大,继续按需租用更省钱。如果负载稳定,又需要多卡或长期资源,可以先按 企业GPU集群和预留实例咨询清单 整理好卡型、卡数、使用周期和互联需求,再 联系 NexGPU 销售 洽谈多卡方案,拿到报价后与自购托管的总成本放在一起比较。



评论(0)