 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
咨询GPU集群或预留资源时,不要只报一个显卡型号和数量。先把这批卡要跑什么、卡之间要不要高速通信、数据怎么读写、要用多久、平均能用满多少写成一份清单,再通过企业对接入口提交。这样对方能直接判断有没有合适的节点、多久能交付、怎么计费,不用反复追问。
下面按实际顺序讲:先判断需不需要咨询,再整理清单,最后说明沟通时要问清哪些事。
先判断:你的需求需要人工对接吗
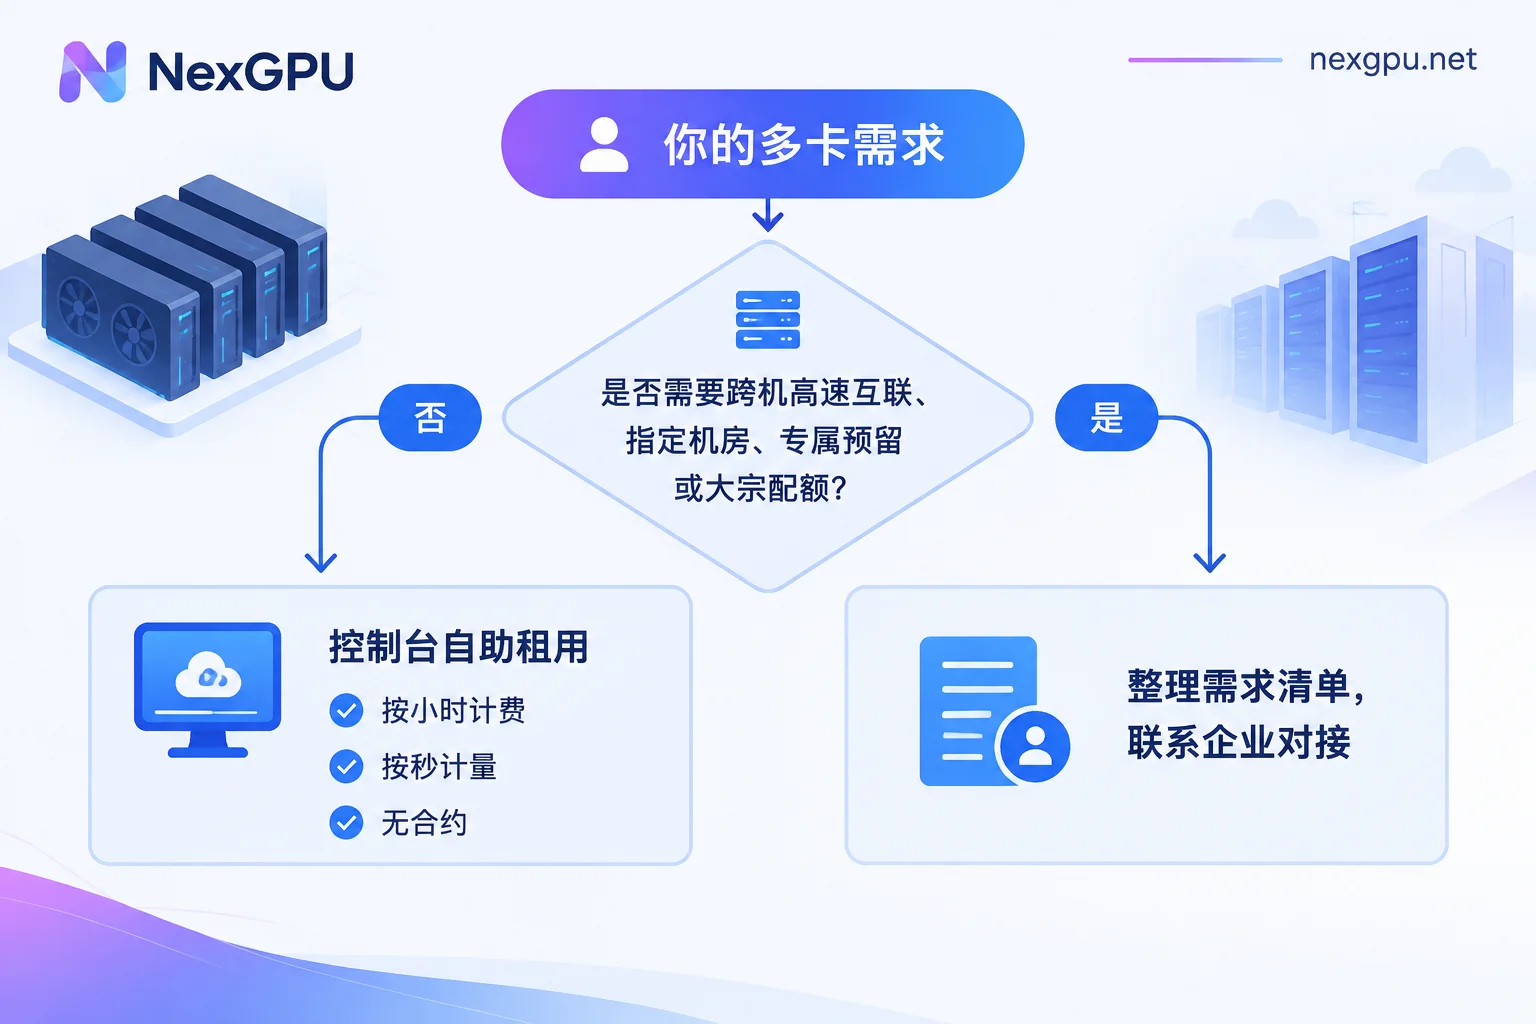
不是所有多卡需求都要找销售。在 NexGPU 上,单卡和普通多卡实例可以在控制台自助下单。它们按小时计费、按秒计量,没有最低消费,也不签合约,下单时单价锁定,到销毁为止不变。账单只有算力、存储、流量三项。
以下情况适合走人工对接:
- 跨节点的大规模集群:多台机器一起做分布式训练,对节点间网络有要求;
- 指定机房或地域:数据合规、访问延迟等原因,需要绑定某个位置;
- 专属预留资源:一段时间内要确定拿得到一批固定的卡;
- 大宗算力采购或批量配额:卡数多,或需要按排期分批交付。
如果只是想用两三张卡跑个微调,或者先验证方案是否可行,直接自助租用更快。还不确定单卡够不够用,可以先看消费级显卡什么时候不够用里的几个判断信号。
咨询前要整理的需求清单
1. 工作负载:跑什么,模型多大
先说清楚是大规模训练、批量微调还是持续推理,再补充模型参数规模、单卡显存的最低要求,以及计划用哪种并行策略(张量并行、数据并行或流水线并行)。
这几项决定了你需要的是单机多卡(Scale-Up),还是跨机集群(Scale-Out)。比如张量并行对卡间带宽很敏感,通常希望放在同一台机器里。纯数据并行的推理副本则可以分散在多台机器上。显存怎么估算、卡数怎么定,可以参考大模型训练GPU怎么选。
2. 互联:卡之间、机器之间要不要高速通信
这一项对价格和部署方式影响最大,建议写得具体一些:
- 多机分布式训练:要说明是否需要机内 NVLink,以及节点间是否需要 InfiniBand 或 RoCE 这类高速互联,并写出期望的带宽;
- 独立推理并发池:每个实例各自处理请求,不需要跨机通信,普通以太网节点通常就够用。
这两种情况的成本和架构差别很大。如果把推理池当成训练集群来提需求,可能会为用不上的互联多付钱。反过来,如果漏写了训练所需的互联,拿到节点后可能发现多机扩展效率很低。高速互联集群的起租卡数和现有机房分布,请在咨询时直接向对方确认。
3. 存储与数据:读多快、存多少、多久写一次
需要写明以下几项:
- 训练数据集大小,以及需要的读取吞吐;
- 检查点(Checkpoint)多久写一次,每次写入多大;
- 需要多大的存储卷,是否要在多个节点之间共享。
还要提前规划数据放在哪里。在 NexGPU 上,实例停机后仍然收取存储费,销毁后所有费用才会停止,但盘上的数据也会被清空。长期项目最好事先决定哪些数据保留在实例盘里,哪些迁出到别处,具体做法可以看租的GPU实例数据怎么保存。
4. 运行环境:用现成镜像还是自己的容器
说明你依赖的环境,比如 PyTorch、vLLM、TGI 等常见框架,还是需要使用企业自建的私有容器镜像。如果使用私有镜像,要一并写出 CUDA 和驱动版本的要求。现成模板能满足的部分,可以先在镜像模板页确认名称和版本,写进清单,这样对方评估时更准确。
5. 预留周期与利用率:负载是持续的还是突发的
预留资源通常建立在比较确定的长期用量上。提需求前,建议先估算两件事:
- 负载类型:如果是全天候跑满的恒定负载,比较适合固定预留;如果平时量小、偶尔有高峰,就要问清楚超出预留部分能否按需临时扩容,以及这部分怎么计费;
- 预期利用率:预留的卡大部分时间空闲,就等于为闲置资源付费。这种情况下,只预留基础量,把高峰部分交给按需租用,往往更合适。
6. 时间、规模与地域
写清楚计划的开始日期、使用时长、总卡数、是否分批上线,以及对机房位置有没有硬性要求。
一份可以直接改写的咨询模板
【用途】例:70B 级模型全参微调 / 在线推理服务
【模型与并行】参数规模、单卡显存最低要求、并行策略
【卡型与数量】期望卡型(可接受的替代卡型)、总卡数、单机卡数
【互联】是否需要 NVLink;是否需要跨机 IB/RoCE,期望带宽
【存储】数据集大小、读取吞吐、检查点频率与大小、是否需要共享存储
【环境】使用的模板(PyTorch/vLLM/TGI 等)或私有镜像,CUDA 版本
【周期与负载】开始日期、预留时长、恒定负载还是突发负载、预期利用率
【地域】是否需要指定机房或地域
【联系人】姓名、团队、方便沟通的时间
有几项写不准也没关系,写上“待定”或给一个范围,比空着好。对方看到范围,就能先给出几种方案。
沟通时要问清楚的几件事
提交需求后,建议逐项确认以下内容,并尽量拿到书面答复:
- 可用节点与交付周期:现在有没有符合要求的节点,多久能交付,能否分批交付;
- 互联是否符合描述:跨机网络的类型和带宽,交付后能否先跑通信测试再验收;
- 计费细则:预留部分怎么计价,超出部分怎么计价,存储和流量是否按常规口径单独计费;
- 商务条款:预付比例、提前终止和退款规则、续约方式。这些要以实际签署的商务协议为准;
- 支持方式:出现故障时找谁,响应渠道是什么。
等待回复时,可以先用小规模试跑
需求清单里最容易估错的是显存、吞吐和利用率。在等排期的这段时间,可以先自助租几张卡,用同样的镜像和一小部分数据跑一轮。实测显存占用、每秒处理量和检查点写入耗时,再把这些数字补进清单,后续估算会准确很多。自助实例按秒计量、没有合约,试跑结束后记得销毁,才能停止全部费用。当前有哪些卡型和节点可以用,可以在价格与可租节点页查看。
清单整理好后,通过多卡与企业方案页提交,也可以联系 Telegram 中英双语客服,由对方根据你的清单确认可用节点、交付周期和计费细则。



评论(0)