 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
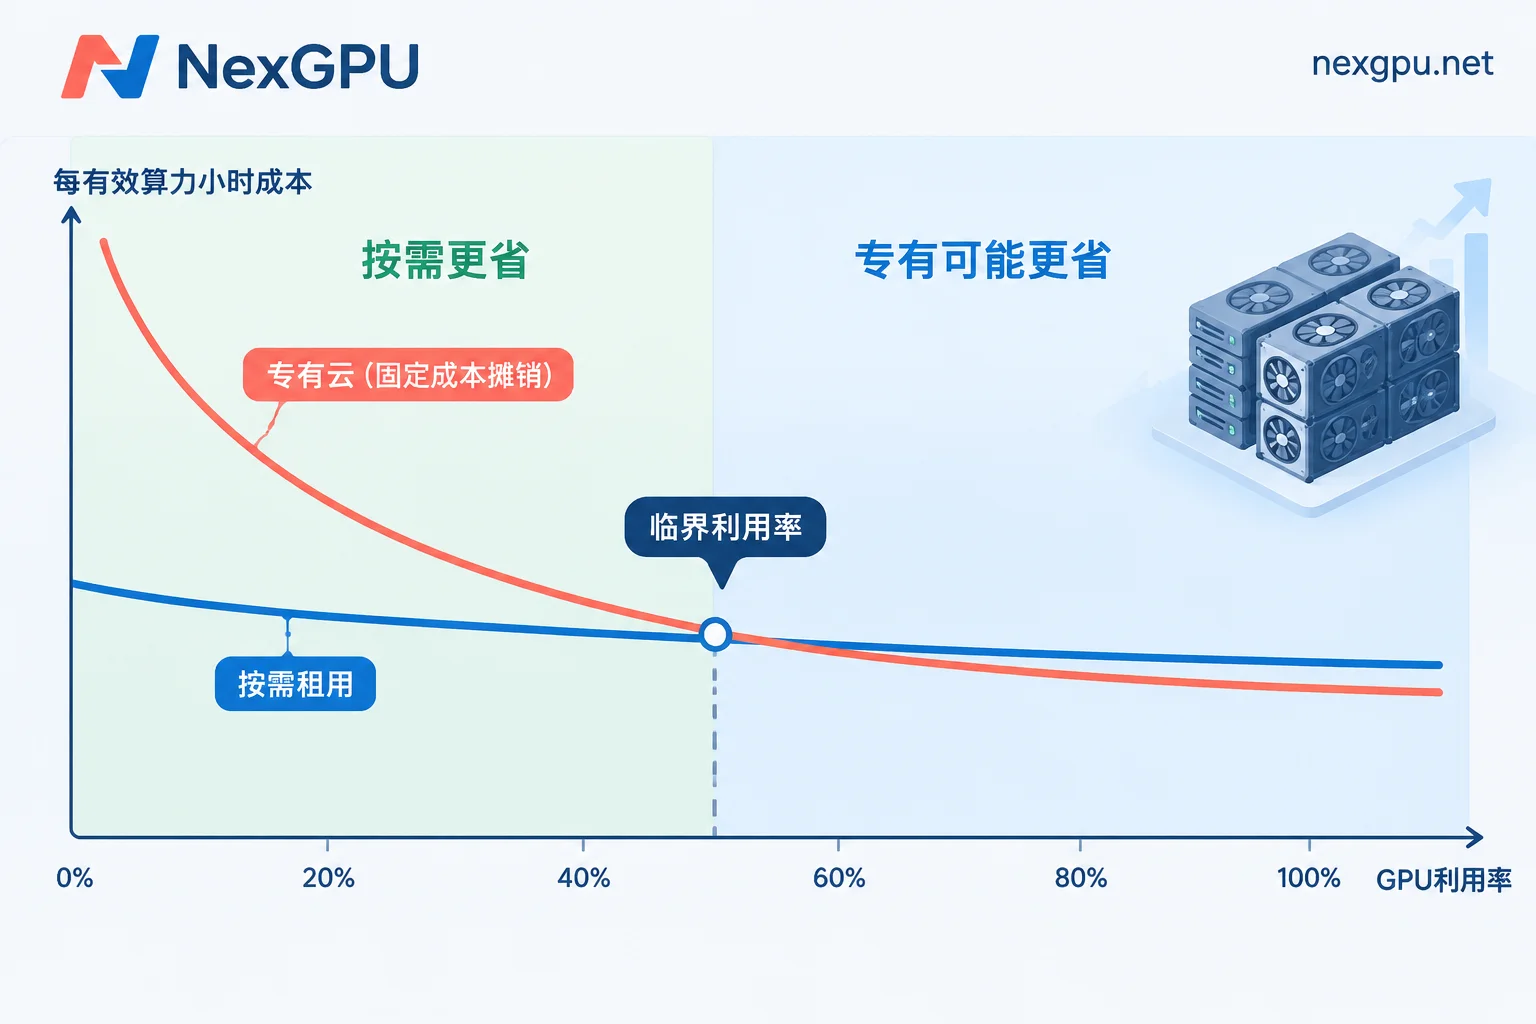
比较专有云(自建或长期独占的 GPU 集群)和按需租卡哪个更省,结论主要取决于一个变量:你的卡一年里有多少时间在真正跑任务。
行业里常见的 TCO 测算大致是这样的:
- 平均利用率低于 45%~50%,或者单卡每天有效运行不到 8~12 小时,按需租用的总成本通常明显更低。停机期间不计算力费,这一点在总账上占了大头。
- 生产推理或持续重训练的负载稳定在 70%~80% 以上,并且会持续一年以上,专有硬件摊到每小时的成本才有可能低于常规按需价格。
- 利用率落在两者之间的,结果更依赖具体参数。很多团队会用混合方式,把稳定的基线负载和波动部分分开处理。
这些区间是测算得出的经验范围,不同行业、机房和采购条件下临界点会有偏移。所以下面先拆清两边的钱分别花在哪,再用你自己的数据去套。
两边的钱花在哪里
专有云:大部分成本固定,不跑任务也在花
显性支出有 GPU 服务器的一次性采购(或者长期固定租约),以及配套的高速并行存储和网络交换设备。
隐性支出更容易被低估:
- 机房托管、电力和制冷能耗
- 冗余成本。为了可用性通常要按 N+1 配置,多出来的那台平时也在消耗
- 专职的硬件运维人力
- 折旧。设备一般按 3 年计算
这些费用的共同点是与你跑了多少任务基本无关。卡闲着的时候,折旧、托管和人力照样在走。
按需租用:成本随使用量变化,另有几项不能忽略
按需模式的显性支出主要是三块:运行时的算力费、挂载存储的费用、公网出方向的流量费。它不需要前期投入固定资产,也没有硬件贬值和技术淘汰的风险。任务结束后把实例销毁,费用就停了。
它的隐性成本集中在两处:
- 关机不等于停止计费。 以 NexGPU 为例,停机后算力费停止,存储费继续计,只有销毁才全部停止。长期挂着不用的实例和数据盘,会一点点拉高总账。
- 长期满负荷运行时,按小时累计的总额会很高,而且大量数据出网会带来额外的流量费。
用一个公式把两边放到同一把尺子上
单纯比较“买卡多少钱”和“租卡每小时多少钱”没有意义,应该统一换算成每个有效算力小时的成本:
- 专有云:一个折旧周期内的全部支出(硬件摊销+托管电力制冷+冗余+运维人力)÷ 这段时间里实际跑任务的小时数
- 按需租用:算力单价 +(存储费+流量费)÷ 实际跑任务的小时数
专有云的分子基本是固定的,所以利用率降一半,每有效小时的成本大约翻一倍。按需租用的算力单价不随利用率变化,只有存储和流量这部分会被摊薄或放大,曲线平缓很多。两条曲线的交点就是你的临界利用率。
先自测这四项数据
动手算之前,把下面几项数据准备好。缺了任何一项,TCO 的结论都会有偏差。
- 日均有效运行小时数。 统计 GPU 真正在跑训练、推理或批处理的时间,不算开着机等人调参的时间。可以直接拿最近一两个月的账单或监控数据来看。
- 峰谷比。 推理服务白天和夜间的请求量差多少,训练任务是持续跑还是集中在某几周。峰谷差越大,专有集群按峰值配置后闲置的比例就越高。
- 负载能稳定多久。 能确定持续一年以上的稳定负载,才有必要讨论 3 年折旧的问题。业务方向还没定下来的,就不适合做长期的硬件投入。
- 未来一两年的显存和互联需求。 大语言模型和多模态模型对显存容量、NVLink/InfiniBand 这类互联的要求变化很快。今天够用的配置,换一代模型可能就放不下,或者通信成了瓶颈。提前采购的专有硬件要承担这部分风险,按需租用则可以随模型切换显卡规格。
按业务阶段怎么选
探索验证期:在试模型、跑 demo、比较几种方案。这时利用率低而且不稳定,按小时计费、没有合约锁定的按需算力通常最划算。选卡时以当前模型的显存门槛为准,不需要为可能用不上的规格提前付费。
突发微调和批处理:一周或一个月集中跑一段,其余时间闲置。适合按需开实例,跑完先把结果和权重移出去,再销毁实例。只关机不销毁,存储费会一直计下去。具体做法可以参考租的 GPU 实例数据怎么保存。
中早期推理服务:流量在增长,但峰谷明显、规模还不确定。继续用按需实例,按实际并发扩缩更稳妥。等拿到几个月的真实负载曲线,再判断是否值得做长期投入。
稳定生产推理或持续重训练:负载长期在 70%~80% 以上并且会持续一年以上,这时值得认真测算专有方案,或者长期独占的方案。测算时要把前面列出的隐性成本全部计入,不要只拿硬件采购价去比。
已经有专有硬件的团队:可以把 P50 左右的基线稳态负载留在自有集群上,把突发波峰和实验性任务放到按需实例。这样自有集群的利用率能维持在较高水平,也不需要按峰值扩容。
算完之后的下一步
如果测算结果是按需租用更合适,可以先到 NexGPU 价格页 查看可租节点和对应单价,代入上面的公式。NexGPU 在下单时锁定单价,一直有效到销毁为止,账单只有算力、存储、流量三项,按这个口径做预算比较直接。运行一段时间后如果发现总账偏高,可以按算力、存储、流量三项逐条对账。
如果负载已经接近稳定的高利用率区间,或者需要多卡、集群这类规模,建议先整理好卡型、数量、预计运行时长和峰谷情况,参考企业 GPU 集群咨询的需求清单,再通过联系页和销售沟通具体方案。



评论(0)