 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先给结论
两张 L40S 凑在一起是 96GB 显存(单张 48GB),FP8 和 BF16 算力都高过单张 A100 80GB;代价是两张卡之间没有 NVLink,只能走 PCIe 4.0,单卡显存带宽 864 GB/s,大约只有 A100 HBM2e 的一半。所以能不能替代,取决于你的任务卡在哪一头:卡在算力和显存总量上,两张 L40S 更划算;卡在卡间通信和显存带宽上,替代不了。
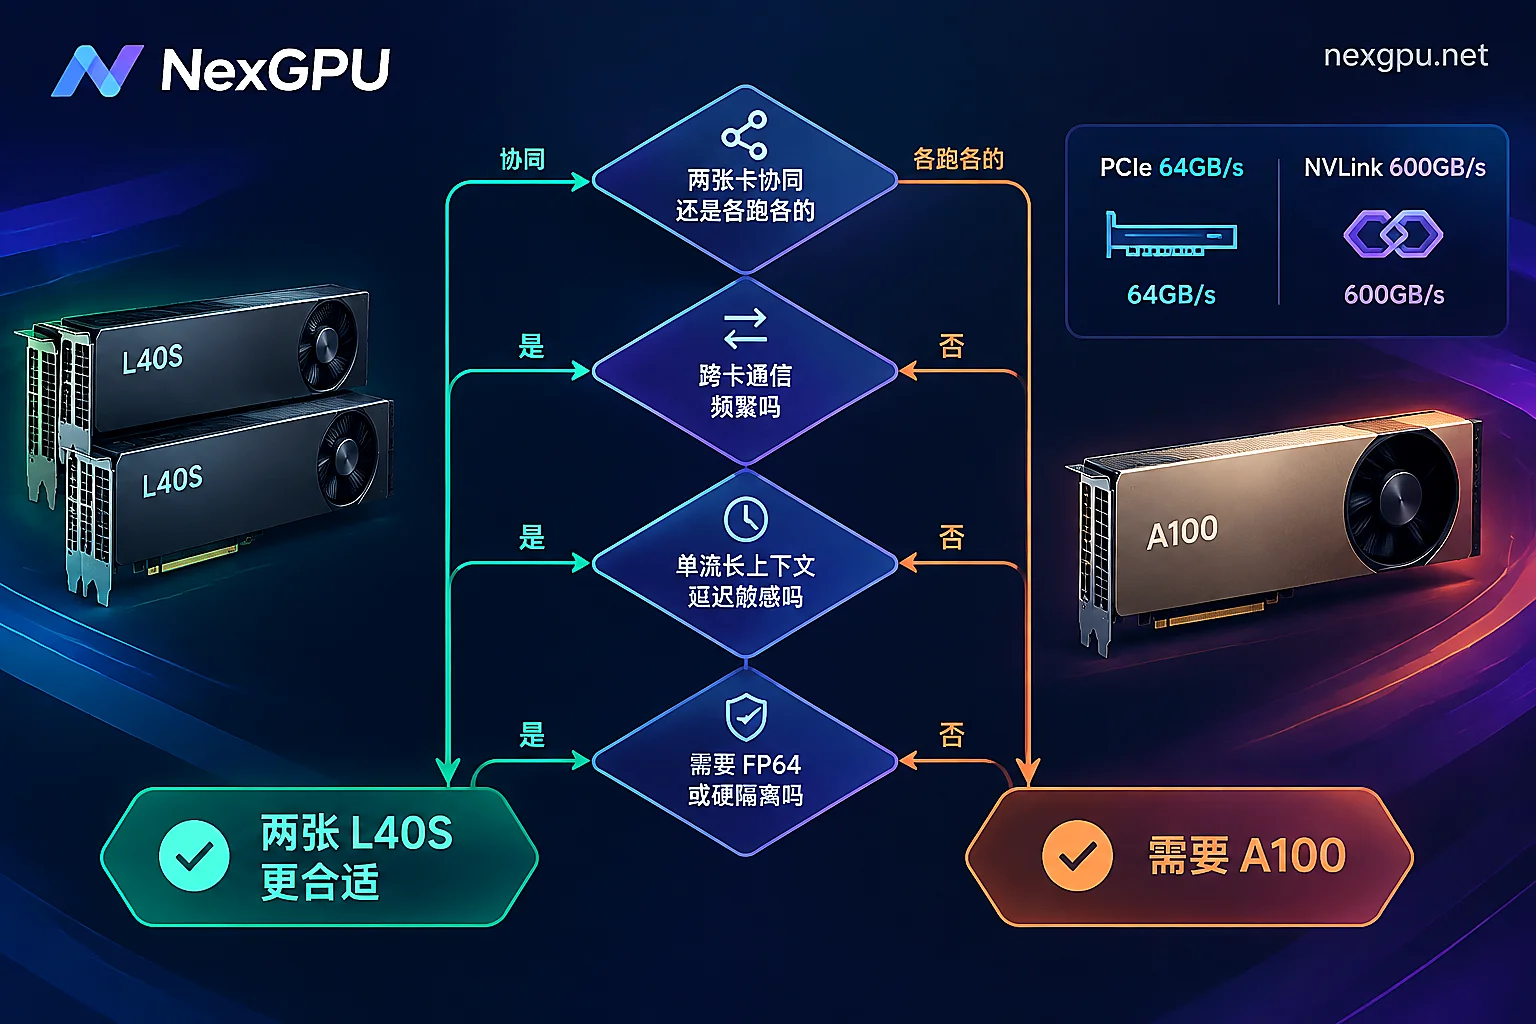
先问自己四个问题
- 两张卡是协同算同一份活儿(一个模型切两半),还是各跑各的任务?
- 如果要跨卡,通信频率有多高——是每个 batch 都要同步,还是只在开头把权重分一分?
- 是不是单请求、长上下文、对首字和出字延迟敏感的场景?
- 用不用得上 FP64,或者需要把一张卡切成几个互不干扰的实例?
第 1 问决定你要不要关心互联;第 2 问决定 PCIe 够不够;第 3 问决定显存带宽重不重要;第 4 问基本是一票否决。
这些场景可以替代,而且通常更划算
高并发、批处理推理。 用 vLLM、TGI 部署 70B 级别的模型并做 FP8 / INT8 量化时,权重加上 KV Cache 在 96GB 里相当宽裕,比 80GB 的单卡从容。批量上去以后(大致 Batch Size 8 以上),L40S 的 FP8 算力和 Transformer Engine 能把吞吐拉起来,摊到每百万 Token 的推算成本反而更占优。这是架构差异带来的:L40S 是 Ada Lovelace 加第 4 代 Tensor Core,原生支持 FP8;A100 是 Ampere 加第 3 代 Tensor Core,不支持 FP8。两者的推理取舍可以对照 L40S 和 A100 哪个适合推理。
多模态与生成式媒体。 L40S 保留了 RT Core,也带现代 NVENC / NVDEC 编解码引擎(含 AV1,单卡 3 组编解码器);A100 这两样都没有,视频活儿主要落到 CPU 软编上。跑 ComfyUI、Stable Diffusion、视频生成渲染、Whisper 转录时,两张 L40S 既可以各自独立服务,单卡本身也不吃亏。
轻量微调和「一拆二」。 LoRA、QLoRA 这类参数高效微调不需要密集的跨卡通信;把两张 L40S 拆成两个独立任务、每个任务独占 48GB,总显存池也比一张 A100 大。显存能装下多大的模型,可以参考 48GB 显存能跑多大的模型。
这些场景替代不了
依赖高频跨卡通信的分布式训练。 L40S 取消了 NVLink 接口,双卡只能走 PCIe 4.0 x16,双向理论带宽约 64 GB/s;A100 SXM 的 NVLink 3.0 是 600 GB/s,A100 PCIe 也能靠桥接做到双卡 600 GB/s。做张量并行(把一层切到两张卡上)或者全参数训练的梯度同步,PCIe 就会变成瓶颈。要注意基准版本:A100 PCIe 版和 SXM4 版本身的互联能力就不同,拿 PCIe 版作对比差距会小一些,但量级上仍是 PCIe 对 NVLink 的差距。相对而言,数据并行只要单卡放得下模型就问题不大,真正吃互联的是张量并行和流水并行。
低并发、长上下文的单流解码。 自回归解码是典型的显存带宽受限:每生成一个 Token 都要把权重读一遍。A100 的 HBM2 / HBM2e 带宽在 1,555~2,039 GB/s,L40S 的 GDDR6 是 864 GB/s,单请求的响应速度上单张 A100 仍然更快。如果你的服务就是少数人用、要求低延迟,双卡的算力优势换不来延迟优势。
FP64 科学计算与多租户硬切分。 A100 有完整的双精度单元(FP64 算力 9.7~19.5 TFLOPS),并支持 MIG,可以把一张卡物理切成最多 7 个互不干扰的实例;L40S 没有专门的 FP64 加速,也不支持 MIG。流体力学、分子模拟、量子化学这类仿真,以及需要硬隔离的多租户托管,两张 L40S 都不合适。
落到租用:几个会实际影响操作的点
- 两张卡就是两份算力时长。 计费只有算力、存储、流量三项,单价在下单时锁定、到销毁为止。跑双卡任务时别只按一张卡的时长估预算。
- 停机不等于不花钱。 停机后算力费停了,但存储仍按容量乘时长计费,只有销毁才全部停止。双卡任务中途去改代码、换镜像,记得这段存储费还在走。
- 能拆成两个独立任务就拆。 这样不需要任何跨卡配置,也不受 PCIe 带宽影响,镜像模板可一键部署(vLLM、TGI、Ollama、PyTorch、ComfyUI、Whisper 等)。
- 真要跨卡就选对并行方式。 跨卡适合做数据并行,或者干脆把两张卡的显存当两个池子用;指望靠 PCIe 跑张量并行,通常不如直接选互联更强的卡。
- 不确定选哪张,先按模型和场景查。 按模型选卡按显存门槛列了合适的卡型,实时单价可以自己按小时把整次任务的成本算一遍。
简单收一下:要吞吐、要多模态、要两个独立环境,两张 L40S 是更灵活也更省的那一边;要张量并行、要单流低延迟、要 FP64 或硬隔离,还是得有 A100 这类带 NVLink、HBM 和 MIG 的卡。



评论(0)