 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
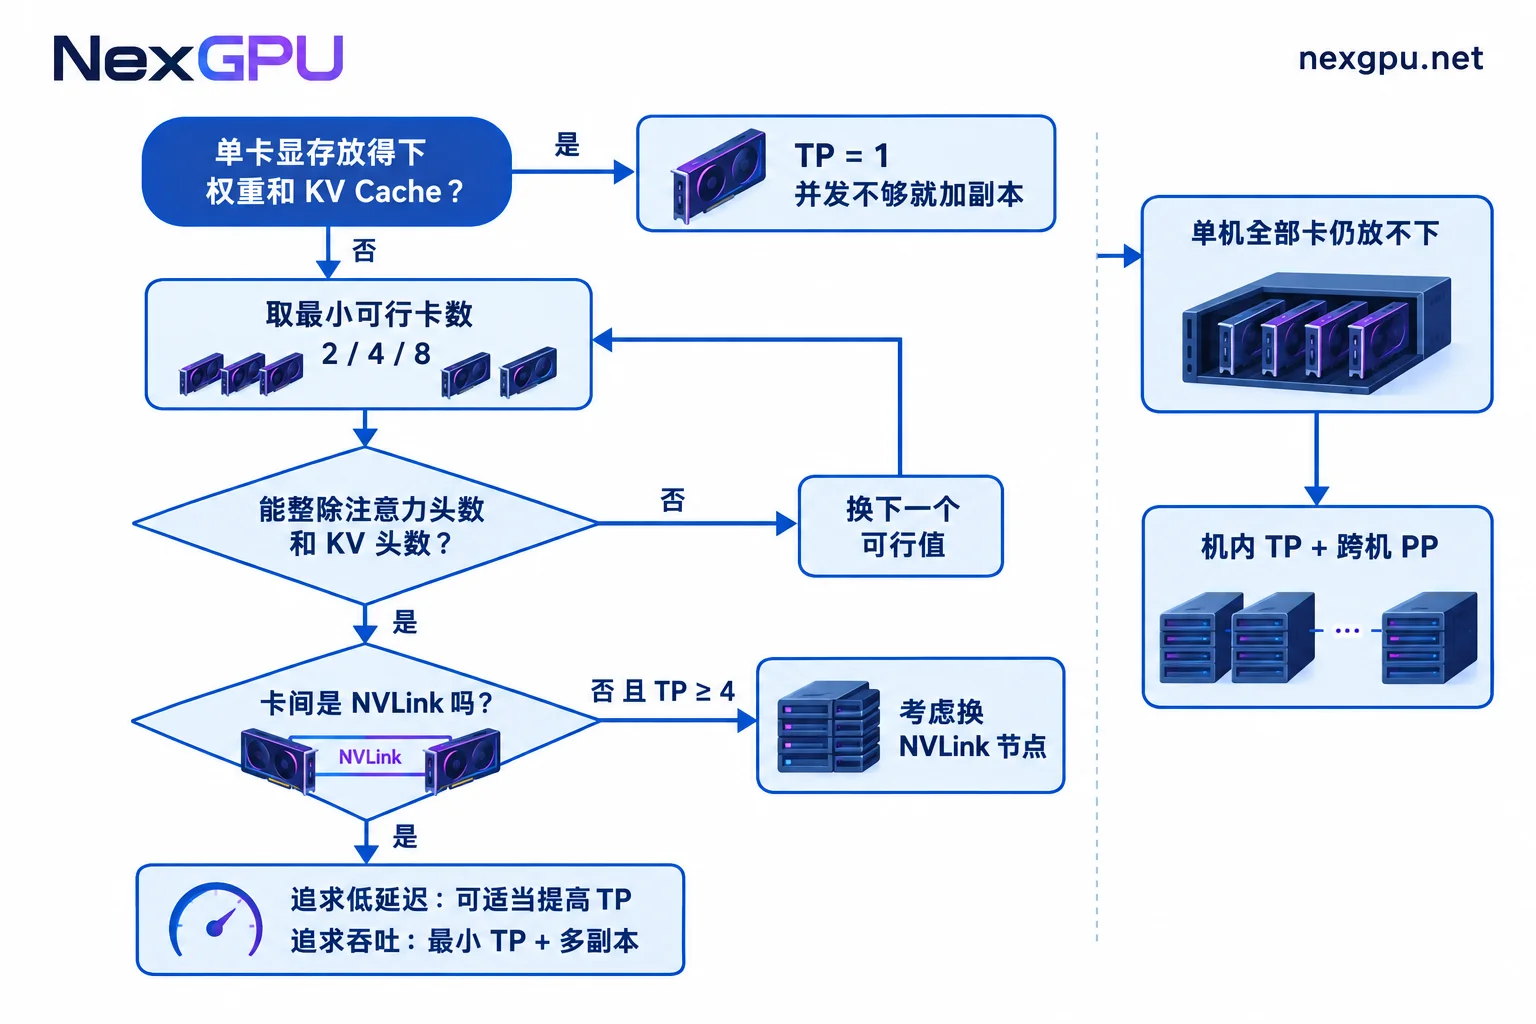
先说结论:推理并行度没有通用的“最佳值”,但有一个稳妥的定法:在显存够用的前提下,取最小的张量并行度(TP)。
- 单卡放得下模型权重,还能给 KV Cache 留足空间:设
TP = 1。 - 单卡放不下:取刚好够用的最小卡数,通常是 2、4 或 8,而且这个数必须能整除模型的注意力头数。
- 需要承接更多并发:优先多开几个副本做数据并行,不要把单个实例的 TP 一直往上加。
- 一台机器的所有卡加起来都放不下:这时才考虑“机内 TP + 跨机流水线并行(PP)”。
下面按实际定参数的顺序逐步展开。
为什么不是卡越多越快
张量并行把每一层的矩阵切到多张卡上一起计算,代价是每一层前向都要做一次跨卡通信(All-Reduce)并等待同步。如果模型本来一张卡就放得下,拆到多卡只会多出这部分通信开销。速度不会按卡数线性提升,延迟反而可能变高,吞吐也可能下降。
所以定 TP 的出发点是“模型装不装得下”,而不是“手上有几张卡”。
第一步:估算显存,得出最小卡数
显存里主要放三样东西:
- 模型权重:大致等于参数量乘以每个参数占的字节数。FP16/BF16 每个参数 2 字节,70B 模型的权重约 140GB。换成 FP8 大约减半,INT4 再减半左右。
- KV Cache:随上下文长度和同时处理的请求数增长。在长上下文、高并发的场景下,它可能和权重一样大,甚至更大。
- 运行时预留:框架本身、激活值等也要占用一部分显存。
把三者相加,再除以单卡显存,然后向上取到一个可行的 TP 值,这就是起点。TP 切分后,每张卡只承担一部分权重,省下的显存可以留给 KV Cache。这也是为什么有时把 TP 从 2 提到 4,就能支持更长的上下文。不过每加一档都会增加通信量,所以加到够用就停。
KV Cache 的具体算法,以及显存不够时先调什么,可以参考长上下文推理显存不够怎么办。如果不想自己估算某个模型的显存门槛,可以直接查 NexGPU 的模型选卡指南,里面按模型列出了建议租用的卡型。
第二步:确认 TP 能整除注意力头数
这是一条硬约束,不满足时框架初始化就会报错,服务起不来。TP 必须同时整除模型的 num_attention_heads 和 num_key_value_heads。使用分组查询注意力(GQA)的模型,KV 头数通常比注意力头数少很多,往往是它在卡住你。这两个值都写在模型目录的 config.json 里。
举个例子:某个模型只有 8 个 KV 头,TP 就只能取 1、2、4、8。即使手上有 6 张卡,也不能设 TP=6。可行的做法是用 4 张卡跑 TP=4,或者拆成 3 个 TP=2 的副本。
常见的 TP 值几乎都是 2 的幂,原因就在这里。
第三步:看卡之间怎么连
TP 的通信发生在每一层,频率很高,所以对卡间带宽非常敏感:
- 有 NVLink / NVSwitch 的机器(常见于数据中心级的 SXM 规格卡):TP=4、TP=8 都能正常发挥。
- 只有 PCIe 互联(消费级多卡、没有桥接的配置):TP=2 受到的影响相对较小;到 TP≥4 时,通信延迟会被明显放大,多加的卡带来的收益可能被抵消。
- 跨机器:TP 一般不要跨节点,因为节点之间的网络比机内互联慢得多。
想知道一台机器的互联拓扑,可以在机器上运行 nvidia-smi topo -m。输出中的 NV# 表示 NVLink 连接,PIX、PXB、PHB、SYS 等表示通过 PCIe 或经由 CPU 转发。在 NexGPU 租多卡节点时,建议下单前先到价格与可租节点页确认该节点的卡型和互联规格。如果模型在 PCIe 机器上需要 TP 大于 2 才放得下,换成带 NVLink 的节点通常比硬扛更合适。
第四步:按业务目标决定要不要继续调大
前三步满足之后,剩下的取舍取决于你更在意哪个指标。
更在意单个请求的速度(例如交互式对话,对首字延迟 TTFT 和逐字输出速度敏感):在有 NVLink 的节点上适当提高 TP,可以把多张卡的显存带宽叠加起来,缩短每个 token 的计算时间。例如 70B 模型在这类节点上用 TP=4 或 TP=8,单请求延迟会比最小配置更低。
更在意总吞吐(例如批量处理、多用户同时调用):用最小必要的 TP 启动一个实例,复制出多个副本,前面加一层负载均衡。比如 8 张卡跑一个 TP=2 就放得下的模型,启动 4 个 TP=2 的副本,总吞吐和单位成本通常都优于一个 TP=8 的实例,因为副本之间不需要互相通信。
两个指标都要兼顾时,先把延迟压到可接受的水平,再用副本数量去扩展并发能力。
另外,MoE 模型还可以使用专家并行,取舍思路和稠密模型不同,本文讨论的是稠密模型的情况。
什么时候才用流水线并行
流水线并行(PP)按层把模型切到不同设备上,请求要依次经过每一段。推理时会出现流水线气泡(部分设备空等),单个请求的端到端延迟会被拉长。所以单机能解决的问题,一般不用 PP。
PP 适合以下情况:一台机器的所有卡加起来仍然放不下模型(例如 405B 这个量级),或者必须跨节点部署、而节点之间又没有高速互联。常见做法是机内用 TP、节点之间用 PP,例如两台 8 卡机器组成 TP=8, PP=2。TP 和 PP 的详细对比可以看张量并行和流水并行怎么选。
落到启动参数上
在 vLLM 中,对应的参数如下:
# 单卡放得下
vllm serve <模型路径>

# 单机两卡张量并行
vllm serve <模型路径> --tensor-parallel-size 2

# 两台机器:机内 TP=8,跨机 PP=2(需要先按 vLLM 文档配好多节点集群)
vllm serve <模型路径> --tensor-parallel-size 8 --pipeline-parallel-size 2
TGI 中控制分片卡数的参数是 --num-shard,取值同样要遵守上面说的整除约束和互联限制。
设完之后怎么验证
参数是估算出来的,最终要以实测为准。建议用接近真实情况的请求长度和并发量,把选定配置和相邻的一档(比如 TP=2 和 TP=4,或者一个 TP=4 实例和两个 TP=2 副本)各跑一轮,对比三项指标:首字延迟、每秒输出 token 数、GPU 利用率。
如果加卡后吞吐没有明显上涨,可以先排查并行方式和互联,参考多卡推理为什么吞吐没有翻倍。如果 GPU 利用率始终上不去,可以按这五步定位瓶颈。
做这类对比测试时还要注意计费:在 NexGPU 上停机后仍会收取存储费,只有销毁实例才会全部停止计费。测试完不再使用的节点,记得及时销毁。


