 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
长上下文推理报 OOM,多数时候不是模型权重装不下,而是 KV Cache 随上下文长度和并发数一起增长,占满了显存。可以按这个顺序处理:先确认 OOM 出在哪一步,再估算 KV Cache 有多大,然后按改动代价从低到高依次尝试:限制长度和并发、把 KV Cache 量化成 FP8、开启分块 Prefill 和前缀缓存、把 KV Cache 卸载到 CPU 内存。这些都不够时,再考虑多卡张量并行、换更大显存的卡,或者换一个 KV Cache 更小的模型。
下面的参数以 vLLM 为例。SGLang、TGI、llama.cpp、Ollama 等工具也有类似能力,但参数名和支持程度不同,请以各自的文档为准。
第一步:看 OOM 出在哪个阶段
不同阶段的 OOM,解决方向不一样:
- 加载模型时就报错:权重本身装不下,和上下文长度无关。这时要换权重量化版本,或者用多卡、换更大显存的卡,下面那些 KV Cache 优化帮不上忙。
- 启动时提示 KV Cache 空间不足:vLLM 启动时会先按
--gpu-memory-utilization设定的比例扣掉权重,再用剩下的显存预分配 KV Cache。如果--max-model-len设的长度连一条完整序列都放不下,它会直接拒绝启动。这说明目标上下文超过了这张卡剩余的显存。 - 能启动,但长请求进来或并发升高时崩溃:常见原因有两个。一是 Prefill 阶段一次处理大量 token,激活显存出现峰值;二是用的工具不做分页管理,比如直接调用 Hugging Face Transformers 的
generate,显存碎片和预留浪费都比较严重。
第二步:估算 KV Cache 有多大
KV Cache 的大小可以直接算出来:
每个 token 的 KV Cache 字节数 = 2(K 和 V)× 层数 × KV 头数 × 每头维度 × 每个元素的字节数
总占用 = 每 token 字节数 × 上下文长度 × 同时处理的序列数
层数、KV 头数和每头维度都能在模型的 config.json 里找到。下面用两个常见结构算一下(BF16 精度,每个元素 2 字节):
- 8B 级模型(32 层、8 个 KV 头、每头 128 维):每个 token 约 128KB,一条 128K 上下文约 16GB。权重本身约 16GB,所以 24GB 显存的卡跑不了单条 128K。
- 70B 级模型(80 层、8 个 KV 头、每头 128 维):每个 token 约 320KB,一条 128K 上下文约 40GB。权重本身约 140GB。
这两个例子都用了 GQA(分组查询注意力),KV 头数远少于注意力头数。如果一个模型的 KV 头数和注意力头数相同,KV Cache 会成倍增加。另外,总占用和并发数成正比:同时跑 4 条 128K 请求,就要 4 倍空间。
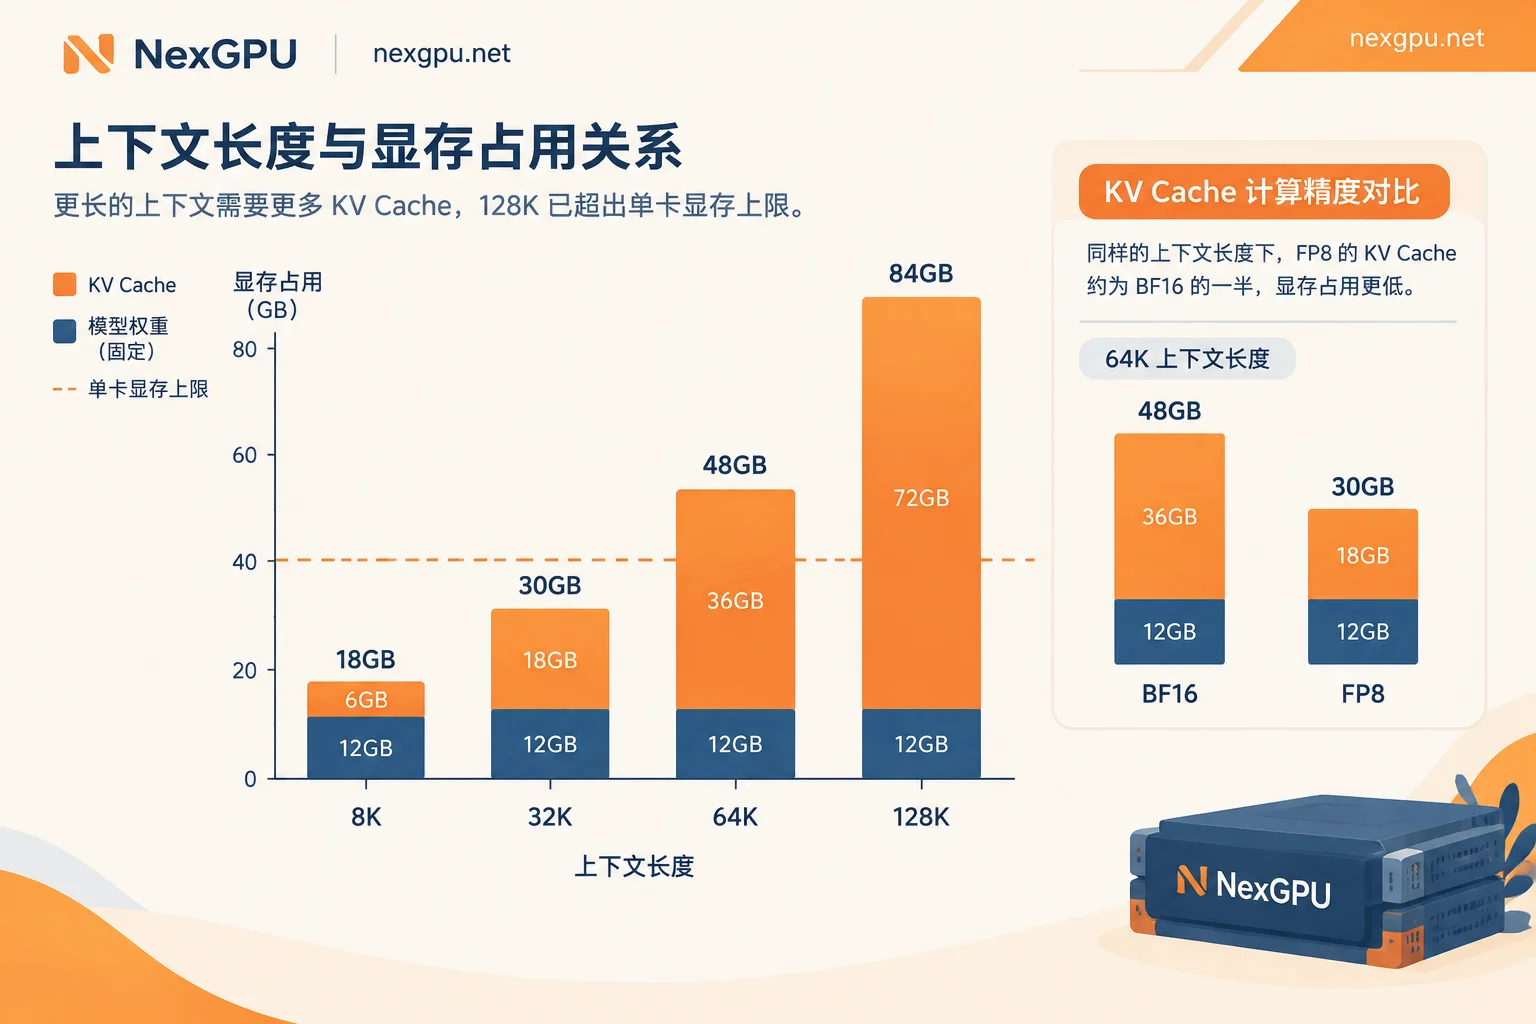
算完就知道差多少了:差一点,调参数就能解决;差好几倍,就要直接看后面的加卡或换卡方案。
第三步:不换卡能做的调整(按代价从低到高)
1. 把长度和并发设成真正需要的值
--max-model-len 不要直接拉满模型的标称长度。业务里最长的输入加输出是 32K,就设 32K 左右。--max-num-seqs 用来限制同时处理的序列数。KV Cache 和长度×并发成正比,这两个数减半,KV Cache 也大致减半。如果这张卡上没有别的进程,可以适当调高 --gpu-memory-utilization,但要留一些余量。
2. KV Cache 改用 FP8
在 vLLM 中加上 --kv-cache-dtype fp8(默认是 E4M3 格式),KV Cache 的显存占用比 FP16/BF16 减少约一半,同一张卡能放下的上下文长度或并发量大约翻倍。vLLM 的资料显示,这对长文本检索和生成的精度影响很小。不过这只是整体结论,上线前最好拿自己的任务抽样对比一下输出。在 Hopper、Ada Lovelace 等支持 FP8 的架构上,还可能顺带提升吞吐;其他架构上的表现以官方文档为准。
注意:AWQ、GPTQ 等权重量化省下的是权重那一部分,KV Cache 不会因此变小。两种量化可以同时使用。
3. 开启分块 Prefill,压低峰值
长上下文的 Prefill 阶段要一次处理几万甚至十几万个 token,激活显存会瞬间冲高。开启分块 Prefill(--enable-chunked-prefill)并用 --max-num-batched-tokens 限制每一步处理的 token 数,就能把这个峰值压平。较新版本的 vLLM 可能已经默认开启,可以在启动日志里确认。这个值也别设得太小,否则长请求的首字延迟会变长。首字延迟怎么调,可以参考大模型推理延迟高怎么优化。
4. 有重复长前缀时,开启前缀缓存
如果多个请求共用很长的系统提示词,或者反复针对同一份长文档提问,可以开启前缀缓存(--enable-prefix-caching,部分版本默认开启)。已经算好的 KV 块会被直接复用,既省显存又省计算。但如果每个请求都是一份全新的文档,前缀缓存几乎没有收益。它也不会降低单条超长请求本身的显存占用。
vLLM、SGLang 这类引擎自带的 PagedAttention 会把 KV Cache 切成固定大小的页来管理,避免碎片和预留浪费。如果你现在是直接用 Transformers 跑长上下文,先换成这类引擎,往往就能省出不少显存。
5. 把 KV Cache 卸载到 CPU 内存
显存确实装不下时,可以借助 vLLM 的 OffloadingConnector 等分级存储方案,把不活跃或溢出的 KV Cache 异步移到主机内存,甚至本地 NVMe。代价是跨设备传输会增加延迟,具体影响取决于主机内存大小和 PCIe 带宽。这种做法适合能接受延迟的离线批处理、长文档分析;对低延迟的交互式服务要慎用。租卡时要顺带确认实例的主机内存是否够用。具体配置写法各版本差异较大,以 vLLM 当前文档为准。
第四步:还不够,就加卡、换卡或换模型
- 换更大显存的单卡:如果算下来单卡大显存就能装下,这通常比多卡简单,不涉及卡间通信。不同显存档位能跑到多大的模型和多长的上下文,可以参考 48GB 显存能跑多大的模型。
- 多卡张量并行:设置
--tensor-parallel-size 2/4/8,把权重和 KV Cache 按注意力头分到多张卡上,相当于直接扩大总显存池。不过速度会受卡间互连影响,并行方式怎么选见张量并行和流水并行怎么选。 - 换 KV Cache 更小的模型:参数量相近的模型,采用 GQA 或 MLA 架构的,KV Cache 往往小得多。如果任务允许换模型,这可能是最省钱的办法。
在 NexGPU 上按这个顺序排查
先用镜像模板里的 vLLM 镜像起一台实例,把上面的参数从第 1 项开始逐项试。如果算完 KV Cache 发现单卡明显不够,可以到模型选卡指南看你的模型该用哪档显存或几张卡,再决定换卡还是上多卡。
调参期间按小时计费。暂时不用的实例可以停机,但停机后存储费照常收取;确认不再需要这台实例和上面的数据后再销毁,费用才会全部停止。


