只是一个默认分类

Meta入局智能体AI云GPU租赁实操

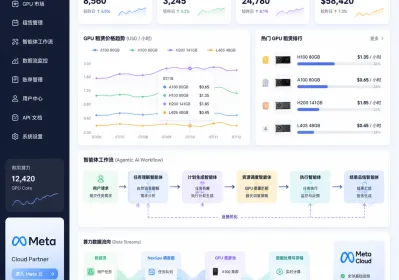
最近几周,云算力市场最热的动静,是Meta在推进自家“Meta Compute”计划。消息一出,相关股票波动明显。简单说,Meta打算把多余的AI算力拿出来对外提供,模式可能是托管模型访问,也可能是直接出租原始GPU资源。这不是空穴来风——公司CEO之前在股东大会上就提过类似想法,现在推进到了具体业务层面。Meta自己一边大规模自建、一边向外部租赁大量...
创业拿最新GPU:云端分成模式实操

最近算力圈动静不小。很多中小团队还在为最新GPU发愁:要么排队等几个月,要么价格高到试都不敢试。NVIDIA刚推的收入分成与信用支持模式,直接把这道坎降了一截。AI云提供商不用一次性掏满硬件成本,就能拿到大规模Grace Blackwell等集群,部署多租户AI工厂。云方卖服务,NVIDIA既拿标准产品收入,又分云端使用产生的收入。这结构让工厂能更快上...

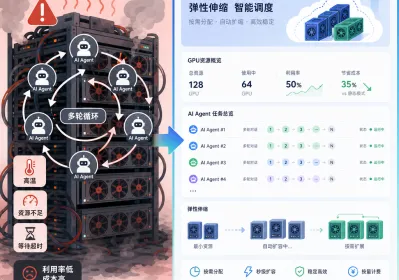
智能体多轮循环:云GPU弹性调度实操

智能体不是单次调用,GPU得常开最近几个月,做AI应用的团队明显感觉到变化。以前调大模型,发个prompt、收个回复就结束。现在智能体一上线,规划、调工具、检查结果、再循环,一个任务动不动就跑十几二十轮。行业分析显示,这类代理式工作流单任务token消耗往往是普通聊天的5到30倍,有些复杂编码或企业场景甚至更高。结果就是GPU不再是“用完就关”的资源,...

推理内存墙:云端GPU显存升级实操

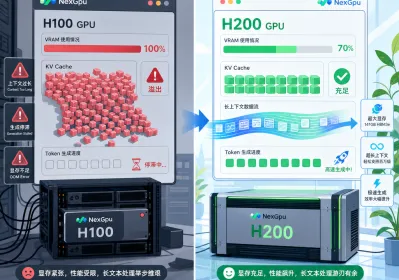
跑推理时你有没有碰到过这种事:模型权重明明塞得下,一开长上下文或多并发就OOM,或者token生成速度死活上不去?别急着加卡。现在越来越多一线反馈指向同一个点——推理尤其是decode阶段,真正卡脖子的不是FLOPS,而是显存容量和带宽。训练时GPU几乎满负荷算梯度,算力是主角。推理反过来。生成一个token,整模型权重得从HBM搬进计算单元,GPU核...

GPU闲置危机:云端弹性破解利用率困局

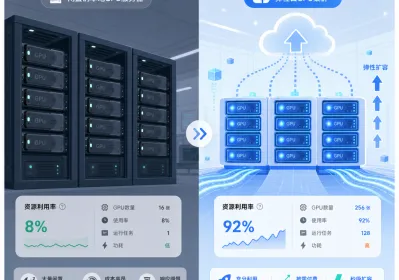
很多人盯着GPU买不到、交付周期拉长这事儿,却忽略了另一头更扎心的现实:已经到手的卡,大量时间在空转。行业数据显示,典型ML工作负载里GPU空闲时间常达60-80%,部分Kubernetes集群平均利用率甚至只有5%左右,相当于企业实际用着的算力只是采购量的零头。训练集群可能跑到95%饱和,推理侧却一天闲置30-60%。短缺和浪费同时存在,钱就这么悄悄...