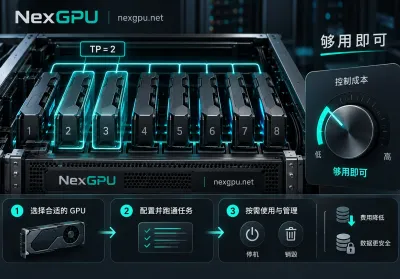
推理并行度设成多少合适?先按显存取最小 TP,再看互联和业务目标

先说结论:推理并行度没有通用的“最佳值”,但有一个稳妥的定法:在显存够用的前提下,取最小的张量并行度(TP)。单卡放得下模型权重,还能给 KV Cache 留足空间:设 TP = 1。单卡放不下:取刚好够用的最小卡数,通常是 2、4 或 8,而且这个数必须能整除模型的注意力头数。需要承接更多并发:优先多开几个副本做数据并行,不要把单个实例的 TP 一直...

多模态大模型GPU显存配置推荐:11B与90B各要几张卡

结论先行:多模态显存三档卡型怎么落位多模态大模型GPU显存配置推荐可以先记住三个落点:11B 级视觉模型至少 32GB 显存卡型(如 RTX 5090、L40S),单卡吃紧或高并发时上 80GB(如 A100 80GB),90B 级必须 8 卡 TP=8 张量并行。视觉模型上云后,显存规划比纯文本模型更容易失准,原因在于多出三笔增量开销。下面这份速查表...
Ollama私有云GPU服务器搭建怎么做?GPU直通6步

Ollama私有云GPU服务器搭建的完整路径就是 6 步:装 NVIDIA Container Toolkit、用 docker run 跑通 GPU 直通、写 Compose 固化配置、挂持久化卷保存权重、按卡做隔离、开 OpenAI 兼容接口——全程不需要分布式集群。2026 年 8 月的私有化部署实践已经把这条路径规范成了标准动作,单机单卡或多卡...

Qwen2.5-72B多卡量化部署教程:4步完成

Qwen2.5-72B多卡量化部署教程可以压缩成四步:按卡型倒推量化档位 → 定 tensor parallel size → 写启动参数 → 用自建对照集验证。开源主力模型在企业端加速落地,显存分账成为部署核心矛盾。动手前先打开终端执行 nvidia-smi,记下卡数、单卡显存与卡间互联方式。FP16 精度下 72B 权重加运行时开销大约需要 140...
Qwen部署要多少显存?72B/32B 双卡分账指南

Qwen部署要多少显存?结论先给:Qwen 2.5 72B 在 FP16 下仅权重就约 144GB~146GB,需双卡 80GB(TP=2);INT4 量化后约 38GB~40GB,可落到单卡 80GB/96GB 或双卡 32GB;32B FP16 权重约 63.5GB~64GB,需 80GB 级单卡或双卡,INT4 约 18GB。2026 年私有化部...