两张L40S能替代一张A100吗?按任务瓶颈分四类判断

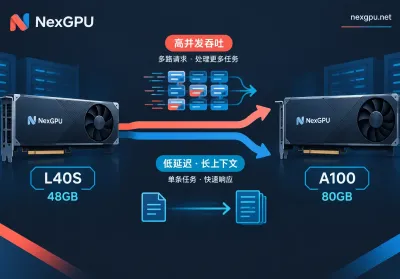
先给结论两张 L40S 凑在一起是 96GB 显存(单张 48GB),FP8 和 BF16 算力都高过单张 A100 80GB;代价是两张卡之间没有 NVLink,只能走 PCIe 4.0,单卡显存带宽 864 GB/s,大约只有 A100 HBM2e 的一半。所以能不能替代,取决于你的任务卡在哪一头:卡在算力和显存总量上,两张 L40S 更划算;卡在...

L40S 和 A100 哪个适合推理?按模型大小、并发和上下文长度来选

先说结论:单卡装得下、请求多、能用 FP8 的推理,优先选 L40S;单路对话要求快、上下文很长、模型大到必须多卡张量并行的,优先选 A100(尤其是 80GB SXM 版)。 如果说不清自己的任务属于哪一类,可以用同一个镜像在两张卡上各跑一轮同样的请求,这比反复对照参数表更可靠。下面按你手上要跑的任务逐项判断。先用三个问题对一下自己的任务模型多大,打...

L40S 与 A100 跑大模型推理,哪张卡的 Token 成本更低?按并发、上下文和精度来选

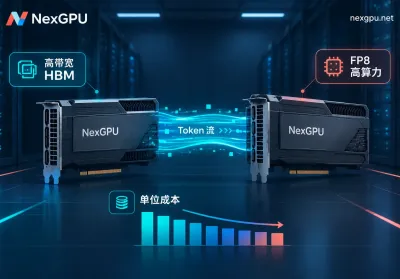
先说结论:请求并发高、模型能放进单卡(7B/13B,或 FP8 量化后的 30B 级),并且推理框架能开启 FP8 时,L40S 的每百万 Token 成本通常更低。并发低、要求逐字输出快、上下文很长,或者要把 70B 以上未量化模型切到多张卡上跑,A100 80GB 更合适,多卡时最好选 SXM 版本。两张卡的优势对应的是推理过程中的不同阶段。弄清楚...

A100租用做大模型推理的显存落位与成本折算口径

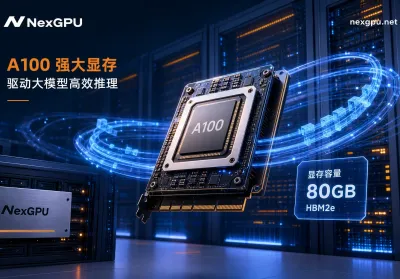
单张 A100 80GB 装不下 Llama 3 70B FP16 权重,必须跨卡;但经 4-bit 量化后,8 卡 A100 可承载 DeepSeek-R1 私有化推理。评估 A100租用 价值需区分“装得下”与“跑得动”,将显存空间与数据搬运速度分开核算。A100 80GB 的显存分账与带宽线单张 80GB 显存的可用空间并非全部用于存放权重,需拆...
RTX 4090多卡与A100单卡训练选型怎么定?4步判定

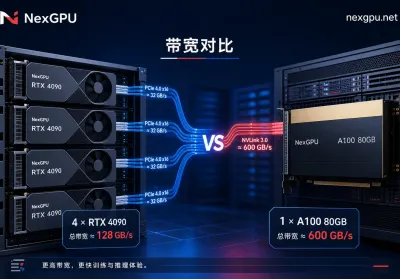
RTX 4090多卡与A100单卡训练选型的核心,不是比较显存总量,而是看你的任务是否受限于跨卡通信。根据NVIDIA官方数据手册,A100 80GB的NVLink带宽高达600 GB/s,而RTX 4090多卡受限于PCIe 4.0,跨卡通信需经系统内存中转,带宽仅约64 GB/s。因此,若任务需要频繁同步,堆4090可能不如一张A100。两个必须分...