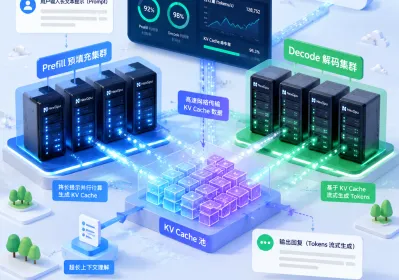
很多团队租了云GPU跑大模型推理,看着卡在那里却利用率上不去。看着监控,SM利用率常常只有二三十,甚至更低,钱却一分没少花。这不是卡不够强,而是推理本身的特性在作怪。推理分两段:prefill把长prompt或上下文一次性算完,生成KV cache;decode则一个token一个token往外吐。prefill偏计算密集,decode偏内存带宽。两者...
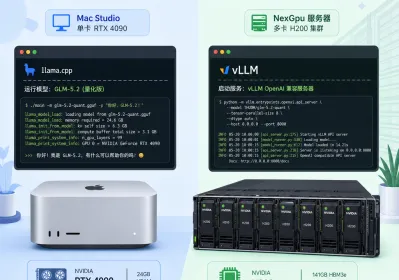
GLM-5.2 开源后,不少开发者直接上手本地跑。模型参数规模大,FP8 版本权重文件接近 744GB 到 890GB,完整加载需要 8 张 H200 显卡起步。单机调试或者小规模测试时,量化版本能把占用压到 200GB 左右,普通工作站或者 Mac Studio 也能勉强跑起来。先说 vLLM 方案。适合追求高并发场景。安装依赖后,用 hugging...
0 条留言
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客