 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
自部署 Llama 系列,真正卡住人的不是命令,而是三个判断:这个模型在你选的精度下要多少显存、单机单卡还是得切多卡、以及跑完之后账单从哪一刻停。把这三件事定下来,剩下的部署过程大概二十分钟就能跑通。
下面按你实际动手的顺序来。
先把显存账算完,再去挑卡
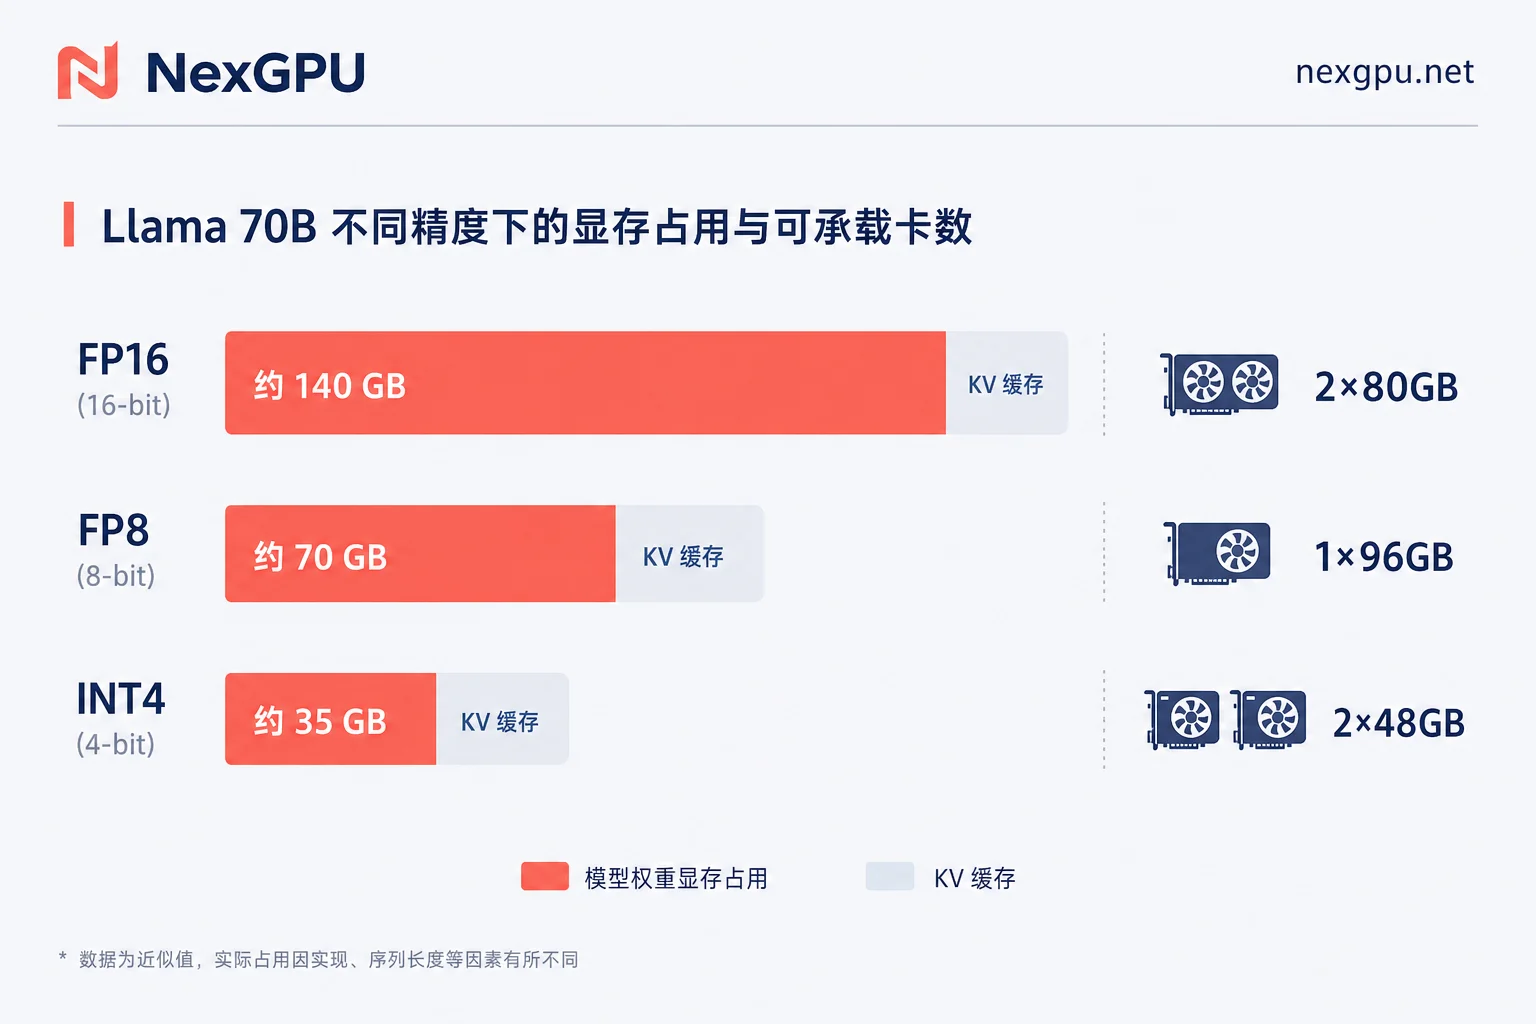
显存需求由两部分构成:权重占用 + KV 缓存。权重那部分可以直接估算,参数量 × 每参数字节数,FP16 是 2 字节,FP8 约 1 字节,INT4/AWQ 约 0.5 字节,再加 10%~20% 的框架开销和激活值。
按这个口径落到常见的两档:
- 8B 级别(Llama 3.1 8B 这类):FP16 权重约 16GB,加上 KV 缓存和开销,单卡至少要 16GB~24GB 可用显存才舒服。RTX 4090、A10G 这一档就够跑,24GB 卡能留出比较宽裕的 KV 空间做并发。
- 70B 级别(Llama 3.3 70B 这类):FP16 权重约 140GB 起步,单卡装不下,通常需要 2 张 80GB 的 A100/H100 做张量并行。如果转成 FP8 或 INT4/AWQ 量化版本,显存需求可以压到 40GB~80GB 区间,这时候 1 张 96GB 大显存卡能单卡承载,或者用 2 张 32GB/48GB 的卡切分。
量化不是免费的——INT4 在长上下文和复杂推理任务上会有可感知的质量损失,FP8 相对温和。如果你的下游是客服问答、摘要、结构化抽取这类任务,量化基本没问题;如果是代码生成或者多步推理,建议先用 FP8 试,别一步跳到 INT4。量化档位对显存的具体影响可以看FP8与INT4量化对GPU显存的影响。
还有一个容易漏的变量:上下文长度。Llama 3.1 支持到 128K 上下文,但 KV 缓存是随上下文长度和并发数线性增长的。8B 模型跑 128K 上下文的单条请求,KV 缓存本身就可能吃掉十几 GB。所以显存预算要按「你真实会用的上下文 × 你真实的并发」来算,而不是按模型卡片上的最大值。
算完这笔账再去挑机器。各个模型对应哪张卡更合适,官网的模型选卡页按模型列了显存门槛,不用自己再推一遍。
镜像:不要从裸系统开始装
vLLM 对 CUDA 版本、PyTorch 版本、驱动版本的匹配比较敏感,从空白 Ubuntu 开始装依赖,运气不好会在编译 flash-attention 或者版本冲突上耗掉一两个小时——而这段时间是按小时计费的。
直接选预装好的镜像模板更划算。镜像模板页里有 vLLM、TGI、Ollama、PyTorch 这些常用环境,开机就能用。具体预装的 vLLM 和 CUDA 构建版本以控制台里显示的为准,实例起来之后先跑一句 vllm --version 和 nvidia-smi 确认一下,比事后排查省事。
如果版本对不上你要的功能(比如某个新模型架构需要更新的 vLLM),在镜像基础上 pip install -U vllm 通常比从头装靠谱得多。
拉权重:Meta 官方仓库是受限的
Meta 官方的 Llama 权重在 Hugging Face 上是 gated repo,直接 clone 会 401。要走两步:
- 用你的 HF 账号在模型页面签署 Meta 的使用协议,等审批通过(通常很快,但不是即时)。
- 在实例上配置 Access Token:
export HUGGING_FACE_HUB_TOKEN=hf_xxxxxxxxxxxx如果你用的是社区量化版本(比如 AWQ/GPTQ 的第三方仓库),大多不受限,可以跳过这步,但要留意仓库的量化配置是否和你的 vLLM 版本兼容。
下载建议指定缓存目录到数据盘:
export HF_HOME=/workspace/hf_cache这一步很关键,后面讲费用时会再提——70B 的权重动辄一百多 GB,放在哪个盘直接决定你停机后每天还要付多少存储费。
单卡启动:一条命令起服务
vLLM 之所以是自部署的主流选择,核心在 PagedAttention 和连续批处理(continuous batching)。同样一张卡,原生 Hugging Face pipeline 在多并发下会因为 padding 和显存碎片浪费大量算力,vLLM 把 KV 缓存分页管理之后,吞吐量和显存利用率都高出一个量级。单人玩玩感觉不明显,一旦有并发请求,差距立刻出来。
8B 单卡启动:
vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --gpu-memory-utilization 0.90 \
  --max-model-len 8192
(老版本 vLLM 用 python -m vllm.entrypoints.openai.api_server --model ...,参数含义相同。)
两个参数值得单独说:
--gpu-memory-utilization:vLLM 允许占用的显存比例,默认 0.9。它决定权重之外留给 KV 缓存的空间。卡上没有其他进程时可以往 0.95 推,能装下更多并发;如果同一张卡上还跑着别的东西,往下调。--max-model-len:最大上下文长度。不设的话 vLLM 会按模型配置的最大值(比如 128K)去预留 KV 缓存,显存不够就直接启动失败。按你实际需要设,8K 或 16K 往往就够,省下的显存全变成并发能力。
启动日志里会打印一行类似 # GPU blocks: xxxx 的信息,那是分配到的 KV 缓存块数量,数字太小说明并发上不去,可以回头调上面两个参数。
多卡:张量并行怎么开
单卡装不下的时候(未量化的 70B 是典型),加一个参数就行:
vllm serve meta-llama/Llama-3.3-70B-Instruct \
  --tensor-parallel-size 2 \
  --host 0.0.0.0 --port 8000 \
  --gpu-memory-utilization 0.92 \
  --max-model-len 8192
--tensor-parallel-size N 会把每一层的权重横向切到 N 张卡上并行计算。几个前提别踩:
- N 张卡规格要一致,混插不同型号会按最小的那张卡的能力受限,甚至直接起不来。
- N 要能整除模型的注意力头数,所以实际可选值基本是 2、4、8,而不是任意数字。
- 张量并行每层都要做一次 all-reduce 通信,卡间互联带宽直接影响吞吐。同机 NVLink 的两张卡,比走 PCIe 的两张卡在 70B 上差别是能感觉到的。选多卡节点时留意这一点,具体到卡型之间的取舍可以参考大模型推理GPU怎么选。
如果模型层数多到单机也放不下,vLLM 还有流水线并行(--pipeline-parallel-size)配合使用,但 70B 这一档一般用不上,单机张量并行就够。
验证接口:它是 OpenAI 兼容的
服务起来后暴露的是标准 OpenAI 格式接口,这意味着 LangChain、LlamaIndex 或者任何写过 OpenAI SDK 的代码,改个 base_url 就能接。
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [{"role": "user", "content": "用一句话解释 PagedAttention"}]
  }'
注意 model 字段要填你启动时用的完整模型 ID,填错会返回 404。
关于外网访问:不同机房对公网端口的默认放行规则不一样,8000 端口不一定能直接从外面打通。最稳妥也最安全的做法是先用 SSH 隧道验证:
ssh -L 8000:localhost:8000 user@<实例IP> -p <端口>然后在本地访问 http://localhost:8000。确认服务没问题之后,再决定要不要在控制台开放端口或者加一层带鉴权的反向代理。裸暴露一个无鉴权的推理接口到公网,被人扫到白嫖算力是常见事故。
显存不够时的三个旋钮
启动报 OOM 或者 KV 缓存太小,按这个顺序调:
- 降
--max-model-len:最见效,且对模型质量零影响(只要不低于你的实际输入长度)。 - 调
--gpu-memory-utilization:如果是启动阶段就 OOM,说明这个值太高,权重加载时就爆了,往下调到 0.85 试试;如果是运行中偶发 OOM,反而可以往上调给 KV 更多空间。 - 换量化权重:从 FP16 换到 FP8 或 AWQ,权重占用直接减半甚至更多。
还调不通再考虑加卡。更系统的定位方法可以看GPU Out of Memory显存溢出解决方法。
vLLM 之外:什么时候用 Ollama
不是所有场景都需要 vLLM。如果你只是自己一个人试用模型、做原型验证、跑几十条数据的批处理,Ollama 上手更快,模型拉取和量化都帮你处理好了,一条 ollama run llama3.1 就能对话。
分界线大致是:要不要扛并发。单人交互、低频调用用 Ollama;要给应用提供稳定 API、有多个并发请求、在意每秒 token 吞吐,用 vLLM。想用 Ollama 起私有服务的话,Ollama私有云GPU服务器搭建里有完整流程。
费用边界:停机和销毁不是一回事
按小时计费的实例,账单只有三项:算力、存储、流量。跑通模型之后最该搞清楚的是这两个动作的区别:
- 停机(关机):算力计费暂停,但你的系统盘和数据盘还占着,存储费继续按天算。这对 Llama 部署尤其要注意——70B 的权重加缓存动辄一两百 GB,停一周不用,存储费是实打实在走的。
- 销毁(Destroy):实例和磁盘一起释放,三项计费全部停止。数据也一起没了。
所以决策很简单:明天还要接着用就停机,一周内不碰就销毁。销毁前把要留的东西(微调后的权重、配置文件、测试数据)传到对象存储或者本地,权重本身不用留——下次开机重新拉就行,拉取产生的是流量费,通常比养着一个大数据盘一整周便宜。
另外一点对长期项目有用:下单时的单价会锁定到实例销毁为止。如果你的服务要连续跑几周,开一台不销毁比反复开关更可控;反过来,如果只是间歇性跑批,销毁重开更省。
计费的完整口径在计费说明页,第一次租卡建议先看一眼再下单,避免出现「以为关机就不花钱了」的误会。
一条最短路径
如果你现在就要开始,顺序是这样的:
- 按精度算出显存需求 → 决定 8B 单卡还是 70B 双卡;
- 选 vLLM 预装镜像开机,别自己装环境;
- 配好
HUGGING_FACE_HUB_TOKEN和HF_HOME(指到数据盘); vllm serve起服务,务必显式设--max-model-len;- SSH 隧道验证接口,再考虑对外暴露;
- 用完当天就决定:停机还是销毁。
单卡这条路上面已经够用了。如果你要评估的是 70B 以上、多卡集群或者常驻推理服务的规模化方案,卡间互联和节点选型的影响会比框架参数大得多,可以直接联系销售聊具体配置。



评论(0)