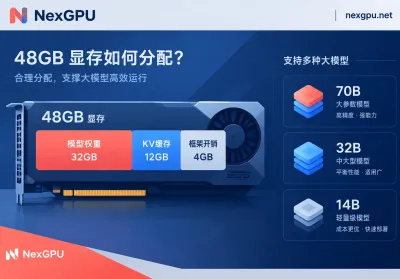
先说结论。48GB 显存单卡(RTX 6000 Ada、L40/L40S、A6000、A40 这一档)的能力边界如下。推理:最大能跑 70B 级模型的 4-bit 量化版,前提是单用户或小并发、上下文在 4K~8K 左右。想留出更多余量,可以选 32B/34B 的 8-bit 版,或 14B 的 FP16/BF16 原精度版。微调:极限是 70B 的 ...
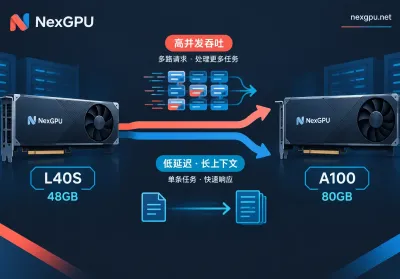
先说结论:单卡装得下、请求多、能用 FP8 的推理,优先选 L40S;单路对话要求快、上下文很长、模型大到必须多卡张量并行的,优先选 A100(尤其是 80GB SXM 版)。 如果说不清自己的任务属于哪一类,可以用同一个镜像在两张卡上各跑一轮同样的请求,这比反复对照参数表更可靠。下面按你手上要跑的任务逐项判断。先用三个问题对一下自己的任务模型多大,打...
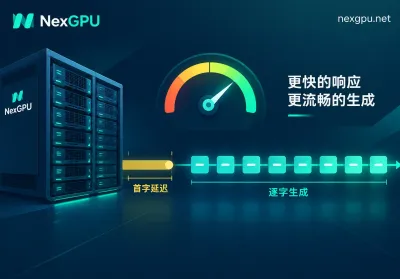
推理延迟高,先别急着换卡。建议先把延迟拆成两段:首字延迟(TTFT)和逐字延迟(TPOT,也叫 ITL)。首字慢通常出在预填充阶段,原因多是 prompt 太长,或者请求在排队。出字卡顿通常出在解码阶段,常见原因是显存带宽不够,或者正在生成的请求被新请求打断。这两类问题的瓶颈不同,处理方法也不同,搞错方向时调参往往没有效果。下面按排查顺序展开:先测,再...
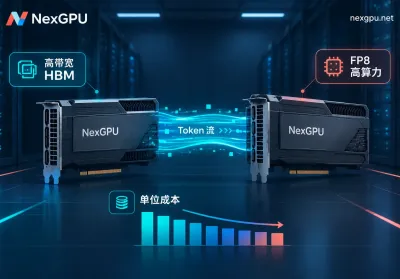
先说结论:请求并发高、模型能放进单卡(7B/13B,或 FP8 量化后的 30B 级),并且推理框架能开启 FP8 时,L40S 的每百万 Token 成本通常更低。并发低、要求逐字输出快、上下文很长,或者要把 70B 以上未量化模型切到多张卡上跑,A100 80GB 更合适,多卡时最好选 SXM 版本。两张卡的优势对应的是推理过程中的不同阶段。弄清楚...
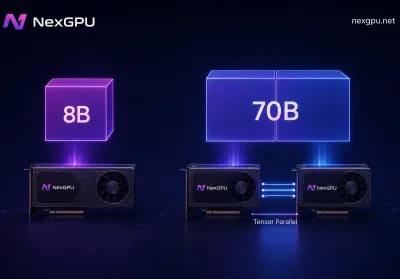
自部署 Llama 系列,真正卡住人的不是命令,而是三个判断:这个模型在你选的精度下要多少显存、单机单卡还是得切多卡、以及跑完之后账单从哪一刻停。把这三件事定下来,剩下的部署过程大概二十分钟就能跑通。下面按你实际动手的顺序来。先把显存账算完,再去挑卡显存需求由两部分构成:权重占用 + KV 缓存。权重那部分可以直接估算,参数量 × 每参数字节数,FP1...
0 条留言
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客