 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
为什么 FLUX.1 在 ComfyUI 里容易爆显存
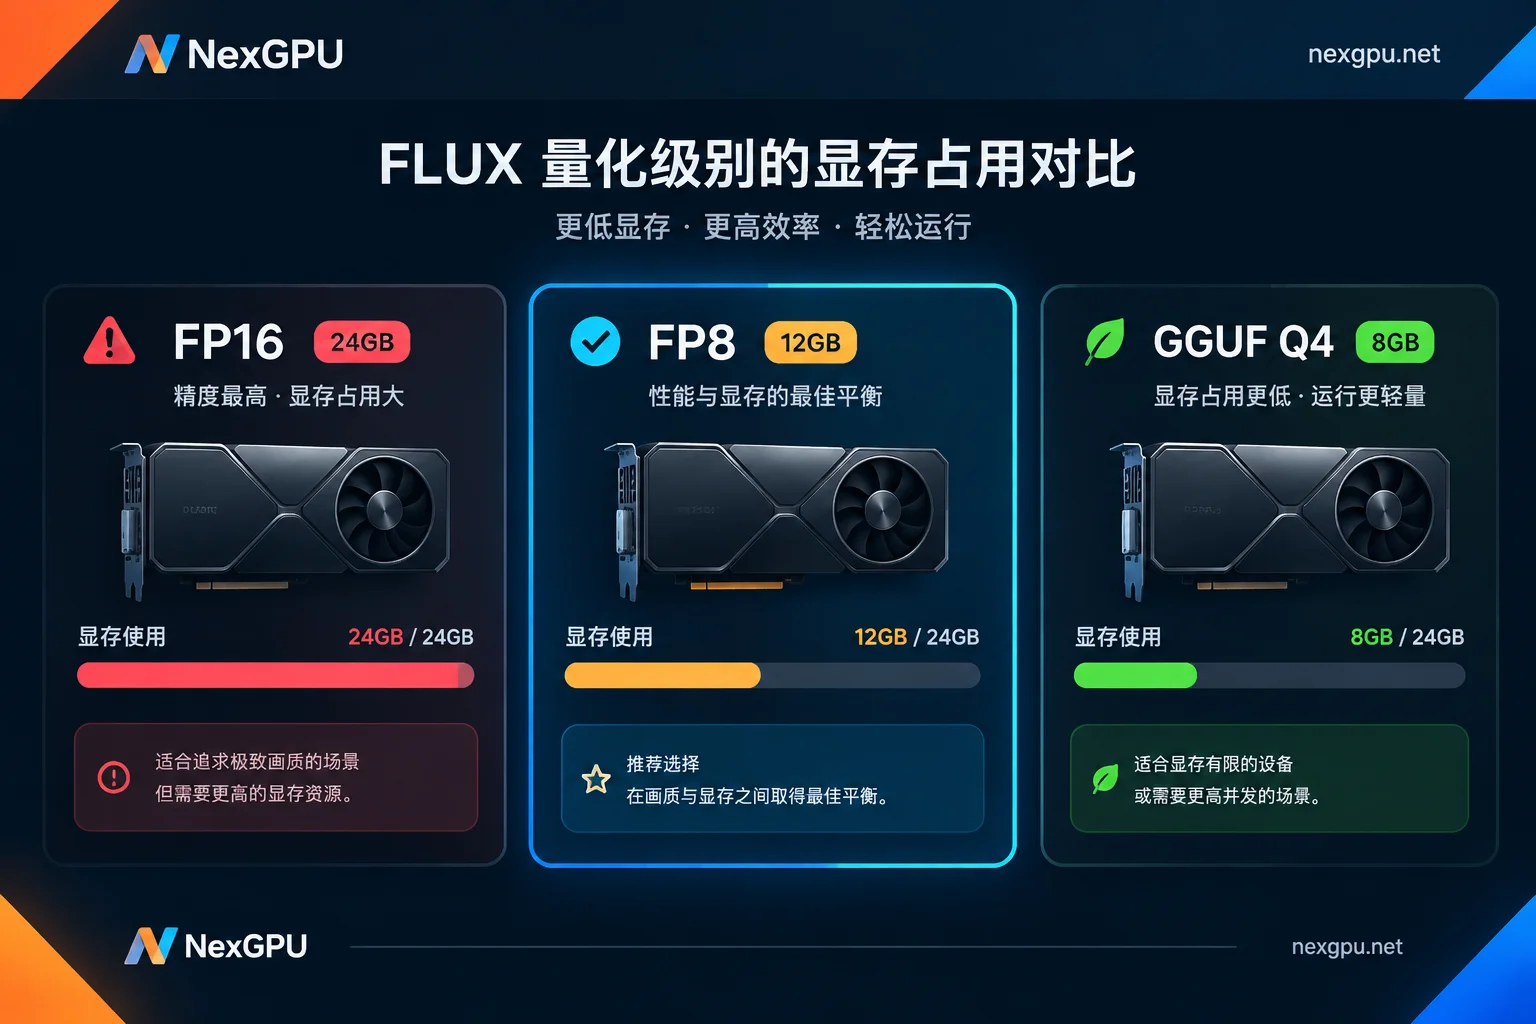
FLUX.1(dev 或 schnell)采用约 120 亿参数的 Diffusion Transformer 架构,全精度(FP16/BF16)权重文件本身就需约 24GB 显存。加载后还要同时运行体积接近 10GB 的 T5-XXL 文本编码器,以及在高分辨率解码阶段调用 VAE,峰值显存需求轻松超过 16GB 消费级显卡的天花板。
当 ComfyUI 提示 CUDA Out of Memory 或 RuntimeError: OutOfMemoryError,通常发生在三个阶段:模型加载时权重装不下、Conditioning 时文本编码器撑满显存、或者采样结束后 VAE Decode 瞬间溢出。
软件优化:把显存峰值压到 8~12GB
用官方 FP8 量化权重
最直接的降显存方案是换用 FP8 Checkpoint。FLUX 官方推荐显存有限的用户下载 FP8 单文件版权重,或者在 ComfyUI 的 "Load Diffusion Model" 节点中将 weight_dtype 设为 fp8_e4m3fn。这能把权重占用从 24GB 砍到约 11~12GB,画质损失极小,大多数场景下肉眼难辨。
替换轻量级 T5 编码器
默认的 t5xxl_fp16 文本编码器文件接近 10GB,在显存或系统内存低于 32GB 时会成为瓶颈。ComfyUI 官方建议改用 t5xxl_fp8_e4m3fn 或 scaled 版本,显著降低 Conditioning 阶段的显存压力。这两个文件通常放在 ComfyUI/models/clip/ 目录,在 DualCLIPLoader 节点中指定即可。
6~8GB 显卡:GGUF 或 NF4 极限量化
如果你的显卡只有 6GB 到 12GB(如 GTX 1660、RTX 3060),可以安装 ComfyUI-GGUF 插件,加载 FLUX GGUF 模型(如 Q4_K_S、Q5_K_M)与配套的 GGUF 版 T5 编码器;或者直接用 flux1-dev-bnb-nf4 版本。这类量化方案能把显存峰值压到 6~8GB 即可出图,但前提是你的主机物理内存(RAM)至少要有 32GB,用于层级卸载与缓存。速度会明显慢于全精度或 FP8,单张图可能从几秒拉长到几分钟。
启动参数:--lowvram 与内存调度
在 ComfyUI 启动脚本(如 run_nvidia_gpu.bat 或 python main.py)中添加 --lowvram 参数,强制在不需要执行文本编码或 VAE 时将其卸载到系统内存,减少 GPU 显存常驻峰值。配合 --reserve-vram 0.5(预留 0.5GB 余量)或 --disable-smart-memory(禁止激进缓存)可进一步防止突发 OOM。
示例:
python main.py --lowvram --reserve-vram 0.5Tiled VAE 避免解码崩溃
FLUX 生成 1024×1024 及以上分辨率图像时,往往在采样结束后的 VAE Decode 环节瞬间爆显存。在工作流中把标准 "VAE Decode" 节点换成 "VAE Decode (Tiled)",通过分块切片解码可大幅平抑峰值。tile_size 建议从 512 起试,显存越紧就调越小。
控制生成参数与清理缓存
- Batch Size 设为 1:避免单次执行多张图堆叠显存,改用队列排队运行。
- 手动清理缓存:切换模型或调优提示词前,在 ComfyUI 右键菜单点击 "Clean GPU Memory" 或卸载残留模型。
什么时候该租云端 24GB+ 显存算力
在 8GB~12GB 显卡上跑高量化版 FLUX,或强行依靠 --lowvram 频繁内存换页时,单张图耗时常从数秒拉长到数分钟。如果你要:
- 原版精度出图:FP16/BF16 权重 + 完整 T5 编码器,画质无损失;
- 秒级响应:批量生成或实时调优提示词,不想等内存换页;
- 复杂工作流:叠加 ControlNet、多个 LoRA 或更高分辨率(如 2048×2048),显存需求会进一步上涨;
这时更高效的方案是租用 24GB 显存以上的 GPU(如 RTX 4090 或数据中心级算力),按小时计费、按需开关机。NexGPU 提供消费级到数据中心级显卡,镜像模板一键部署 ComfyUI,停机只收存储费、销毁才全部停止。具体可租节点与单价可以在 价格页 查看,选好配置后单价锁定到销毁为止。
排查顺序小结
- 先换 FP8 权重 + FP8 版 T5:多数 12GB~16GB 显卡到这步就能跑通;
- 加 Tiled VAE:解决高分辨率解码崩溃;
- 加 --lowvram:进一步压低常驻峰值;
- 极限量化(GGUF/NF4):6~8GB 显卡的最后一道防线,需要 32GB+ RAM 配合;
- 权衡速度与成本:本地极限优化后仍慢得难以接受,或需要原版精度与复杂工作流,就该考虑云端 24GB+ 算力按需租用。
显存优化的边界是硬件物理上限,软件手段只能在质量、速度与显存之间做取舍。找到自己能接受的平衡点,才是最实用的方案。



评论(0)