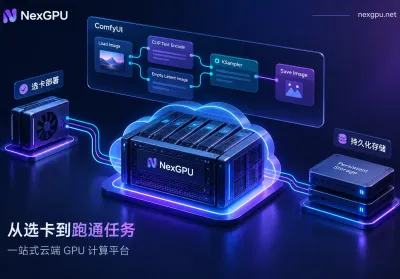
当你的 ComfyUI 工作流里开始串联 FLUX 全精度大模型、多层 ControlNet、IP-Adapter,或者切入 Wan 2.2、MiniMax H3 等长序列视频生成节点时,本地 8GB 到 12GB 显存的显卡几乎不可避免地会弹出 CUDA out of memory 报错。为了绕开硬件门槛,不少创作者和工作室将目光投向了云端。但在实际...
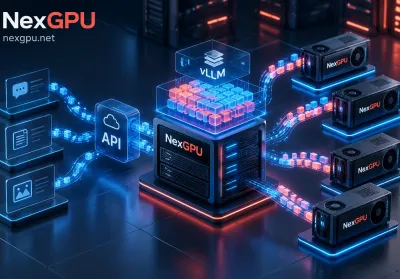
在本地开发大模型应用或验证原型时,很多开发者习惯用一条 ollama run 命令把模型跑起来。但当业务进入联调、内部知识库上线或接入 AI Agent 工作流时,单并发或低并发工具很快就会遇到吞吐瓶颈——多个请求同时打进来,排队时间飙升,甚至直接触发显存溢出(OOM)。从“个人能跑通”到“团队高并发可用”,vLLM部署几乎是所有工程团队绕不开的一步。...
2026 年的 AI 算力租赁市场正在经历一场明显的结构性迁移。如果说前两年的行业叙事完全被“万卡集群”和“千亿参数基座预训练”主导,那么近期密集披露的行业报告与财报数据则指向了另一个现实:AI 推理与智能体(Agent)应用的算力消耗占比已经正式超过 60%,成为算力需求增长的最大引擎。与此同时,大模型微调、AIGC 视频生成与 3D 渲染等高频应用...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客