在AI技术的演进浪潮中,我们常听到开发者面临这样的困境:从个人实验室的“一张显卡跑模型”到企业级的“大规模分布式训练与推理”,中间似乎隔着一道难以逾越的算力鸿沟。当你的AI业务从Prototype(原型)迈向Production(生产环境),单一消费级显卡已不足以支撑高并发请求与庞大的模型微调参数。此时,GPU集群的搭建不仅是硬件的堆叠,更是对弹性、效...
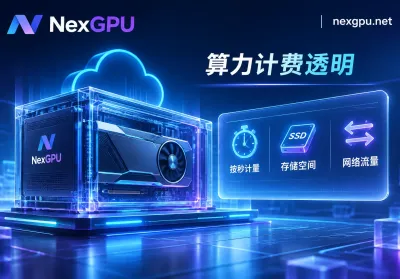
在评估GPU云服务器时,很多开发者和算力采购负责人都遇到过同一种困惑:明明下单前仔细对比过每小时的显卡单价,为什么到了月底结算或项目收尾时,实际支出的费用却比最初按“卡时单价 × 预计运行小时数”算出来的预算高出 20% 甚至 40%?进入 2026 年,这种“显卡单价看似便宜、综合账单却频频超支”的现象在行业内愈发明显。一方面,随着大模型微调、高并发...
在2026年的技术语境下,「GPU集群」已不再是巨头企业的专属。无论是专注于AI Agent开发的初创团队,还是需要处理大规模渲染任务的视觉工作室,当业务规模从单卡推理扩展到大模型训练、高性能微调或并行渲染时,如何构建一套具备弹性、高性价比且低门槛的GPU集群,成为了研发团队的“必修课”。为什么开发者都在转向弹性集群化?最近的行业热点显示,单纯追求单卡...
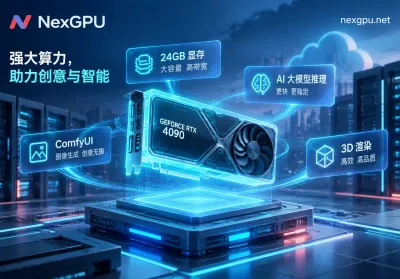
在 2026 年的 GPU 算力租赁市场中,尽管配备 32GB GDDR7 显存的 RTX 5090 以及数据中心级的 H200、B200 已经广泛上线,但拥有 16,384 个 CUDA 核心和 24GB GDDR6X 显存的 RTX 4090云服务器,依然是个人开发者、独立创作者与中小 AI 团队使用频率最高的“主力甜点卡”。原因很简单:Ada L...
在本地开发大模型应用或验证原型时,很多开发者习惯用一条 ollama run 命令把模型跑起来。但当业务进入联调、内部知识库上线或接入 AI Agent 工作流时,单并发或低并发工具很快就会遇到吞吐瓶颈——多个请求同时打进来,排队时间飙升,甚至直接触发显存溢出(OOM)。从“个人能跑通”到“团队高并发可用”,vLLM部署几乎是所有工程团队绕不开的一步。...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客