 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在 2026 年的 GPU 算力租赁市场中,尽管配备 32GB GDDR7 显存的 RTX 5090 以及数据中心级的 H200、B200 已经广泛上线,但拥有 16,384 个 CUDA 核心和 24GB GDDR6X 显存的 RTX 4090云服务器,依然是个人开发者、独立创作者与中小 AI 团队使用频率最高的“主力甜点卡”。
原因很简单:Ada Lovelace 架构的软件生态极其成熟,各大开源框架(从 vLLM、Unsloth 到 ComfyUI)对它的底层优化已经榨干到极致;而在单卡租金上,RTX 4090 相较新一代旗舰有着明显的价格优势。如果你的工作负载恰好落在 24GB 显存的安全线以内,租用 RTX 4090 往往能跑出最高的投入产出比。
不过,当前市场上 RTX 4090 租赁服务良莠不齐,部分平台存在虚标低价、收起租门槛费或隐藏存储网络附加费的情况。本文将从工程实操角度出发,帮你算清 24GB 显存的能力边界、避开计费陷阱,并结合 NexGPU 的平台机制,梳理一套从单卡验证到多卡扩容的标准操作流。
一、24GB 显存的能力边界:哪些任务租 RTX 4090 最划算?
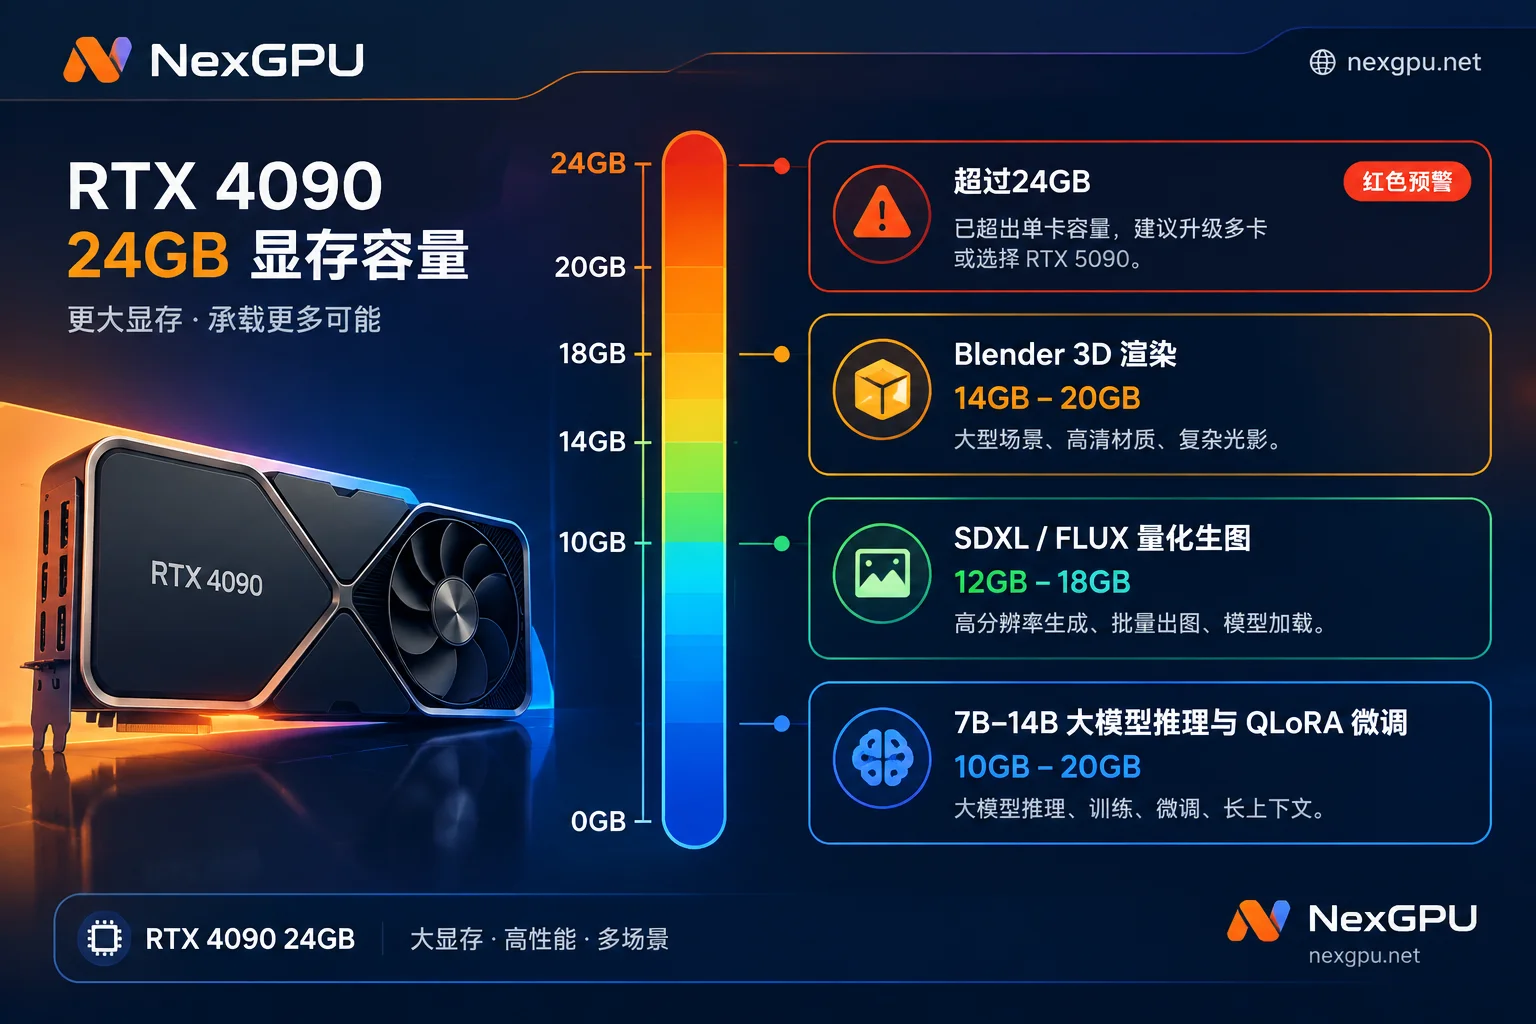
选卡的第一原则是“按显存定卡,按带宽看吞吐”。RTX 4090 拥有 24GB 显存和约 1.01 TB/s 的显存带宽,这决定了它在以下四大高频场景中的精准定位:
1. AI 图像与视频生成(ComfyUI / WebUI)
- 舒适区:运行 SD 1.5、SDXL 全精度模型,或加载量化版(FP8/NF4)的 FLUX.1 模型并挂载多个 ControlNet 与 LoRA 节点。24GB 显存足以应对绝大多数高分辨率重绘(Hires.fix)与常规批量出图需求。
- 边界点:在跑全精度 FLUX 微调,或处理长帧数、高分辨率的开源视频生成模型时,显存占用极易突破 22GB 触发 OOM(显存溢出)。此时需开启模型卸载(Offload)策略,这关于具体的节点管理与成本控制,可以参考我们的《ComfyUI云GPU环境搭建与成本控制实操指南》。
2. 大模型推理(vLLM / Ollama / SGLang)
- 舒适区:部署 7B、8B、14B 参数量的开源模型(如 Qwen、Llama、DeepSeek 蒸馏版)的 FP16 全精度或 INT8/INT4 量化版本,同时还能留出充裕的显存空间给 KV Cache,支撑中等并发与较长的上下文窗口。
- 边界点:单卡 24GB 无法装下 32B 模型的半精度权重,即便是 4-bit 量化(权重占约 18GB~20GB),留给激活值和 KV Cache 的空间也极为局促。若要跑 32B 或 70B 级别的模型推理,建议直接在 NexGPU 模型选卡指南 中查阅对应模型的量化显存门槛,改用双卡/四卡 4090 做张量并行(TP),关于生产环境的部署细节可延伸阅读《vLLM部署实战指南》。
3. 模型微调(LLaMA Factory / Unsloth)
- 舒适区:使用 QLoRA(4-bit 量化微调)对 7B~14B 模型进行指令微调,或者训练 SDXL / FLUX 的人物与画风 LoRA。配合 Unsloth 等显存优化框架,单张 RTX 4090 的训练速度非常可观。
- 边界点:14B 以上模型的 LoRA 微调,或者 7B 模型的全参数微调(Full Fine-tuning)。由于优化器状态和梯度会成倍放大显存需求,单卡 24GB 会迅速见底,具体测算方法详见《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》。
4. 3D 图形渲染与音视频处理(Blender / Whisper)
- 舒适区:Blender Cycles 或 V-Ray 的中小体量工程渲染,以及 WhisperX / faster-whisper 的大批量高并发语音转写。RTX 4090 的第三代 RT Core 在光线追踪渲染中极具性价比;遇到赶工期的大型动画序列,还可以同时开启多台 RTX 4090 实例做分段并行渲染,具体拆帧技巧见《GPU云渲染怎么选方案和显卡》。
二、单卡 4090 vs 多卡 4090 vs RTX 5090:代际与集群选型对比
当单张 RTX 4090 接近性能瓶颈时,你通常面临两个升级方向:横向叠加 RTX 4090 卡数(如租用 2 卡、4 卡、8 卡整机),或者纵向升级到单卡 32GB 的 RTX 5090 及数据中心卡(A100/H100)。
在 2026 年的算力市场中,多卡 4090 集群的租用需求增长迅速。我们可以通过下表直观对比不同方案的取舍:
| 选型维度 | 单卡 RTX 4090 (24GB) | 多卡 RTX 4090 节点 (2x/4x/8x) | 单卡 RTX 5090 (32GB) | 数据中心卡 (A100/H100 80GB) |
|---|---|---|---|---|
| 可用总显存 | 24GB GDDR6X | 48GB / 96GB / 192GB | 32GB GDDR7 | 80GB HBM2e / HBM3 |
| 核心优势 | 单卡租金低,随开随用负担小 | 显存池成倍扩大,单位显存成本极低 | 单卡装下 32B 量化模型,无需跨卡通信 | 超高显存带宽与互联,适合重度分布式任务 |
| 典型适用场景 | 个人日常开发、7B-14B 微调/推理、SDXL/FLUX 生图 | 32B/70B 模型张量并行推理、DeepSpeed/FSDP 多卡微调 | 24GB 刚刚溢出的任务(如全精度视频生成、32B 单卡推理) | 70B+ 大模型预训练/全量微调、高并发长上下文生产推理 |
| 选型注意事项 | 超过 24GB 任务无法强跑 | 需关注 PCIe 带宽与跨卡通信开销 | 算力单价高于 4090,按需评估溢价 | 单价较高,建议算清利用率后再开卡 |
工程选型建议:
- 如果你的任务需要 26GB~30GB 显存(例如特定配置的 32B 模型量化推理或复杂视频生成工作流),租单张 RTX 5090 往往比租两张 RTX 4090 更省心,因为它避免了跨卡通信延迟,也不需要改写多卡并行配置。
- 如果你的任务需要 40GB~90GB 显存(如 70B 模型 4-bit 推理或 14B 模型多卡数据并行训练),在 NexGPU 算力市场 筛选 2 卡或 4 卡 RTX 4090 节点整机租用,往往比直接上单张 80GB 数据中心卡更具性价比。
三、租用 RTX 4090 云服务器的常见隐性坑与 NexGPU 的透明机制
行业调研显示,不少开发者在租用 RTX 4090 时遇到过“标价很低,结账很贵”的尴尬:比如平台用极低的算力单价吸引注册,却在创建实例时收取开通费、端口映射费,或者强制绑定高价云盘且不支持按秒结算。
在 NexGPU 租用 RTX 4090 或其他型号 GPU 时,平台通过透明的规则设计直接消除了这些隐患:
1. 算力单价与磁盘单价分开标明,账单只有三项
在 NexGPU 的 GPU 市场 中,每一行都代表一台真实可租的物理机器。列表会清晰地将算力单价和磁盘单价分开标出,并展示机器所在地区、可靠性评分、网络带宽和最少卡数。
- 无附加杂费:平台账单严格限制为算力、存储、流量三项(在实例详情页可随时查看实时分项明细),没有最低消费、开通费、端口费、镜像授权费,也没有起租时长限制。
- 价格锁定:下单时的单价会一直锁定到该实例销毁,不会在租用中途因为市场波动而涨价。
- 整机计费透明:多卡节点采用整机出租模式,下单金额直接等于“单卡价 × 卡数”。
2. 先选环境再筛卡,系统自动拦截“显存不够”
新手常犯的错误是先盲目租下卡,进去拉起模型才发现显存不够用。在 NexGPU 中,如果你先选择了所需的环境或模型模板再去筛选机器,显存不够的机器会被系统直接标出并注明原因,从源头避免开错卡白花钱。你也可以参考官方文档《如何选择合适的 GPU》快速匹配硬件。
3. 停机保盘与按秒计量:把间歇开发的成本压到最低
个人开发者跑实验往往是“间歇性”的:白天调代码、跑生图,晚上休息。NexGPU 的计费逻辑专门适配了这种节奏:
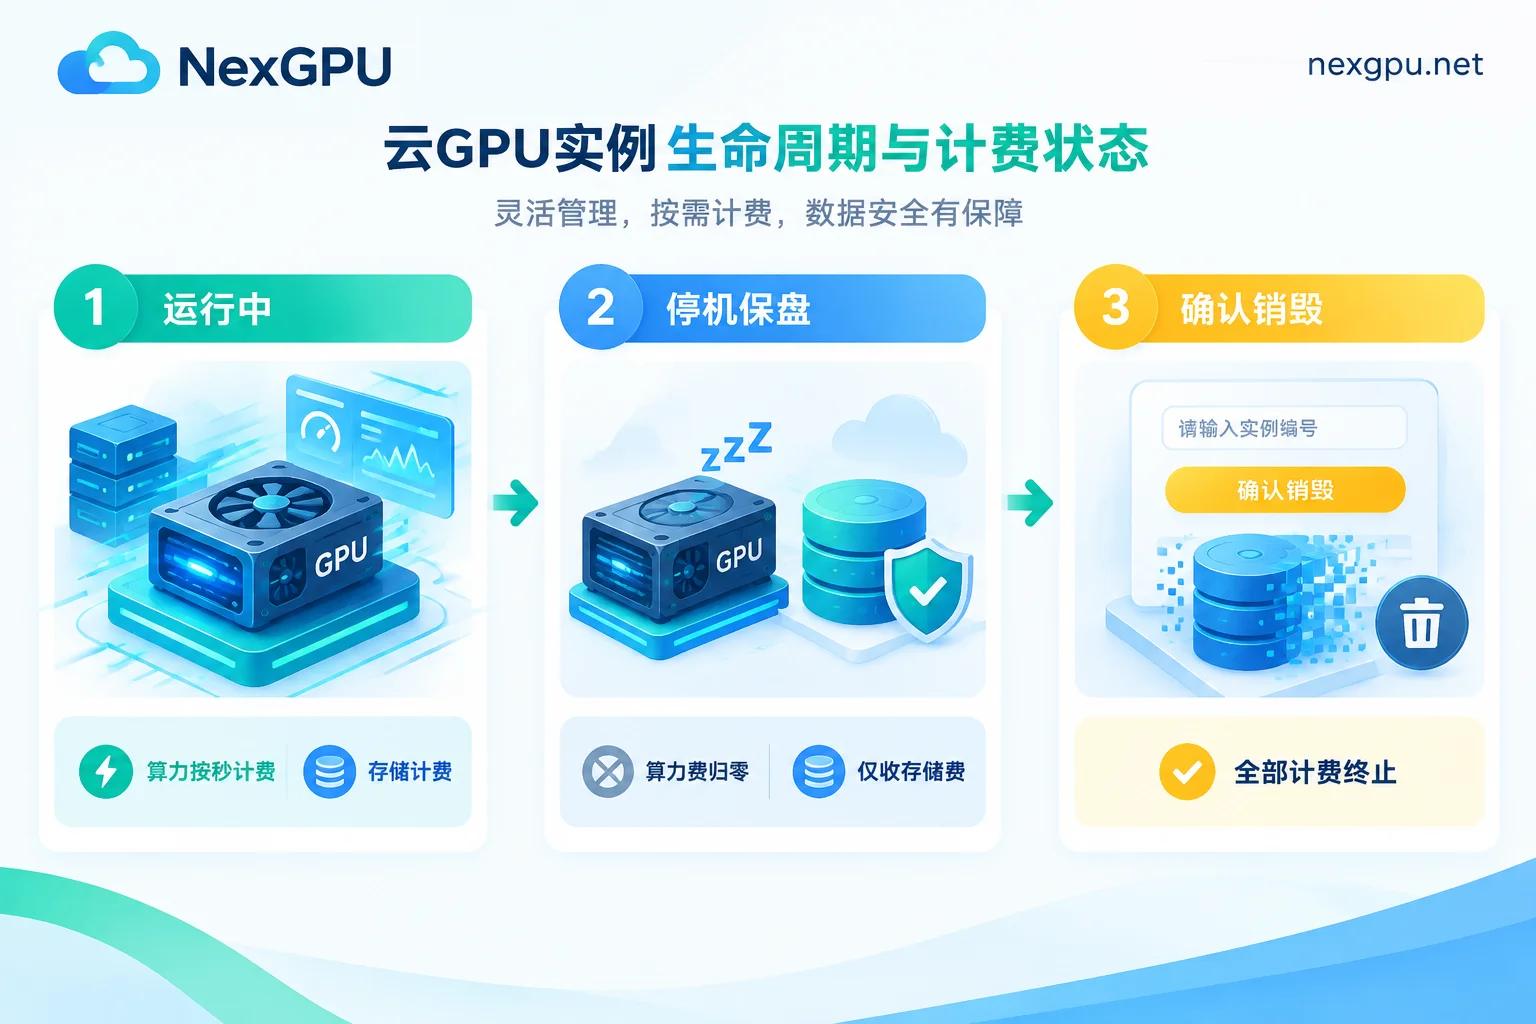
- 算力费按秒计量、按小时计价:只有当实例进入“运行中”状态才开始计费,一旦执行停机或销毁即刻停止计费。
- 停机保留磁盘与数据:当你暂停实验点击“停机”后,算力费立刻归零,仅按 GB/月收取低廉的存储费(注:存储费从实例创建拉取镜像起算,停机照收,销毁才停)。下次需要继续工作时,直接重新启动实例即可,无需重新下载上百 GB 的模型权重(这套操作在《GPU云服务器怎么搭日常开发环境》中有详细演示)。
- 预付费保护机制:账户余额偏低时系统会发送预警邮件;万一余额耗尽,实例会先自动停机(不销毁),只有负余额超过设定时长才会自动销毁,中途充值即可无缝恢复工作进度。完整规则可查阅《计费说明文档》。
四、在 NexGPU 开一台 RTX 4090 的标准实操流程
在 NexGPU 启动一台 RTX 4090 云服务器不需要繁琐的实名认证和配额审批,仅需邮箱即可完成注册,注册后无需绑定支付方式就能浏览全部节点的实时价格(充值支持支付宝与 USDT-TRC20)。从选卡到跑通业务只需四步:
第一步:按业务选定镜像模板
前往 NexGPU 镜像模板库,所有模板均不分档次、免费向所有用户开放,且已预装好匹配 RTX 4090 的驱动、CUDA 及核心依赖:
- 跑大模型 API:选
vLLM、TGI、Ollama或SGLang模板,服务拉起后直接提供标准的 OpenAI 兼容接口。 - 跑微调与训练:选
LLaMA Factory、Unsloth、Axolotl或原生PyTorch/TensorFlow/JAX模板。 - 跑绘画与视频:选
ComfyUI或AUTOMATIC1111模板。 - 自定义环境:如果你的代码严格锁定了特定的 CUDA 小版本,官方建议直接填写你自己的 Docker 镜像(支持公开或私有仓库),并自定义启动命令与环境变量。
第二步:核对磁盘容量与端口(关键避坑点)
在筛选出心仪的 RTX 4090 节点并准备创建实例前,请务必一次性规划好磁盘大小与端口需求:
- 磁盘不可动态扩容:为保障底层独占容器的性能与隔离性,实例创建后不支持扩容磁盘,也不支持创建后增删端口映射。如果你计划存放多个大模型权重或海量渲染素材,请在创建时直接拉足存储空间。
- 善用备用端口:每台实例默认分配公网 IP 和基础端口映射,并额外预留了一组备用端口,方便你在容器内自行启动 Gradio、FastAPI 或监控看板等自定义服务。
第三步:直连开发与可视化管理
实例启动后,你可以根据习惯选择三种连接方式(详见《连接实例指南》):
- SSH 直连:直接使用分配的“公网 IP + 端口”在本地 VS Code 或终端直连,中间不经过跳板机,支持提前设置默认 SSH 公钥。
- Jupyter 一键打开:如果所选环境带有 Jupyter,点击按钮即可在浏览器直接打开,访问令牌(Token)已自动带好。
- 网页终端与 aaPanel 面板:浏览器内提供开箱即用的 root 终端;如果不习惯纯命令行操作,还可以一键安装可视化管理面板 aaPanel(会占用少量磁盘空间),直接在网页里拖拽管理文件、查看进程和配置计划任务。
第四步:监控负载与安全销毁
在运行过程中,你可以在实例管理详情页实时查看 GPU 负载曲线、费用明细、运行日志和操作记录。需要注意的是,NexGPU 的实例为纯粹的独占容器,平台不读取也不备份用户的磁盘内容。当你彻底完成项目、将产出物下载回本地后,输入实例编号确认执行“销毁”,磁盘会被立即释放(不可恢复),存储计费也随之彻底终止。
五、结语:从单卡验证到企业级集群的无缝过渡
对于绝大多数 AI 创作者与研发团队而言,RTX 4090云服务器依然是验证想法、跑通 MVP(最小可行性产品)以及处理中等规模生产任务的最佳跳板。你可以用极低的试错成本在单张 4090 上调通代码,再借助 NexGPU 场景做法页 提供的显存、镜像与预算参考,逐步将业务扩展到多卡 4090 节点乃至 A100、H100、H200 集群。
如果你所在的研发团队正在评估更大规模的多卡分布式训练(如使用 DeepSpeed、FSDP、Megatron),或者需要 RDMA 高速互联、私有网络隔离、包月包年预留实例以及对公付款与合同开票服务,除了在市场中按最少卡数自助筛选下单外,也可以随时通过 联系销售页面 获取专属算力池方案。现在就前往 快速开始指南,开启你的高性价比算力之旅吧。


