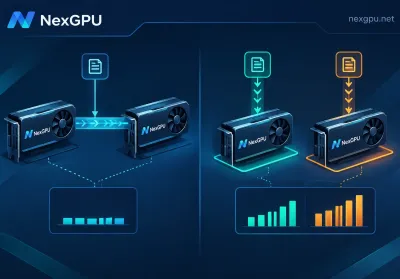
多卡推理吞吐要接近翻倍,前提是新增的卡在处理更多请求,而不是和原来的卡一起算同一个请求。很多人从 1 卡换成 2 卡时,只把 tensor-parallel-size 从 1 改成 2。这是张量并行(TP):两张卡各算模型的一半,每一层都要交换中间结果。它主要解决两件事:模型单卡放不下,以及单个请求太慢。它的设计目标不是把吞吐翻倍。如果模型本来就能装进...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客