 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
消费级显卡(RTX 3090、4090 这类 24GB 档位)不是「玩具」,单卡轻量推理、LoRA/QLoRA 小参数微调、常规图像视频生成,它的性价比都很好。真正会卡住的是四种情况:
- 模型权重就放不下 —— 70B 级别的模型即使 4-bit 量化也装不进 24GB。
- 微调把显存需求翻了好几倍 —— 推理能跑的模型,全参数微调未必能跑。
- 上下文拉长或并发上来,KV Cache 撑爆 —— 权重刚好塞下,等于没有余量。
- 两张卡不等于一张大卡 —— 消费级卡之间没有 NVLink,需要切分模型时被 PCIe 带宽拖住。
还有第五类,不是「跑不动」而是「不该这么跑」:连续几十小时的训练任务和对外提供服务的推理端点,缺 ECC、缺虚拟化隔离、散热和机架形态不匹配,风险不在性能上。
下面逐条说怎么判断自己踩没踩到线,以及踩到之后先做什么。
先花一分钟自查
对着你手上这件事过一遍:
- 我要跑的模型参数量是多少?用什么精度/量化?
- 我是推理,还是微调?微调是全参数、LoRA 还是 QLoRA?
- 上下文窗口要开多长?同时要服务几路请求?
- 任务要连续跑多久?是自己用,还是给别人调用?
四个问题里只要有一个答案明显超出下面的区间,就该考虑换卡,而不是继续在 24GB 上折腾参数。
第一条线:权重装不装得下
最硬的一条线,没有技巧可绕。粗略估算方法是:参数量 × 每个参数占的字节数,再留 15%–20% 余量。FP16 每参数 2 字节,8-bit 约 1 字节,4-bit 约 0.5 字节。
按这个口径,7B 模型 FP16 大约 14GB,24GB 卡能跑;13B 模型 FP16 大约 26GB,已经超了,得降到 8-bit 才进得来。到了 70B 级别(Llama 3.1 70B、Qwen 2.5 72B 这类),即便用 Q4 四位量化,权重仍然需要大约 42GB–48GB 显存,单张 24GB 的消费级卡无论怎么调都加载不进去。
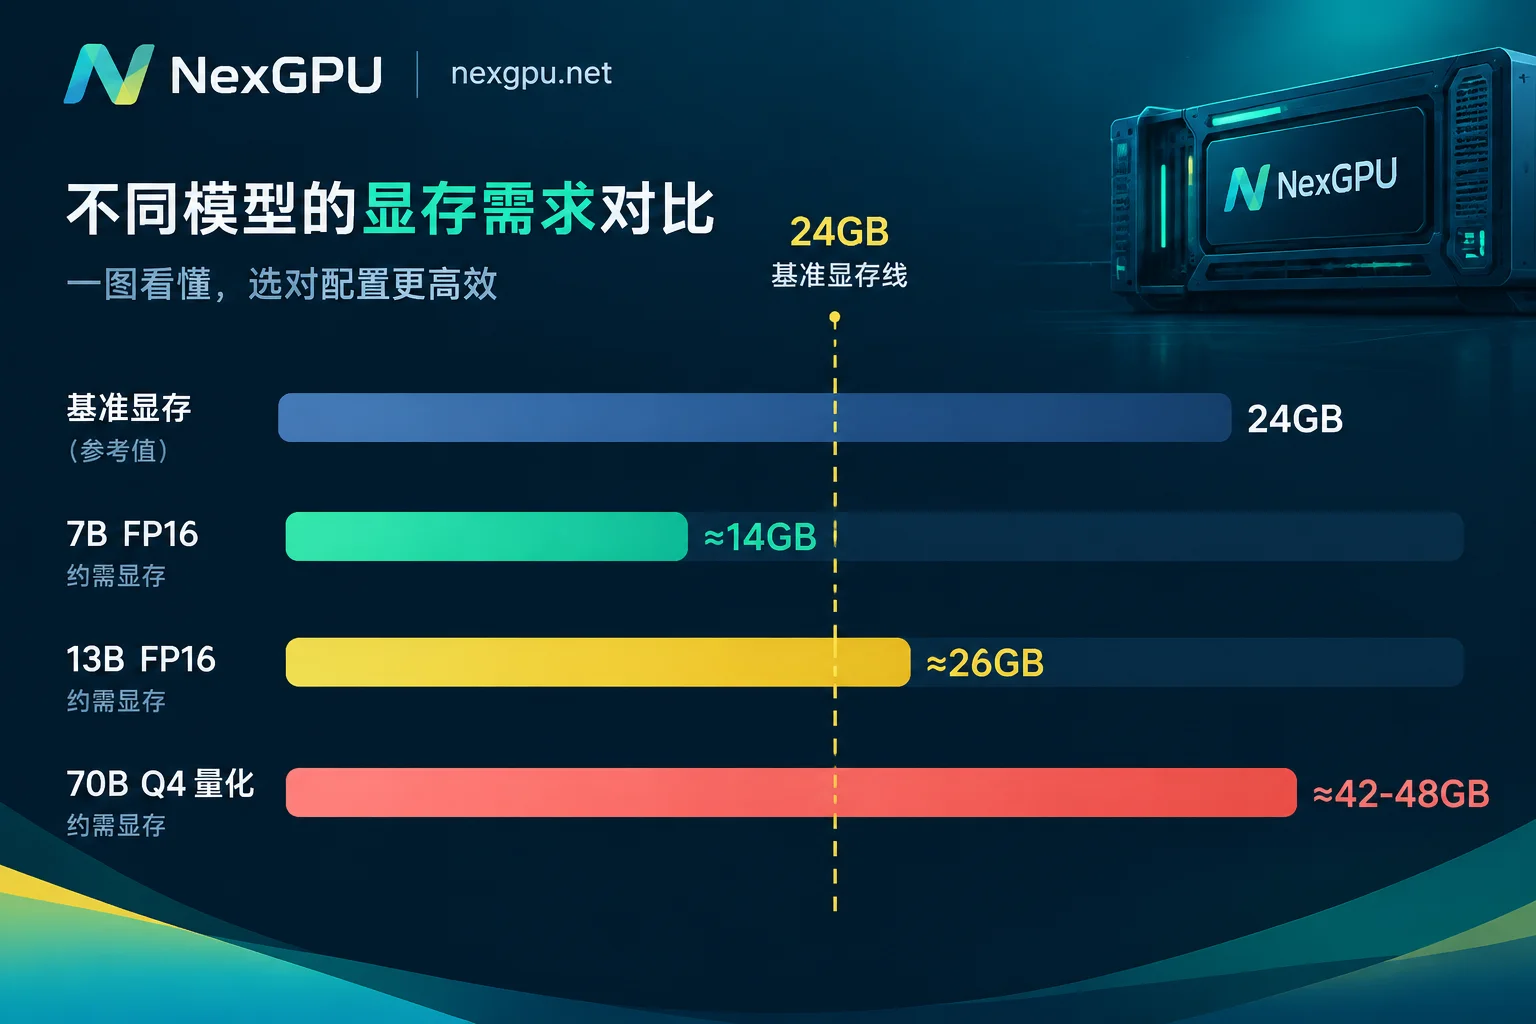
这条线上能做的事只有三件:继续降量化精度(代价是输出质量下降,而且 4-bit 以下收益很快变差)、换更大显存的单卡、或者多卡切分——而多卡切分会撞上第四条线。
第二条线:微调要的显存比推理多得多
很多人第一次踩坑是在这里:某个模型推理跑得好好的,一开始微调就 OOM。原因是训练时显存里不只有权重,还有优化器状态、梯度和中间激活值。经验上,全参数微调每 10 亿参数大约需要预留 16GB–20GB 显存。
落到 24GB 单卡上,大致的天花板是:
- FP16 全参数微调:约 3B 模型
- LoRA(只训练适配层):约 13B 模型
- QLoRA(基座量化 + LoRA):约 20B 模型
这是区间不是定值。batch size、序列长度、是否开梯度检查点(gradient checkpointing)、是否用 8-bit 优化器,都会让这条线上下移动几个 B。所以在换卡之前,值得先把 batch size 降到 1、开梯度检查点、序列长度截短试一轮——如果这些都用上了还是 OOM,那就是真的不够,再加参数技巧只会拖慢收敛。
第三条线:上下文和并发把 KV Cache 顶爆
推理时显存不只被权重占着。上下文窗口每拉长一档、并发请求每多一路,KV Cache 就成倍往上涨。32k、128k 这种长上下文,KV Cache 的占用可以和权重本身在一个量级。
危险的状态是:你的模型权重刚好塞进 24GB,看起来能跑,但余量接近零。这种配置在短提示词、单路请求下一切正常,一遇到长文档输入或者几路并发同时进来,立刻显存溢出。80GB、141GB 这一档数据中心卡的真正价值,很大一部分不在算得多快,而在于能同时承载更深的上下文和更大的并发池。
如果你只是偶尔需要长上下文,可以先在推理框架里把 max_model_len 和最大并发数显式限死,用稳定换容量。但如果长上下文或并发服务本身就是你要交付的东西,那就是硬需求,只能上大显存卡。
第四条线:两张消费级卡不等于一张大卡
这是最容易被误判的一条。NVIDIA 从 Ada Lovelace 架构(RTX 40 系)开始,GeForce 消费级显卡就不再支持 NVLink 了。卡之间只能走 PCIe,PCIe 4.0 的双向带宽大约在 32–64 GB/s,而数据中心的 SXM/NVLink 互联是数百 GB/s 的量级,差着一个数量级。
带宽差多少重要,取决于你用哪种并行方式:
- 数据并行:每张卡各放一份完整模型,各跑各的请求,卡间只在必要时同步。这种模式下 PCIe 完全够用,两张消费级卡跑两个副本、吞吐翻倍是成立的。
- 张量并行:一个模型装不下,按层内维度切开放到多张卡上,每一层前向都要跨卡同步中间激活值。这时候 PCIe 带宽就是瓶颈,通信等待会严重吃掉收益,吞吐和延迟都明显受损。
所以判断口径很简单:你多卡是为了「跑得更多」还是为了「装得下」? 前者消费级多卡没问题;后者(比如想把 70B 切到两张 4090 上)就是在拿 PCIe 硬扛 NVLink 的活,能跑起来,但延迟和吞吐通常达不到可用标准,不如直接换一张大显存卡。
第五类:不是跑不动,是不适合长期这么跑
这一类和显存无关,但会在你把 demo 变成正式任务时冒出来:
- 没有完整的 ECC 显存保护。消费级用的是 GDDR 显存,缺少完整的错误检查与纠正机制,长时间高负载下位翻转可能让跑了几十小时的训练任务崩掉,或者悄悄污染计算结果。
- 缺少 MIG 和成熟的虚拟化隔离,没法把一张卡稳定切给多个任务或多个用户。
- 风冷散热和外形尺寸不适配标准机架的高密度部署。
- 商业许可和 SLA 上存在边界,做对外服务时需要注意。
这几条的适用场景要分清楚:个人在本地或租来的机器上短时间出图、调试脚本、跑几小时实验,完全不需要为这些升级;要交付一个跑几天的训练任务,或者上线一个别人会调用的接口,这些就是必须考虑的因素。
反过来说,这些情况别急着换卡
避免另一个方向的浪费:
- 跑 SD/Flux 这类图像生成,单张图、常规分辨率,24GB 通常是够的。显存吃紧时优先试量化模型和启动参数,这条路比换卡便宜得多。
- 7B–13B 模型的量化推理、LoRA 微调,消费级卡是性价比最高的选择。
- 还在验证流程能不能跑通的阶段——数据格式对不对、脚本会不会报错、镜像环境全不全——用便宜的卡跑通,再把同一套代码搬到大卡上,比一开始就租贵卡省钱。
确认越界之后,怎么落地
先确认瓶颈到底是什么。跑任务时用 nvidia-smi 盯显存峰值,把 OOM 发生的位置记下来:是加载权重时就炸(第一条线)、是反向传播时炸(第二条线)、还是并发一上来才炸(第三条线)。这三种对应的解法不一样,混在一起看很容易买错卡。
如果瓶颈是显存容量,方向是换单卡大显存;如果是卡间通信(多卡张量并行时 GPU 利用率低、等待时间长),方向是换有高速互联的数据中心节点,而不是简单加卡。具体到某个模型该配哪张卡、显存门槛落在哪一档,可以直接查 NexGPU 的模型选卡指南,再到价格与可租节点页看当前哪些型号可租。按小时计费、按秒计量、没有最低消费,意味着你可以先租一小时把真实显存峰值测出来,再决定长期用哪一档,不用一次性押注。
换卡这件事本身有个容易被忽略的成本细节:停机只停算力,存储还在继续计费,销毁才会全部停止。所以如果你是「先在消费级卡上试,确认不够再换大卡」的路径,中间那台试验实例如果只是关机放着,账单不会归零。数据该外移的先外移,不再需要就销毁。这块的具体口径见《GPU 实例关机还收不收费?算力停了,存储还在计》和《租的 GPU 实例数据怎么保存》。
如果你要算的是训练侧的账——多少卡、要不要互联、显存怎么落位——《大模型训练GPU怎么选:先算显存账,再定互联和卡数》把这套算法写得更细;如果你手上就是一个 Llama 系模型要部署,《Llama 模型部署实操》里有 vLLM 开服和多卡切分的具体步骤。
最后提醒一句:上面所有数字都是按 24GB 这一档估的。新一代消费级卡显存更大,会把第一、第二条线往后推一点,但第四条线(没有 NVLink)和第五类(ECC、隔离、机架)不会因为显存变大而消失。判断时按你实际要租的型号规格算,别照搬别人帖子里的结论。



评论(0)