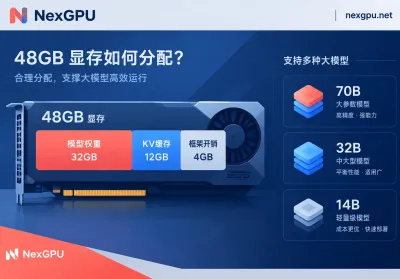
先说结论。48GB 显存单卡(RTX 6000 Ada、L40/L40S、A6000、A40 这一档)的能力边界如下。推理:最大能跑 70B 级模型的 4-bit 量化版,前提是单用户或小并发、上下文在 4K~8K 左右。想留出更多余量,可以选 32B/34B 的 8-bit 版,或 14B 的 FP16/BF16 原精度版。微调:极限是 70B 的 ...
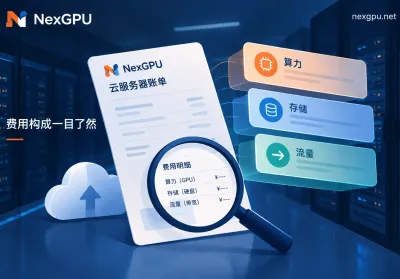
比较几家云厂商的 GPU 价格,最常见的错误是只看控制台上那一行每小时单价。账单上的实际金额,是一项任务从开机到数据清理完毕的总花费:算力按运行时长计费;存储按容量和保留时长计费;出网流量按传出去的数据量计费。还有一些门槛不写在单价里,比如要不要整机起租,要不要签合约才能拿到折扣。所以比价要换个顺序:先确定任务需要什么卡、跑多久、数据留多久、要往外传多...
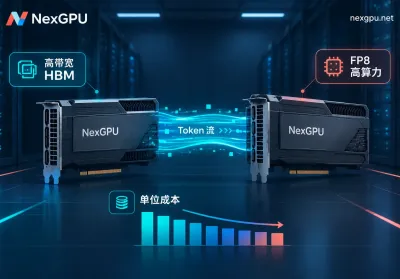
先说结论:请求并发高、模型能放进单卡(7B/13B,或 FP8 量化后的 30B 级),并且推理框架能开启 FP8 时,L40S 的每百万 Token 成本通常更低。并发低、要求逐字输出快、上下文很长,或者要把 70B 以上未量化模型切到多张卡上跑,A100 80GB 更合适,多卡时最好选 SXM 版本。两张卡的优势对应的是推理过程中的不同阶段。弄清楚...
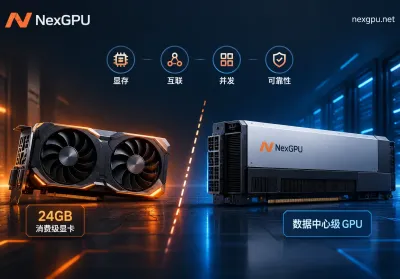
消费级显卡(RTX 3090、4090 这类 24GB 档位)不是「玩具」,单卡轻量推理、LoRA/QLoRA 小参数微调、常规图像视频生成,它的性价比都很好。真正会卡住的是四种情况:模型权重就放不下 —— 70B 级别的模型即使 4-bit 量化也装不进 24GB。微调把显存需求翻了好几倍 —— 推理能跑的模型,全参数微调未必能跑。上下文拉长或并发上...
0 条留言
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客