 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
拿到云 GPU 实例后,先别急着敲安装命令,按四层顺序核对环境:驱动支持上限 → Toolkit 编译器版本 → 框架编译版本 → 算子是否真正走加速路径。CUDA Toolkit 加速大模型训练配置的核心,就是把这四层版本对应关系查清楚,再决定要不要装完整 Toolkit。
先给结论:三个版本号各管什么,核对顺序怎么排
很多人误以为 nvidia-smi 显示的就是已装的 CUDA 版本,其实那是驱动层支持的最高运行时上限;nvcc -V 才是当前 PATH 里激活的编译器版本;PyTorch 报错时提到的又是它编译时用的 CUDA 版本。这三个数字不一致,往往不是故障,而是它们各管一段。CUDA Toolkit 加速大模型训练配置的正确核对顺序是:驱动 → Toolkit → 框架编译版本 → 算子生效路径。
CUDA 13.3 引入了 Tile C++ 瓦片级编程接口,13.3 Update 1 进一步落地了 CompileIQ 自动调优框架——用进化算法为关键算子寻找最优编译器控制文件(ACF),NVCC 也新增了 --apply-controls 标志来应用调优结果。这背后的信号是:底层算子调优正被官方工具链接管,开发者更该把精力放在版本核对与生效确认上。
第一步:核对驱动——nvidia-smi 显示的是支持上限,不是已装 Toolkit
nvidia-smi 输出的 CUDA 版本代表驱动层(Driver API)支持的最高 CUDA 运行时版本,比如驱动层报出的可能是一个更高的 CUDA 运行时版本,而系统里实际安装的 Toolkit 版本更低。nvcc -V 显示的是 PATH 中激活的编译器版本,两者不一致很常见,只要驱动版本不低于运行库所需的最低要求,就属于正常。
所以“nvcc -V 和 nvidia-smi 显示的版本不一样”先不用慌,确认驱动够新即可。这也自然回答了“cuda toolkit版本和显卡驱动怎么对应”这个问题:驱动是地基,Toolkit 是工具,地基能承住更高的工具就行,不必强求数字一致。
驱动向下兼容的判断依据只有一个:驱动版本 ≥ 运行库要求的最低驱动版本。如果为了迎合某个低版本 Toolkit 而刻意降级驱动,反而可能破坏运行库依赖,得不偿失。驱动和 Toolkit 本来就是两个独立更新节奏的组件,对齐数字没有意义,对齐兼容关系才有意义。
第二步:核对 Toolkit——什么时候框架自带运行时就够,什么时候必须装完整版
如果训练脚本是纯 Python,用 PyTorch 预编译 wheel,它自带嵌入式 CUDA 运行时动态库,此时不需要装完整 CUDA Toolkit,驱动满足即可。但一旦要即时编译或源码构建 C++/CUDA 扩展(如 FlashAttention、Apex、DeepSpeed 自定义算子),就必须装完整 Toolkit,并让 CUDA_HOME 指向的 nvcc 主版本与编译 PyTorch 的 CUDA 版本匹配。多卡场景下这类源码构建扩展最容易因版本错配在启动阶段失败,可对照 DeepSpeed多卡分布式训练踩坑指南 一并核对。
判断要不要装完整版,就看你的模型是否依赖源码构建的加速算子。云 GPU 实例上查 CUDA 版本的标准流程是:先用 nvidia-smi 看驱动支持的上限,再用 nvcc -V 看编译器版本,如果 nvcc 命令找不到,说明系统里没有安装完整的 CUDA Toolkit,只有运行库。此时若是纯 Python 脚本还能跑,一旦需要源码构建就会失败。
如果 CUDA_HOME 未设置,源码构建扩展时编译器会找不到 nvcc,直接报“command not found”或构建中断,这也是判断环境不完整的明显信号。
第三步:核对框架编译版本——CUDA version mismatch 报错怎么读
当 CUDA_HOME 指向的 nvcc 版本与 PyTorch 编译时用的 CUDA 不一致,构建期会抛出 RuntimeError: The detected CUDA version does not match the version that was used to compile PyTorch。这个报错指向编译期,不是运行期,意思是编译器版本对不上,而不是驱动或库缺了。
解决思路有三条:换一个与本地 nvcc 匹配的 PyTorch wheel;调整 PATH 或 CUDA_HOME 指向正确版本的 Toolkit;或者改用预编译扩展,避免走源码构建路径。报错文本里的版本号是核心线索,照着它去对齐即可。
第四步:确认加速路径真的生效,而不是静默回退
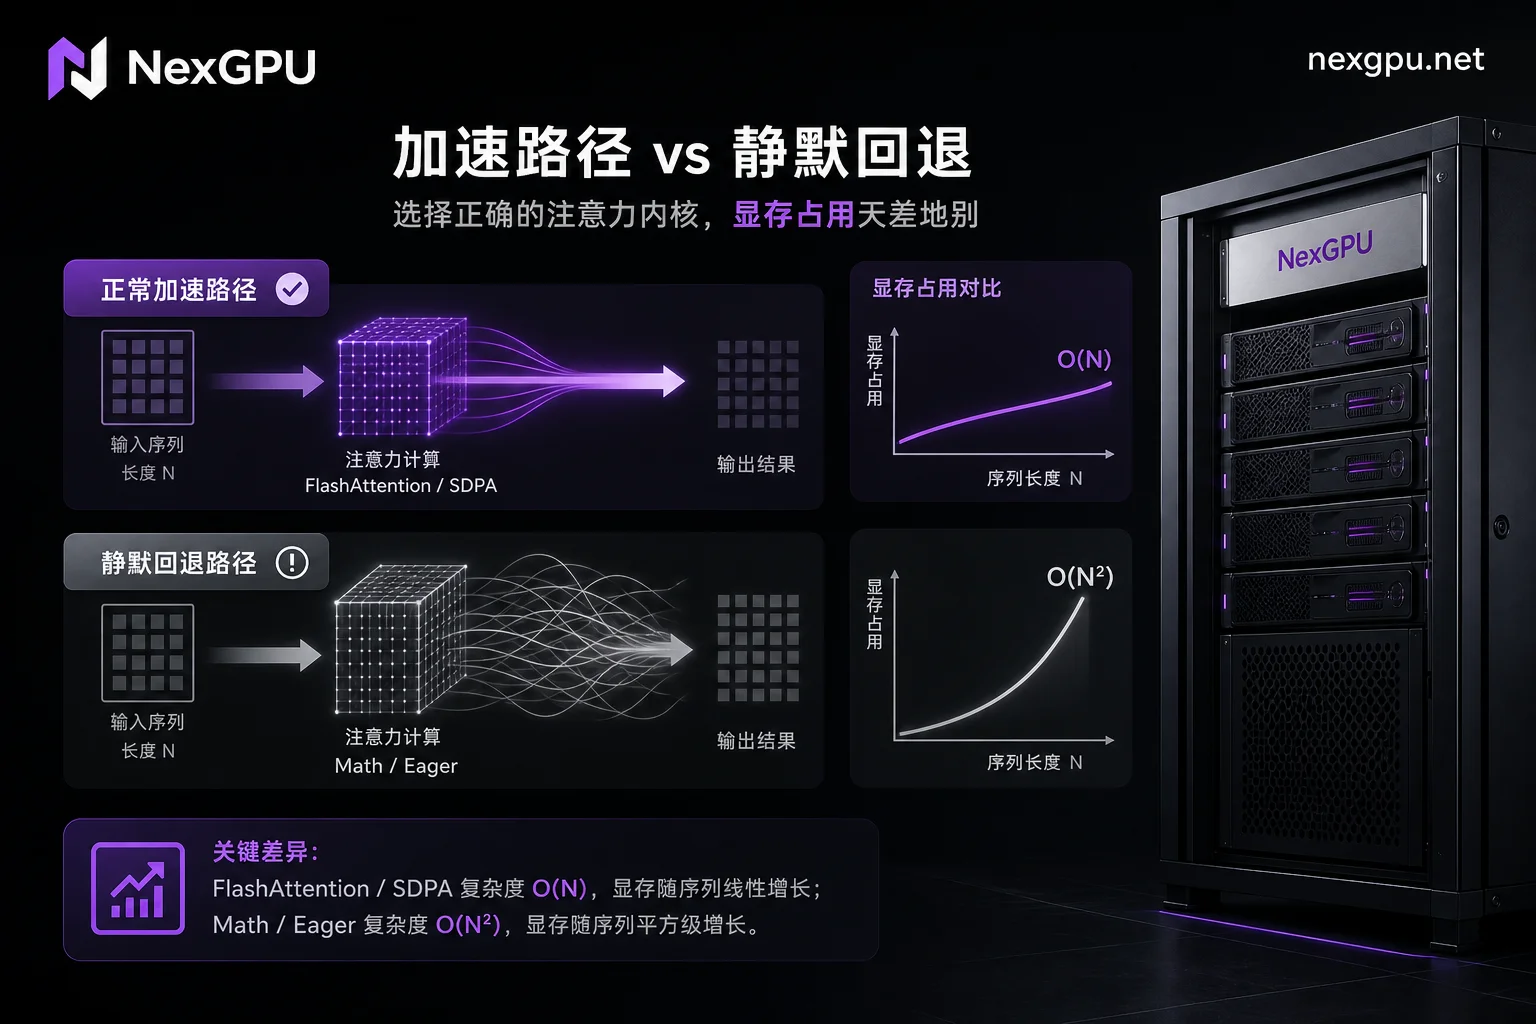
最隐蔽的问题是:加速算子编译缺失或 GPU 计算架构能力(Compute Capability / TORCH_CUDA_ARCH_LIST)不匹配时,PyTorch 的 SDPA 或 Hugging Face 会静默回退到通用的 Math 实现或 Eager 模式,程序不报错,但注意力矩阵的空间占用从 O(N) 退化成 O(N²),显存瞬间暴增、吞吐急剧下降。
排查方法是对比显存曲线和单步耗时:如果显存异常上涨、速度明显变慢,很可能是回退到了 Math 实现。检查 TORCH_CUDA_ARCH_LIST 是否包含你 GPU 的架构号,并确认 FlashAttention 等算子是否真的被编译进了环境。这一步不抓好,CUDA Toolkit 加速大模型训练配置做得再对,实际性能也上不去。出现吞吐骤降时,可参考 GPU利用率优化 定位瓶颈,往往与静默回退相关。
工具链正在接管手工调优:Tile C++ 与 CompileIQ 改变了什么分工
CUDA 13.3 系列最大的变化,是把调优从“手写内核”推向“工具链自动优化”。Tile C++ 提供瓦片级编程接口,让开发者用更接近 C++ 的方式描述计算;CompileIQ 则用进化与遗传算法自动搜索关键算子的最优编译器控制文件,再通过 --apply-controls 应用到 NVCC/PTXAS 的指令生成中。
这改变了工程分工:以前要手动调循环展开、寄存器分配,现在官方工具链能自动找到更优配置。算法工程师和 MLOps 的核心任务变成:确认工具链版本正确、环境基线统一、算子没有静默回退。对“CompileIQ 是什么”这个问题,可以理解为:一个帮你自动调编译器参数、省去手工试错的框架。
升级还是不升级:给已有训练任务定一条版本基线
升级前先回答三个问题:现有任务是否依赖源码构建的扩展?算子是否已确认没有回退?新工具链是否带来你需要的功能?如果都不需要,就冻结当前基线,别为了新版而升级。如果需要新能力,先在隔离实例上验证,再推给团队。像 NexGPU 这类按量计费的 GPU 云平台可以临时起一台隔离实例做兼容性验证,验证完即释放,不必动生产集群。
升级前后要记录几个观察项:显存占用曲线、单步耗时、算子后端选择结果(是否走了加速路径)。
环境核对清单与四个常见误判
| 核对层 | 检查动作 | 通过标准 |
|---|---|---|
| 驱动层 | 运行 nvidia-smi | 显示的支持上限 ≥ 所需运行库版本 |
| Toolkit 层 | 运行 nvcc -V,检查 CUDA_HOME | 编译器版本与框架编译版本匹配 |
| 框架层 | 查看 PyTorch 编译时 CUDA 版本 | 与本地 nvcc 主版本一致 |
| 加速路径 | 检查 TORCH_CUDA_ARCH_LIST、显存曲线 | 无静默回退,显存接近 O(N) 规模 |
四个常见误判:把 nvidia-smi 的输出当成已装 Toolkit 版本;以为程序跑通就等于走了加速路径;在纯 wheel 环境多装完整 Toolkit;忽略 TORCH_CUDA_ARCH_LIST 导致架构不匹配。对照这张表逐项过一遍,就能避免绝大多数环境坑。
排查显存异常时,可以参考 GPU Out of Memory显存溢出解决方法;确认算子加速时,可以读 FlashAttention-3显存与速度优化,这类问题往往与静默回退紧密相关。
常见问题
为什么 nvcc -V 和 nvidia-smi 显示的版本不一样?需要改吗?
不需要改。nvidia-smi 显示驱动支持的最高 CUDA 运行时版本上限,nvcc -V 显示当前 PATH 中激活的编译器版本,两者本就不同。只要驱动版本不低于运行库最低要求,就属于正常现象,不用强制对齐。
云 GPU 实例上怎么查当前 CUDA 版本?
先用 nvidia-smi 看驱动支持的最高 CUDA 版本,再用 nvcc -V 看已安装的编译器版本。如果 nvcc 找不到,说明没装完整 Toolkit。两者结合,就能判断当前环境的 CUDA 状态。
PyTorch 报 CUDA version mismatch 怎么办?
先读报错:它提示的是编译期版本不匹配,不是运行期问题。检查 CUDA_HOME 指向的 nvcc 版本是否与 PyTorch 编译时所用的版本一致;不一致就换匹配的 wheel、调整 PATH,或改用预编译扩展。
训练环境要不要装完整的 CUDA Toolkit?
如果只用 PyTorch 预编译 wheel 跑纯 Python 脚本,不需要装完整 Toolkit,驱动满足即可。但如果要源码编译 FlashAttention、Apex、DeepSpeed 等 C++/CUDA 扩展,就必须装完整版并配好 CUDA_HOME。
升级 CUDA 会不会影响已有训练代码?
如果代码依赖源码构建的扩展,升级后可能因版本不匹配报错;如果走预编译 wheel,影响较小。先确认算子是否回退、再在隔离实例验证,确认没破坏加速路径后再升级,风险可控,也可以在 NexGPU 的按量实例上起一台隔离环境,跑一遍上述四层清单,确认算子未回退后再固化成团队基线。



评论(0)