 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
同一个 7B 模型,QLoRA 微调一张 24GB 消费级卡就能跑,全参数微调却要好几张 80GB 卡加参数切分。差别不在模型本身,而在训练时显存里到底装了几样东西。所以选卡的顺序永远是:先确定用哪种训练方式,再算显存账,最后才决定卡数和互联。
四档训练方式对应的卡位
先给一个可以直接对照的起点,具体到某个模型的显存门槛,官网的模型选卡指南按模型列得更细,这里只给判断逻辑:
- QLoRA(4-bit 量化基座 + Adapter):7B~14B 模型,单张 24GB 卡(如 RTX 4090)够用,前提是开 Gradient Checkpointing 和 FlashAttention。
- LoRA(BF16 基座 + Adapter):7B 在 24GB 上偏紧,序列一长就容易溢出;13B~34B 建议单张 48GB 或 80GB。
- 全参数微调:7B 起步就需要多卡 80GB 配 ZeRO-3 或 FSDP,单张 80GB 直接跑不通。
- 从头预训练 / 70B 级全参微调:数据中心级 GPU 多卡集群,且必须有 NVLink 级别的卡间互联。
如果你的任务落在前两档,剩下的决策其实很轻;落在后两档,卡数和拓扑才是主要成本来源。
训练显存由四部分组成
推理时显存基本就是权重加 KV Cache,训练要多背三样东西。以 FP16/BF16 混合精度、AdamW 优化器为例,按每个参数计:
- 模型参数:约 2 字节;
- 梯度:约 2 字节;
- 优化器状态:FP32 主权重 + 一阶动量 + 二阶动量,合计约 12~16 字节;
- 激活值:不按参数量算,而是随序列长度、批大小、层数一起涨,是最容易被漏掉的一块。
把前三项加起来,全参训练大致要为每个参数预留 16~20 字节。7B 模型静态开销就超过 100GB,这还没算激活值——所以「80GB 卡装 7B 全参训练」这个直觉是错的,必须靠 ZeRO-3/FSDP 把参数、梯度、优化器状态切到多张卡上,再配合激活重算压住第四项。
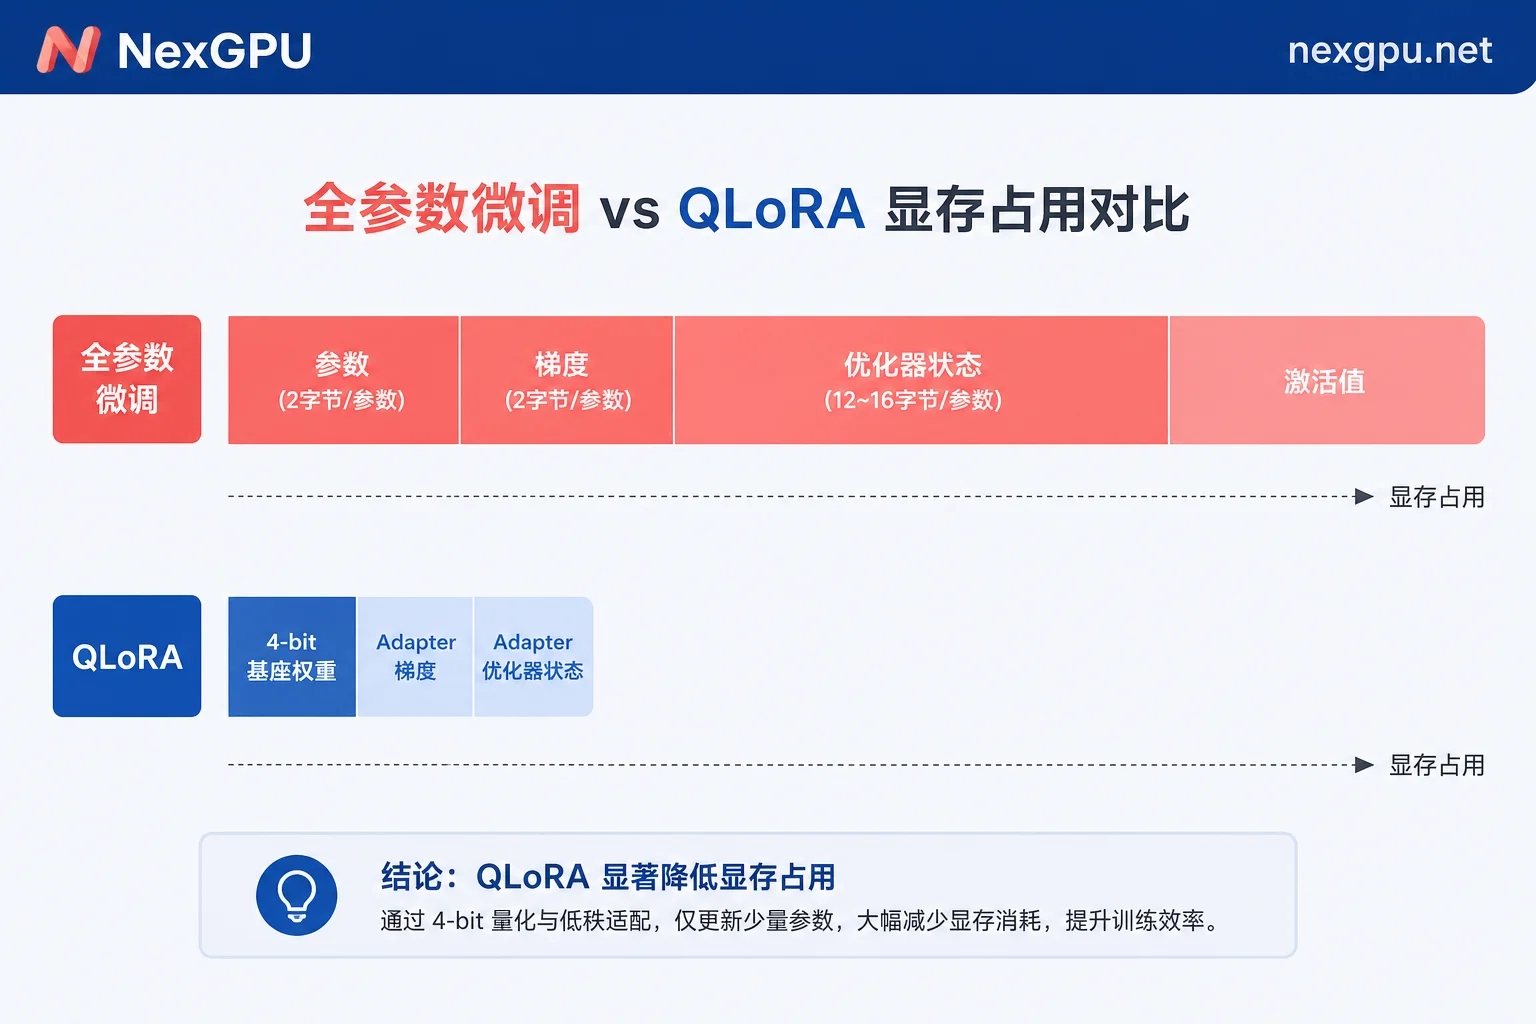
反过来看 LoRA 为什么省:基座权重被冻结,不产生梯度,也不需要优化器状态;QLoRA 更进一步把基座量化到 4-bit 载入,7B 的权重只占约 5GB。剩下需要算梯度和动量的只有很小的 Adapter,24GB 卡上自然放得下。量化档位对显存的影响可以参考FP8 与 INT4 量化对 GPU 显存的影响。
装不下时,先切分还是先加卡
遇到 OOM 别急着换更大的卡,按代价从低到高试:
- 降批大小、降序列长度:激活值是唯一随这两项线性甚至更快增长的部分,先动它成本最低。
- 开 Gradient Checkpointing(激活重算):用约 20%~30% 的额外计算时间换掉大部分激活显存,长序列训练几乎必开。
- 换高效注意力实现:FlashAttention 系列把注意力中间矩阵的显存从随序列长度平方增长压下来,具体做法见 FlashAttention-3 显存与速度优化。
- 换训练方式:全参改 LoRA,LoRA 改 QLoRA。如果业务上能接受,这一步的收益比加卡大得多。
- 再考虑加卡 + ZeRO-3/FSDP 切分。
定位 OOM 具体卡在哪一步,可以对照GPU Out of Memory 显存溢出解决方法。
多卡的瓶颈常常不在卡,而在互联
一旦进入多卡,卡与卡之间的通信带宽会直接决定你能拿到多少加速比。
消费级显卡没有 NVLink,跨卡通信走 PCIe。做纯数据并行(每张卡各存一份完整模型,只同步梯度)时影响还能忍;但一旦跑张量并行,或者用 ZeRO-3 这类每个前向/反向步骤都要 All-Gather 参数、All-Reduce 梯度的方案,通信量会成倍上升,PCIe 带宽很快成为瓶颈,出现「卡加了一倍、速度只快了三成」的情况。
数据中心级 GPU(A100/H100 一类)配备 600~900 GB/s 的 NVLink 互联,正是为了扛住这类高频通信。所以判断标准可以简化成:
- 每张卡都能放下完整模型和优化器状态 → 数据并行即可,消费级多卡也有性价比;
- 必须靠切分才能装下(ZeRO-3、张量并行、流水线并行) → 优先选带 NVLink 的数据中心卡,否则通信开销会吃掉扩卡收益。
70B 级别的分布式微调到底要几张卡、每张多少显存,Llama3 70B 分布式微调算力需求里算得更具体;实际跑 ZeRO 时的常见坑可参考DeepSpeed 多卡分布式训练踩坑指南。
租卡时的推荐顺序:先小规模验证,再上规模
按小时租用最容易浪费钱的地方,是直接开一台多卡机器然后花两小时调环境。更省的做法是分两步:
第一步,用最小配置跑通流程。 选一个带 PyTorch 或训练框架的镜像模板一键部署,省掉自己装驱动和依赖;开一张便宜的卡,把数据加载、tokenizer、LoRA 配置、日志、Checkpoint 保存路径全部跑通,训练几十个 step 确认 loss 正常下降。这一步只要显存够装下最小 batch 就行。环境层面的版本对齐可以照CUDA Toolkit 配置核对顺序过一遍。
第二步,按第一步实测的峰值显存去选正式训练的卡。 用 nvidia-smi 或框架自带的显存统计拿到真实占用,比任何估算公式都准,尤其是激活值这块——序列长度从 2k 提到 8k,激活显存可能翻好几倍,公式很难提前算准。
账单和数据的边界:停机 ≠ 停止计费
训练任务往往跑几小时到几天,中途大概率会中断或需要暂停,这里有两条必须提前想清楚的规则。
计费口径:在 NexGPU 上,账单只有算力、存储、流量三项,按小时计费、按秒计量,无最低消费也无合约,下单时的单价会锁定到实例销毁为止。停机(Stop)只释放算力,磁盘存储仍然计费;只有销毁(Destroy)才全部停止。 这条规则直接决定你的收尾动作顺序:训练跑完 → 把权重和 Checkpoint 回传到你自己的存储 → 确认文件完整 → 再销毁实例。顺序反了,数据就找不回来了。完整口径见计费说明。
Checkpoint 策略:长任务一定要设定期保存,并且保存频率要和「重跑一次的代价」匹配——如果中断后最多只能接受损失一小时进度,那就至少每小时存一次。同时注意 Checkpoint 本身很占盘:全参训练的 Checkpoint 包含优化器状态,体积可能是模型权重的好几倍,保留过多份会明显推高存储那一项。保留策略和恢复方式可以参考云端 GPU 长任务中断恢复与 Checkpoint 设置。
几个容易算错的地方
- 只按参数量算权重:把 7B×2 字节 = 14GB 当成训练需求,漏掉了梯度和优化器状态那 14~18 字节,实际差近十倍。
- 忽略序列长度:同一份配置,2k 上下文跑得好好的,换成 32k 长文本数据就 OOM,问题出在激活值而不是权重。
- 拿推理经验套训练:推理能单卡跑的模型,训练时未必单卡跑得动,两者的显存结构完全不同,具体差异见大模型推理 GPU 怎么选。
- 多卡默认线性加速:没有 NVLink 的多卡在通信密集型并行策略下衰减明显,扩卡前先小规模测一下实际加速比。
判断清楚自己落在哪一档之后,可以直接去价格与可租节点页面看当前有哪些卡型可用;如果要评估的是多卡集群或长期训练方案,走联系页面沟通配置更快,Telegram 客服支持中英双语。



评论(0)