 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
GPU Out of Memory显存溢出解决方法的关键不是调小 batch size,而是先把显存占用归为四类——模型权重与优化器状态、前向激活峰值、Caching Allocator 碎片、Python 引用循环残留——再用 PyTorch 官方 Memory Snapshot 定位后对症处置。PyTorch 官方(2023 年 12 月的系列技术博客)已把排查方案从“调小 batch size / 清缓存”升级为分类诊断,本文按这条路径拆成五步,涵盖训练 7B 模型第一步就 OOM 的常见场景。
先分清四类 OOM:权重、激活峰值、分配器碎片、引用未释放
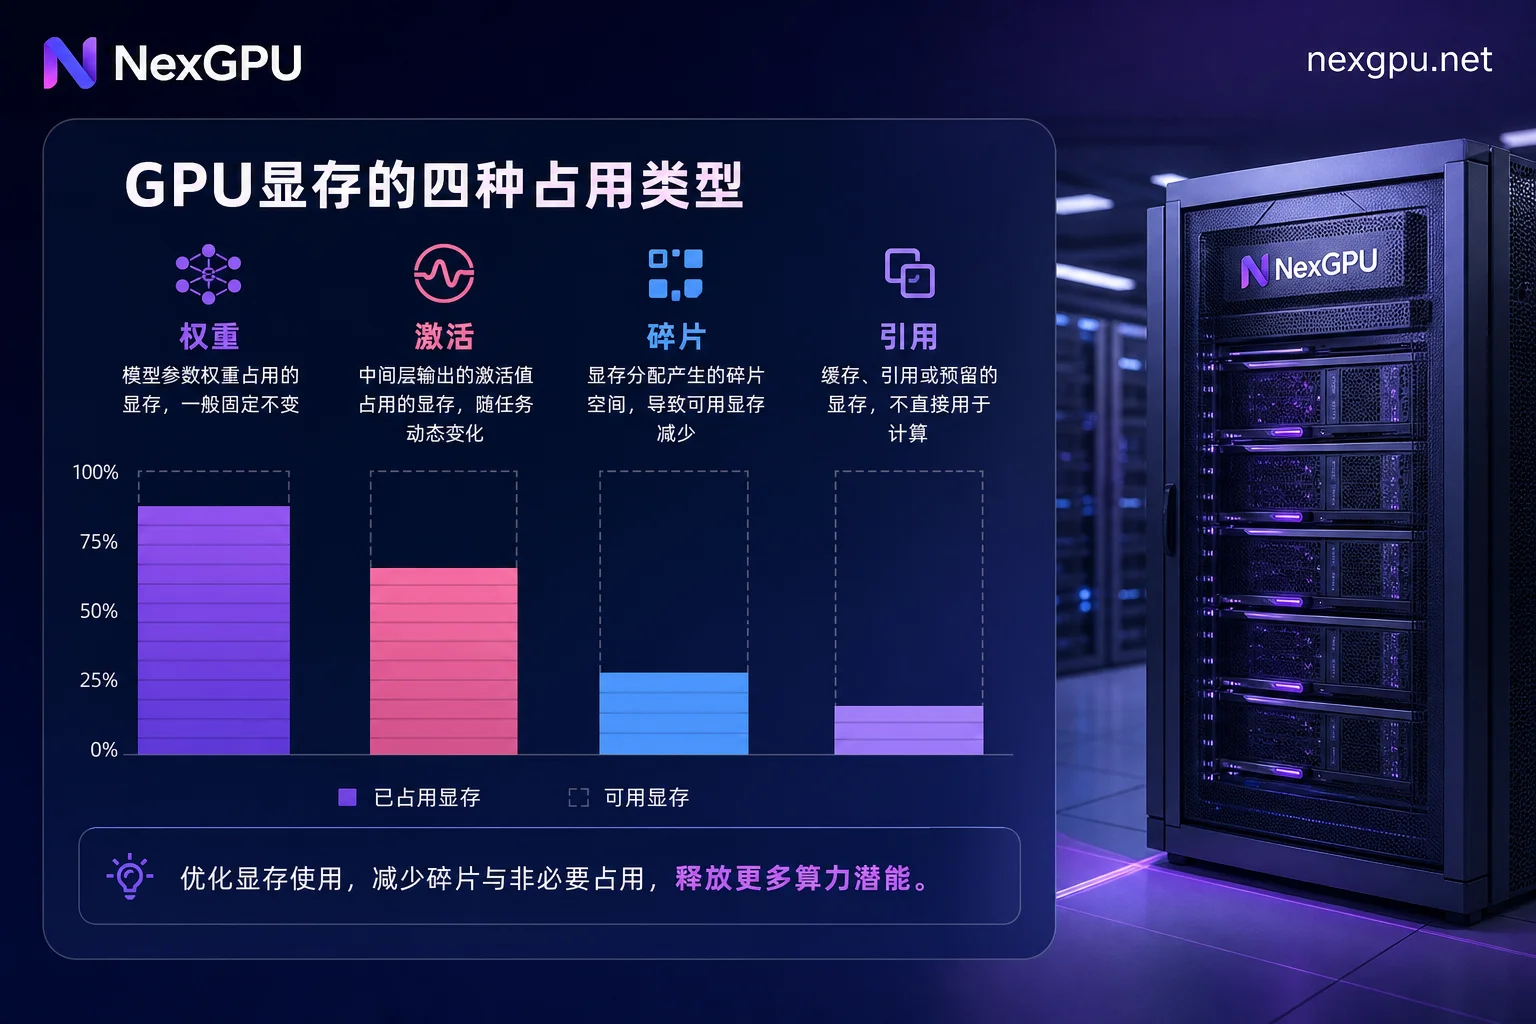
动手前先归类,否则只会乱试参数。GPU 显存主要由四类构成,每一类的现象和处置完全不同:
- 模型权重与优化器状态:常驻显存,数量固定。若第一步就 OOM,且分配器报错信息里总分配量接近卡型容量,多半属于此类。
- 前向激活峰值:随着 batch size 和序列长度线性或超线性增长。典型表现是调小 batch size 后能继续训练,但一恢复原值又 OOM。
- Caching Allocator 碎片:PyTorch 的内存分配器向驱动申请了显存,但内部碎片导致有效空间不足。典型现象是“CUDA out of memory 但显存还有剩余”,报错里 Reserved 远大于 Allocated。
- Python 引用循环残留:本应释放的 Tensor 因引用循环滞留显存。典型现象是训练跑到一半才 OOM,且显存占用呈锯齿状或阶梯式攀升。
第一步:CUDA out of memory 但显存还有剩余?先读懂 allocated / reserved / free
PyTorch 报错信息里的三个数字:Allocated 是活跃 Tensor 实际占用,Reserved 是缓存分配器向 CUDA 驱动申请的总量,Free 是物理剩余。判据很简单:
| 场景 | 现象 | 结论 |
|---|---|---|
| Reserved 远大于 Allocated | 报 OOM 但显存还有剩余 | 指向碎片化 |
| Allocated 与 Reserved 接近 | 贴近卡的物理显存 | 真实容量不足 |
顺带纠正一个常见误解:torch.cuda.empty_cache() 只把闲置且已 Reserved 的显存块归还给驱动,不会释放活跃张量,更不会抬高物理上限;频繁调用还会带来同步开销、降低吞吐。详细机制见 PyTorch CUDA语义文档。
第二步:用 PyTorch Memory Snapshot 记录分配堆栈,生成显存时间线
PyTorch 官方 Memory Snapshot 可以捕获全生命周期的分配/释放堆栈,并以微秒级时间线可视化,官方博客 提供了详细说明。用法如下:
import torch
torch.cuda.memory._record_memory_history()
# 运行你的训练或推理代码
torch.cuda.memory._dump_snapshot("snapshot.pickle")
torch.cuda.memory._record_memory_history(enabled=None)
然后把生成的 .pickle 文件拖到官方可视化工具 https://pytorch.org/memory_viz,即可查看显存时间线和每个分配点的调用栈。整个过程只依赖官方 API,注意不要用未文档化的参数。
第三步:显存泄漏怎么定位——从时间线形态读峰值与攀升
从时间线形态读出结论:
- 单次尖峰:指向某个算子或反向传播的激活峰值,看尖峰时刻的调用栈。
- 锯齿状或阶梯式持续攀升:指向引用循环导致的滞留,调用栈会显示 Tensor 未释放。
- 平台高位:常驻权重与优化器状态,几乎不动。
定位到具体代码位置后,再决定下一步动作。若时间线显示显存平稳但吞吐偏低,问题可能在算力侧而非显存侧,可参考 GPU利用率优化。
第四步:按类别处置——梯度检查点、精度档位、分配器参数、断开引用循环
GPU Out of Memory显存溢出解决方法到这一步才真正落到动作上:四类根因对应四类处置。
- 激活峰值高:用梯度检查点(Gradient Checkpointing),前向丢弃中间激活、反向重算,以约 20% 的计算时间开销大幅压缩激活显存。
- 碎片化:配置
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True(较新版本为PYTORCH_ALLOC_CONF),利用 CUDA VMM 动态扩展显存段,消除分段碎片。 - 引用循环:从调用栈定位到对象,用
del显式删除或重构代码断开引用。 - 权重常驻:权重与优化器状态常驻显存,可通过降低精度档位、切换更省显存的优化器实现或分片策略来压缩;不同方案对权重、梯度、优化器状态三部分的影响不同,需按实际报错中的常驻占用逐项核算。
要注意,expandable_segments 无法突破物理显存硬上限,不能彻底消除 OOM。
第五步:确认是否真的需要更大显存卡型,用同一脚本做峰值对照
如果以上治理后 Allocated 仍逼近物理显存,说明代码侧已尽力。此时可以借助按量 GPU 资源临时切到更大显存卡型,跑同一份脚本对比显存峰值,用两组数据判定是代码还是卡型问题。例如 NexGPU 提供按量实例,让你在不长期持有卡的情况下完成验证,避免盲目扩卡。参考 GPU显存怎么选 可以了解不同卡型的容量差异。
推理服务侧的特殊情况:KV Cache 与显存利用率参数
推理场景的显存构成与训练不同:KV Cache 随并发与上下文长度增长,成为显存主要变量。NVIDIA 官方(2025 年 9 月)文章指出,CPU-GPU 内存共享与 KV Cache 卸载是业界正在推进的方向,但具体收益因硬件与框架而异,不在这里给数字。同时,推理框架的显存预留比例参数与 PyTorch 分配器行为会相互影响,调参前建议先把框架的预留参数和 expandable_segments 一起考虑,相关实践可参考 vLLM多卡张量并行配置指南。在估算模型所需显存时,可参考 Qwen部署要多少显存。
排查检查清单与四个常见误判
把上面的 GPU Out of Memory显存溢出解决方法压缩成一张可执行清单。
- [ ] 报错时记录 Allocated 与 Reserved,判断是否碎片化。
- [ ] 开启 Memory Snapshot,抓取调用栈和时间线。
- [ ] 定位峰值或攀升的位置与代码。
- [ ] 按类别处置:梯度检查点、expandable_segments、断开引用循环。
- [ ] 治理后若仍 OOM,用更大卡型做峰值对照。
四个常见误判:
- 以为
empty_cache()能扩显存——它只释放闲置块。 - 以为开了
expandable_segments就永不 OOM——物理上限依然存在。 - 把碎片问题当成卡不够——先看 Reserved 与 Allocated 的差距。
- 把引用循环导致的缓慢攀升当成正常增长——注意锯齿状形态。
常见问题
CUDA out of memory 但显存还有剩余是怎么回事?
大概率是 Caching Allocator 碎片化。Reserved 申请了大块显存,但内部块无法满足新请求。解决办法是开启 expandable_segments:True,或重启进程释放碎片,观察是否改善。
训练跑到一半才 OOM 是什么原因?
通常是引用循环导致显存泄漏,Python 的周期 GC 只能被动回收,建议开启 Memory Snapshot 抓取攀升段的调用栈,定位未释放的 Tensor。
PyTorch memory snapshot 怎么用?
用 torch.cuda.memory._record_memory_history() 开启记录,在运行时导出快照,然后在官方 memory_viz 页面加载,即可查看分配时间线和调用栈。
显存泄漏怎么定位?
最直接的办法是生成两段 Memory Snapshot,间隔几个 step,对比未释放的 Tensor 调用栈,找出引用循环所在。
PYTORCH_CUDA_ALLOC_CONF expandable_segments 有用吗?
有用,但只解决碎片化问题。它利用 VMM 动态扩展显存段,减少分段碎片,但当权重或激活物理超量时依旧会 OOM,不能当作万能开关。
以上就是完整的 GPU Out of Memory显存溢出解决方法闭环。先按清单跑完 Memory Snapshot 排查,确认瓶颈类别后再决定是改代码还是换卡型;需要做卡型对照时可用 NexGPU 按量资源短时验证,避免直接长期扩卡。



评论(0)