 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
账单比预估高一大截时,先别急着换卡或换平台。绝大多数情况下单价没有变(NexGPU 下单时的单价会锁定到实例销毁为止),多出来的钱来自三个地方之一:停机但没销毁、仍在按容量收的存储、开着机却没在算的 GPU 时间、反复走公网的数据传输。
排查顺序建议按"隐蔽程度"来,而不是按金额:先看存储(最容易被忘掉)、再看算力空转、最后看流量。规格是否选大了放在最后判断,因为那需要先知道任务真实的显存占用。
第一步:把账单拆成三项,看哪一项不对劲
不知道钱花在哪,后面所有优化都是猜。NexGPU 的账单只有算力、存储、流量三项,先看每一项的绝对值和你的预估差多少,差得最多的那一项就是排查入口:
- 算力项压倒性地高:多半是空转挂机,或者卡选大了;
- 存储项莫名其妙有一笔:大概率有停机没销毁的实例,或者磁盘扩容后没缩回来;
- 流量项明显:在重复从公网拉大文件,或者频繁往外传结果。
这里有个前提要说清楚:计费口径是各家平台自己定的,字段名、计量粒度、哪些动作触发收费都不一样,别拿别家的规则套自己在用的平台。本文按 NexGPU 的口径写(按小时计费、按秒计量,三项分开计),你要核对完整口径可以看计费说明。
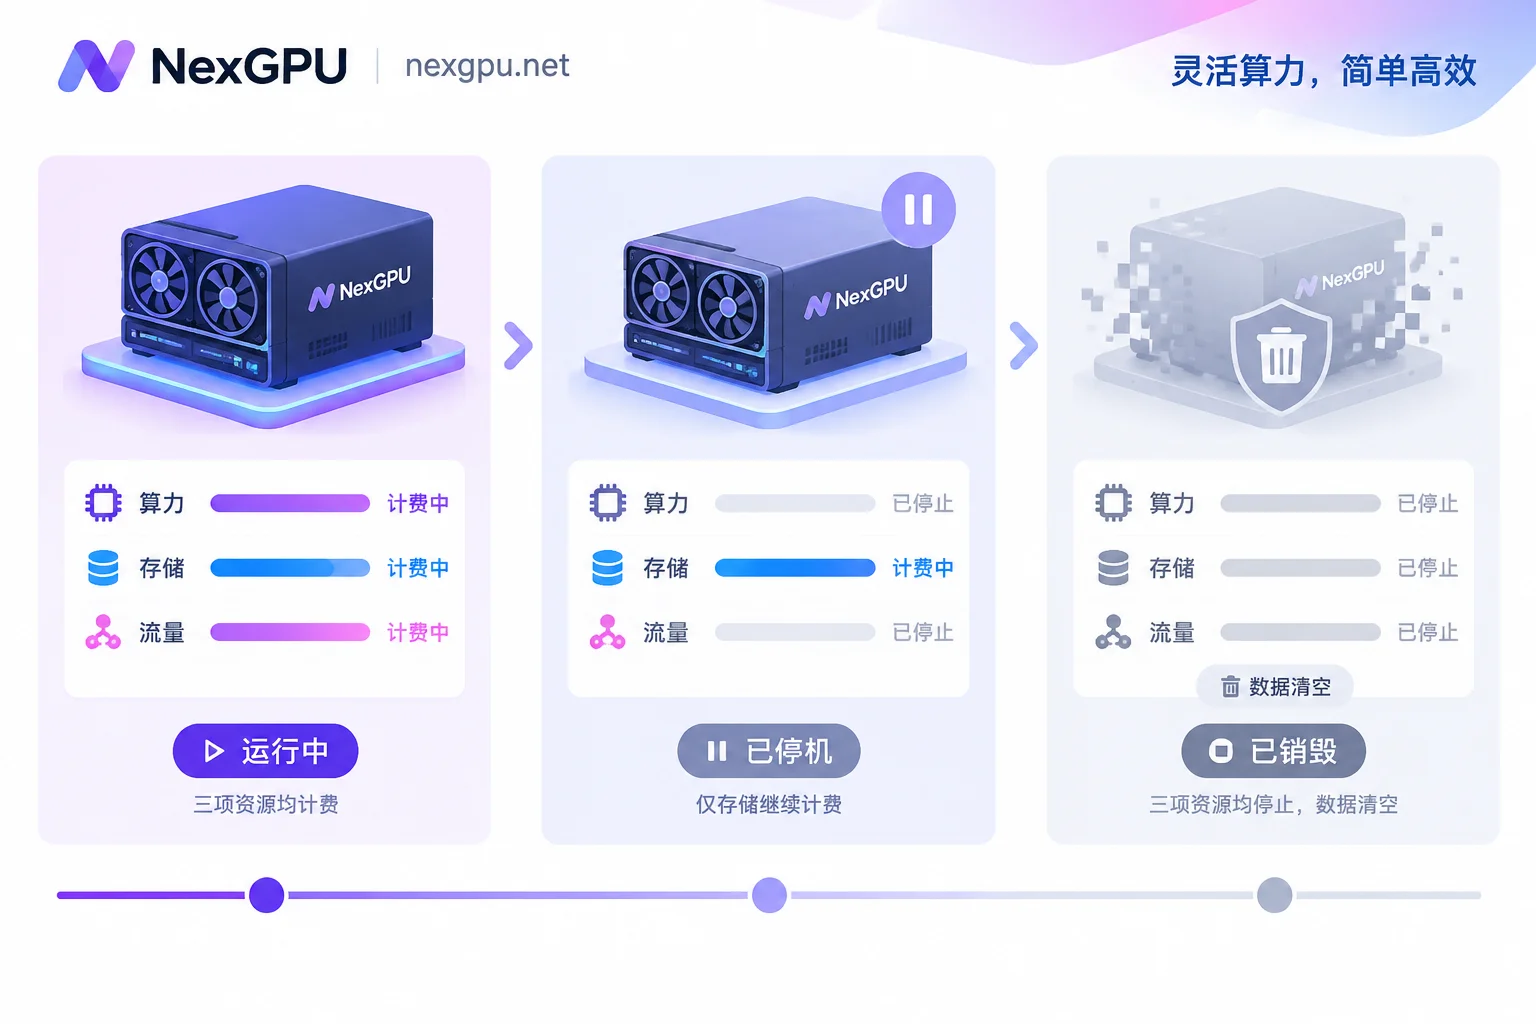
存储:关机只停了算力,盘还在收钱
这是被问得最多、也最容易多花钱的一项。现在的 GPU 云基本都是计算节点和存储卷分离的架构:你点"关机/停止",停的是计算部分的小时计费,系统盘和数据盘仍然占着物理存储,会按分配的容量继续计费。只有执行销毁(Terminate/Destroy)释放掉实例,这部分才会全部停止。
具体查三件事:
1)把所有实例列出来,包括已停止状态的。 上个月做对比实验开的那三台、试镜像时开了没删的那台,只要还在列表里,盘就在计费。这类"僵尸实例"单台每天不多,攒几台放一两个月就很可观了。
2)看磁盘申请了多大,不是看写了多少。 存储通常按申请配置的容量上限结算,不按实际写入量。你扩到 500G 只用了 80G,账单按 500G 走。扩容过的盘如果不主动处理,会长期产生固定开销。
3)进机器看谁在占空间。 常见的大头是训练中间产生的 checkpoint(尤其是每个 epoch 都存一份的)、HuggingFace 的模型缓存目录、Docker 镜像层缓存、ComfyUI 反复测试生成的高清图和视频。这些清掉之后,磁盘往往能缩回一个更小的档位。
判断该不该销毁时,关键问题是数据还要不要。销毁是不可逆的,盘里的东西会一起清空,所以正确顺序是先把要留的数据移出去,再销毁,而不是留着一台机器当仓库用。这两件事的边界可以看这两篇:GPU 实例关机还收不收费、租的 GPU 实例数据怎么保存。想核对存储费的具体算法(容量乘时长),看云GPU存储费怎么算。
算力:平台算的是你独占卡的时间,不是利用率
第二个大头。计费按实例开机独占硬件的物理时长走(NexGPU 是按秒计量),GPU 利用率是 0% 还是 100%,价格一样。所以钱花掉但没产出的场景很具体:
- 训练脚本凌晨两点跑完,你早上九点才起来关机,中间七个小时全额付费;
- 开着 Jupyter 或 SSH 调试,中途去开会、吃饭、下班,终端一直挂着;
- 推理服务部署上去做演示,演示完没人调用,服务还在待命;
- 下载权重、装依赖、编译环境这些不吃 GPU 的活儿,在一张高端卡上慢慢做。
怎么确认:跑 nvidia-smi 看当前利用率和显存占用;更直接的办法是把任务日志里记录的实际结束时间,和你关机的时间对一下,差值就是白付的钱。
对应做法也很直白。长任务在脚本末尾直接接关机或销毁命令,别指望自己记得;调试和跑正式任务分成两个阶段,调试用便宜的卡把流程跑通,正式跑再开目标卡;装环境这一步尽量用现成的镜像模板省掉,选模板的思路见云 GPU 镜像模板怎么选。
流量:重复搬运大文件才会出现明显费用
流量项平时不显眼,一旦冒头基本是这几种情况:每次重建实例都重新从公网拉一遍几十 G 的模型权重(没有做本地持久化)、在不同区域之间同步大数据集、把整个输出目录原样打包传回本地。
处理办法是减少重复搬运:权重和数据集下载一次后落到持久盘,后续实例挂载复用;结果只传需要的文件,视频和图片先压缩或抽样;能在机器上直接看的结果(比如通过 SSH 隧道开 Jupyter 预览)就别整包下载。
最后判断:卡是不是选大了
前面三项都查过还是觉得贵,再回头看规格。典型的过配是:跑 7B/8B 这类轻量推理却开了多卡高端集群;只是验证流程能不能通,就直接上了训练级配置。
压成本的方向有两个——用量化版本降低显存门槛,或者换成刚好够用的单卡甚至消费级卡。但这里要谨慎:显存不够导致的失败重跑、频繁 OOM 反而更贵,所以别凭感觉往下压,按模型的实际显存门槛来定。各个模型该配哪张卡,官网的模型选卡指南按模型列了对应关系,推理场景的显存与带宽取舍可以看大模型推理 GPU 怎么选。
下一轮开机前,把这几件事定下来
排查是补救,真正省钱的动作发生在开机之前:
- 开机前先估时长:这次任务大概跑几小时,心里有个数,超出就去查是不是卡住了;
- 任务一结束就销毁:要留的数据提前定好去处,销毁前移走,别用"先停机放着"代替归档;
- 磁盘按需申请:宁可后面扩,不要一上来就开一个用不满的大盘;
- 给每台长期存在的实例一个理由:如果说不出它为什么还要留着,那它就是在纯花钱。
按这个顺序走一遍,多出来的钱通常能定位到一两个具体的实例或一个具体的习惯上。如果核对完发现是卡型和时长本身不合适,可以到价格与可租节点页按当前需求重新选一次配置——按小时计费、没有最低消费和合约,换配置的成本本身是可控的。



评论(0)