 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
对于大多数研发团队和独立开发者来说,“大模型训练”在过去很长一段时间里几乎等同于做一轮 LoRA 指令微调(SFT)。但到了 2026 年,行业落地的标准流水线已经发生了明显变化:开源基座模型本身已经足够聪明,真正拉开业务差距的,变成了领域持续预训练(CPT)与强化学习后训练(Post-Training,如 DPO、GRPO 与基于可验证奖励的 RLVR)。
随之而来的硬件痛点非常直接:为什么之前能顺畅跑通 7B 或 32B 模型 SFT 的显卡,一换成 DPO 或 GRPO 训练就立刻触发 OOM(显存溢出)? 当训练任务在“高吞吐采样(Rollout)”和“高计算反向传播”之间反复横跳时,大模型训练 GPU 到底该怎么选?
如果之前已经了解过常规微调的选卡逻辑(可参考本站《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》),本文将更进一步,专门算清 2026 年主流后训练与持续预训练的显存账,并给出从单卡验证到多卡整机节点的实操方案。
一、 为什么按 SFT 的标准选卡,跑后训练一定会爆显存?
在传统的监督微调(SFT)中,显存主要被四部分占据:模型权重(Weights)、梯度(Gradients)、优化器状态(Optimizer States)以及前向激活值(Activations)。以 BF16 混合精度配合 AdamW 优化器为例,全参数训练每 1B 参数大约需要 16GB 的基础显存(2 字节权重 + 2 字节梯度 + 12 字节优化器状态),外加根据序列长度变化的激活值。
然而,进入后训练阶段(无论是偏好对齐还是推理能力强化),显存方程里多出了两个“吃显存大户”:
- 冻结的参考模型(Reference Model)副本
无论是 DPO 还是以 DeepSeek-R1 路线为代表的 GRPO(Group Relative Policy Optimization),为了防止策略模型(Policy Model)在优化过程中偏离基座太远(计算 KL 散度惩罚),往往需要在显存中额外驻留一份冻结的参考模型权重。如果是全参数训练,这直接让静态权重的显存占用翻倍。 - 在线采样缓冲区与 KV Cache(Rollout Buffer)
GRPO 虽然省去了传统 PPO 算法中独立的价值模型(Critic/Value Model),但它需要针对每个提示词(Prompt)实时生成一组(例如 $G=4 \sim 16$ 个)完整的回答序列来进行组内相对奖励对比。这意味着在训练循环的生成阶段,GPU 必须同时承担类似高并发长文本推理的 KV Cache 开销。尤其在训练数学、代码或 Agent 慢思考推理模型时,单条思维链(CoT)动辄数千甚至上万 Token,采样阶段的显存峰值很容易直接冲垮按 SFT 预算准备的机器。
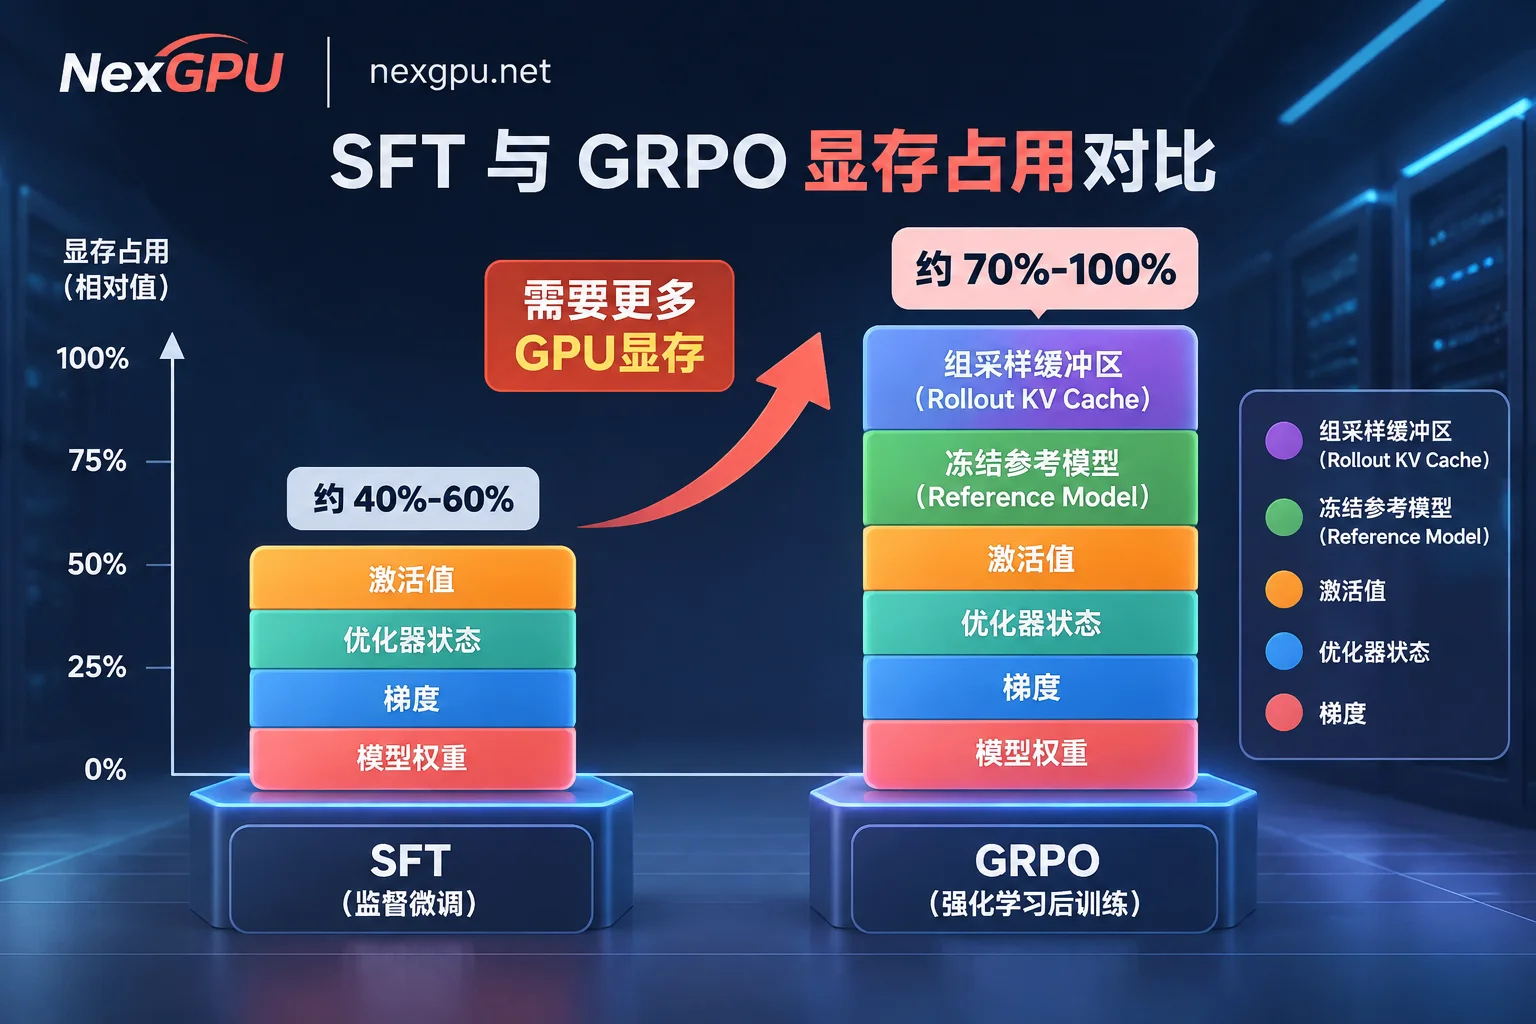
三大主流训练阶段的硬件瓶颈对比
为了在选卡时不踩坑,我们可以把当前主流的三类大模型训练任务按硬件负载特征拆开来看:
| 训练阶段与方法 | 显存占用核心组成 | 硬件核心瓶颈 | 典型适用场景 |
|---|---|---|---|
| SFT(监督微调) | 策略模型状态 + 激活值 | 显存容量(VRAM) | 格式规范、特定语气、基础指令遵循 |
| DPO / 偏好对齐 | 策略模型 + 参考模型(或 Adapter 切换)+ 成对长序列激活 | 显存容量 + 显存带宽 | 人类偏好对齐、减少幻觉与拒答控制 |
| GRPO / RLVR 后训练 | 策略模型 + 参考模型 + 组采样 Rollout KV Cache | 显存容量 + 显存带宽(采样期)+ 算力(更新期) | 数学、代码、逻辑推理、AI Agent 工具调用优化 |
| CPT(持续预训练) | 全量模型状态 + 大 Batch 激活值 | 峰值 FP16/BF16 算力 + 多卡高速互联带宽 | 医疗、法律、金融或小语种等海量领域语料注入 |
二、 2026 大模型训练 GPU 选型矩阵:从单卡验证到多卡整机
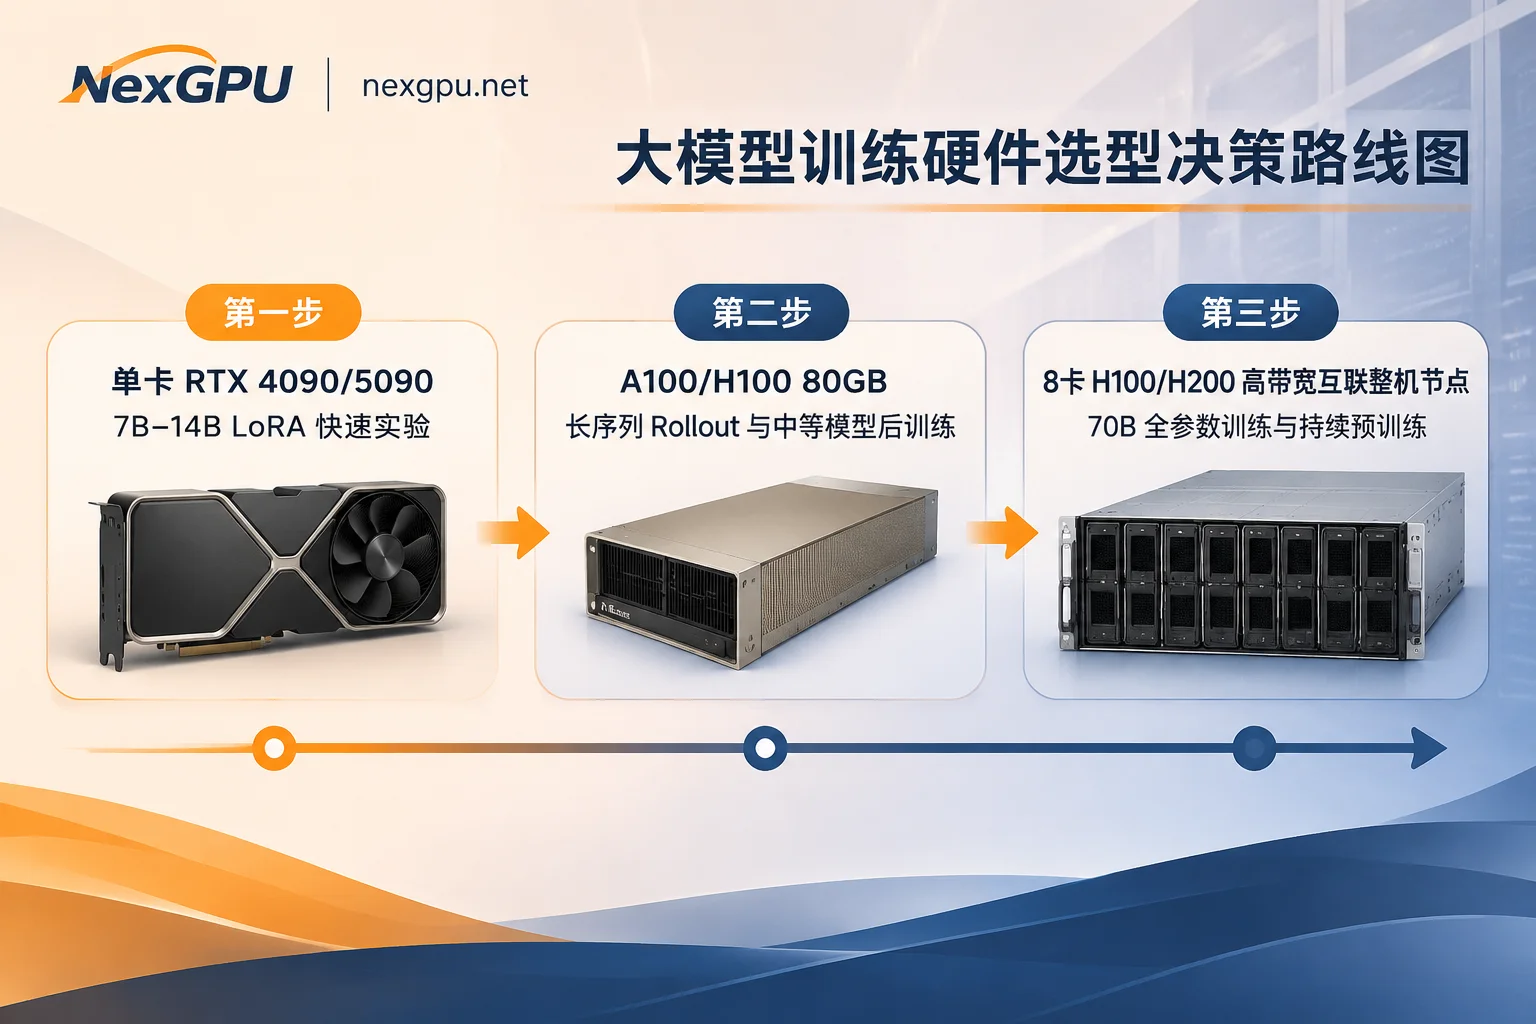
弄清了显存去向,选卡就不再是盲目堆砌硬件,而是根据“参数规模 × 训练方法”精确匹配。在 NexGPU 的 GPU 算力市场中,消费级显卡与数据中心级显卡分开列价,每一行代表一台真实可租的物理机器。以下是针对不同训练规模的选卡建议:
1. 小尺寸模型(7B ~ 14B)的 LoRA / QLoRA 后训练与实验
- 推荐显卡:单卡或双卡 RTX 4090 / RTX 5090(消费级高性价比)
- 为什么这么选:在使用 Unsloth 或 TRL 配合 LoRA/QLoRA 跑 GRPO 时,策略模型与参考模型可以共享同一份量化后的基座权重(只需在计算参考概率时临时禁用 LoRA Adapter),从而省去独立的参考模型显存开销。此时,24GB 到 32GB 级别的单卡显存足以容纳 7B~8B 模型的 4-bit 基座与中小长度的 Rollout 采样缓存。
- 适用对象:验证 Reward 函数设计是否合理、调试数据集格式、个人开发者低成本跑通后训练闭环(关于单卡 4090 的边界,可延伸阅读《RTX 4090云服务器怎么租:24GB显存的能力边界、选卡防坑与单卡向多卡平滑扩容指南》)。
2. 中大尺寸模型(14B ~ 32B 全量 / 70B LoRA)与长思维链强化学习
- 推荐显卡:单卡或 2~4 卡 A100 (80GB) / H100 (80GB)
- 为什么这么选:当模型参数来到 14B~32B 且需要全参数后训练,或者在 7B 模型上开启极长上下文(如 16K~32K CoT 采样)时,消费级显卡的 24GB/32GB 显存和显存带宽会迅速见底。更关键的是,GRPO 训练的时间往往有相当大比例消耗在自回归生成(Rollout)阶段——而自回归生成是典型的显存带宽受限(Memory-Bandwidth Bound)任务。A100 与 H100 的高带宽 HBM 显存能大幅缩短每一步 Rollout 的等待时间(具体型号对比可参考《2026年A100租用指南》与《2026年H100租用实战指南》)。
3. 全参数后训练(32B ~ 70B+)与领域持续预训练(CPT)
- 推荐显卡:4 卡 / 8 卡 H100 / H200 / B200 多卡整机节点
- 为什么这么选:以 7B 全参数 GRPO 为例,仅权重、梯度、优化器状态加上冻结参考模型就要吃掉约 140GB 显存,这还没算激活值和采样缓存;若是 32B 或 70B 全参数训练,必须依赖 DeepSpeed (ZeRO-2/ZeRO-3)、FSDP 或 Megatron 将模型状态切分到多张卡上。在这种高频跨卡通信场景下,卡间互联带宽决定了算力利用率。选择高显存(如 H200 的 141GB 显存)的多卡整机节点,不仅能减少跨卡切分的通信次数,还能留出充裕的显存空间给大 Batch Size,避免频繁触发 ZeRO-3 权重收集带来的通信停顿。
三、 在 NexGPU 上跑通大模型训练的四个工程实操细节
选定目标显卡型号后,在实际租用和跑训练任务时,硬件配置、环境搭建与账单管理直接决定了研发效率。结合 NexGPU 的平台特性,建议按以下四步落地:
1. 按“最少卡数 + 显存 + 带宽”精确筛机
在 GPU 市场选机器时,每一行都是一台真实可租的设备。做分布式训练切忌拼凑零散单卡,应当直接使用筛选器中的最少卡数(如 4 卡或 8 卡)、显存大小、地区与可靠性进行过滤。多卡节点采用整机出租模式,下单金额直接等于“单卡价 × 卡数”,并且算力单价与磁盘单价分开标出,账目一目了然。如果拿不准具体硬件指标,也可以先查阅官方的选卡文档或模型选卡指南(例如直接查看 Qwen 系列选卡与部署步骤)。
2. 用预置微调镜像或自定义 Docker 锁定 CUDA 环境
大模型训练框架(尤其是掺杂了 FlashAttention、vLLM 采样加速引擎以及 DeepSpeed 的后训练框架)对 CUDA 和 PyTorch 版本极其敏感。
- 快速开箱:在 镜像模板库 的“训练与微调”分类下,平台直接预装了 PyTorch、TensorFlow、JAX 以及主流开源微调套件 LLaMA Factory、Axolotl、Unsloth。驱动、CUDA 与基础依赖均已配好,先选定镜像模板再筛机器时,显存不够的机器会被自动标出并注明原因,防止误租。
- 严苛环境复现:如果团队的训练代码深度绑定了特定版本的 CUDA 或底层通信库,建议直接填写自己的 Docker 镜像(支持公开或私有仓库),并自定义启动命令与环境变量,彻底告别每次开机重新编译环境的折腾。
3. 创建实例时一次算足 NVMe 磁盘空间
这是训练任务中最容易踩的工程坑之一:实例创建后不支持在线扩容磁盘。而在大模型训练中,一个 70B 模型的 FP16 Checkpoint 就接近 140GB,如果开启了保存优化器状态用于断点续训(Resume),单个 Checkpoint 体积会膨胀数倍。因此在开机配置存储时,务必根据“基座权重 + 数据集 + 保留 Checkpoint 数量 × 单次体积”留足余量,并在训练脚本中设置 save_total_limit 定期清理旧权重。
4. 直连调试与多节点企业级扩展
实例拉起后,无需经过繁琐的跳板机,开发者可以直接通过带令牌的一键 Jupyter、浏览器网页终端或公网 IP SSH 直连进入容器,甚至可以一键安装 aaPanel 可视化面板管理训练文件与进程(详见实例连接指南与实例管理文档)。如果研发团队要从单机多卡走向跨机多节点集群,需要 RDMA 高速互联、数据隔离、私有网络,或是走企业合同、PO 采购与对公付款开票,可直接联系销售团队定制专属算力集群(更多集群构建思路可参考《从小规模尝试到万卡算力:如何低门槛构建弹性GPU集群?》)。
四、 算力成本精算:如何利用“停机保盘”省下 50% 以上的冤枉钱?
大模型训练从来不是“一键启动直到结束”的线性过程。在实际研发中,大量时间会被花在:清洗和转换 JSONL 数据集、修改 Reward 奖励函数代码、排查 Loss 突刺(Loss Spike)、以及对阶段性 Checkpoint 做人工抽样评测上。
如果租用固定包月服务器,或者在调代码时让 8 张 H100 空转等待,算力预算会以惊人的速度蒸发。
在 NexGPU 的计费规则下,账单严格拆分为算力、存储、流量三项,没有最低消费、开通费或起租时长限制,且下单时的单价会一直锁定到该实例销毁为止:
- 调试代码与洗数据时:果断“停机保盘”
算力费按秒计量、按小时计价,只在实例处于“运行中”时收取。一旦发现 Reward 逻辑需要重写,或者需要花几个小时分析评测结果,直接在控制台点击停机。停机后算力计费立即停止,只按 GB/月收取极低的磁盘存储费,环境、数据集和跑了一半的 Checkpoint 完好保留,改好代码随时再次启动。 - 用单卡做 Pipeline 冒烟测试,再用多卡跑正式全量训练
由于平台不限制同时开启的实例数量(仅受账户余额约束),团队可以先开一台廉价的单卡实例把数据加载和训练循环跑通 10 个 Step,确认不会报语法或维度错误后,再拉起 8 卡 A100/H200 节点全速跑完正式 Epoch。 - 阶段性任务完结:及时传走权重并销毁实例
需要特别注意的是,平台采用独占容器设计,不读取也不自动备份用户磁盘内容;且停机状态下存储费依然照收,只有销毁实例(需输入实例编号二次确认)才会立即释放磁盘并停止全部计费。因此,当整轮训练收尾,务必先将最终的模型权重或 LoRA Adapter 同步到外部对象存储或私有仓库,确认无误后销毁实例,让每一次训练的成本都精确收敛在有效计算时间内。
想要查看当前各型号显卡的实时库存与单价,现在就可以通过邮箱免实名注册,前往 NexGPU 价格页面 或浏览 AI 微调与训练场景方案,开启你的下一轮大模型训练任务。


