 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
2026 年的算力市场正在经历一场明显的结构变化。一方面,企业级 AI Agent 落地、长上下文大模型推理与多模态视频生成将推理和微调的算力需求推向新高,行业机构与科技巨头纷纷预警算力供需缺口持续扩大;另一方面,硬件代际的更替让租卡时的选择比往年更加丰富——消费级市场里 32GB 显存的 RTX 5090 已经成为单卡热门,而数据中心级市场上,除了 A100、H100,更大显存与带宽的 H200、B200 也已进入按需租用列表。
与此同时,算力行情的短期波动与传统云厂商复杂的资质审核、配额排期,让越来越多的个人创作者、独立开发者和研发团队转向按小时计费的分布式 GPU 算力市场。但面对几十种显卡型号、不同的计费规则和环境配置,怎样才能不花冤枉钱、不卡在环境依赖上?
这篇指南把 GPU租用 拆解为“定需求选卡—筛机器配环境—连实例跑任务—管生命周期控成本”四个阶段,帮你建立一套直接落地的操作框架。
一、 先看显存与场景:消费级与数据中心级显卡怎么分界?
租用 GPU 的第一步不是比单价,而是算清任务的显存底线和通信需求。很多新手容易犯两个极端错误:要么为了跑一个 7B 量化模型去租高价的数据中心卡,造成算力闲置;要么用单张 24GB 的消费级显卡硬扛全参数微调或超长上下文高并发推理,结果频频触发 OOM(显存溢出)中断任务。
在 NexGPU GPU 市场 中,消费级显卡与数据中心级显卡分开列价,各自对应明确的业务边界:
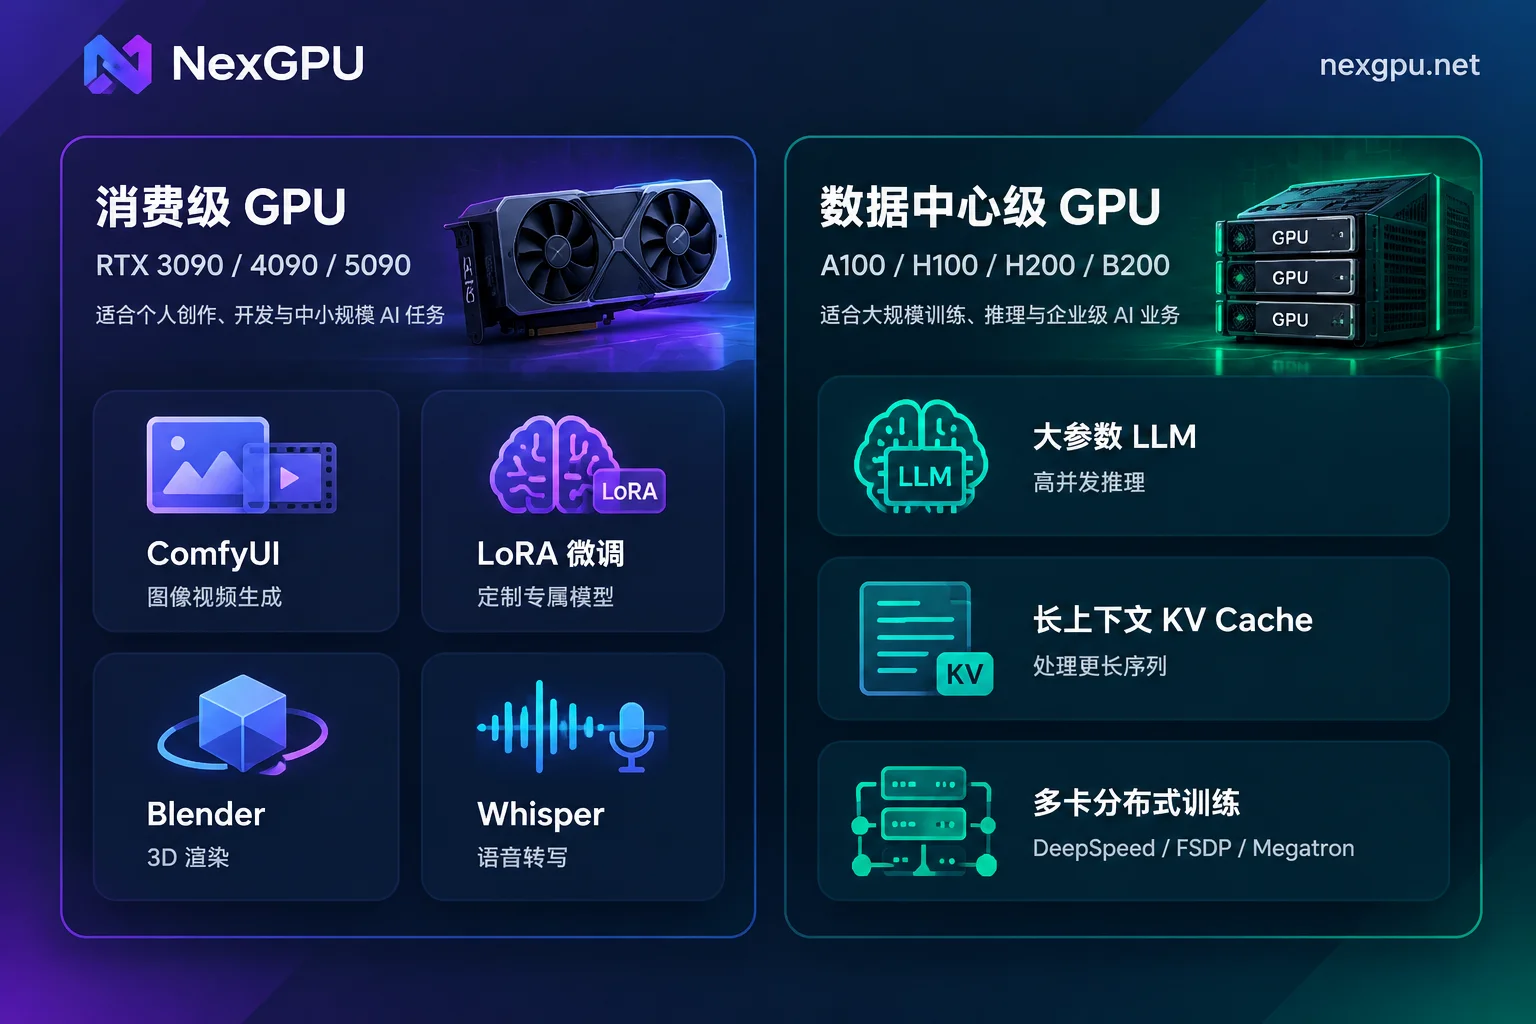
1. 消费级显卡(RTX 3090 / RTX 4090 / RTX 5090 等)
这类显卡单卡性价比高,适合单卡能装下、或者对多卡高速互联要求不苛刻的任务:
- AI 图像与视频生成:用 ComfyUI 或 AUTOMATIC1111 跑 SDXL、FLUX 出图,或是跑视频扩散模型抽卡(具体可参考《AI视频生成GPU怎么选:从ComfyUI量化抽卡、全精度出片到LoRA训练的选卡指南》)。
- 中小模型推理与轻量化微调:利用 Unsloth、LLaMA Factory 做 QLoRA/LoRA 微调,或者用 Ollama、vLLM 部署量化后的开源模型。其中 RTX 5090 凭借更大的显存和新一代架构,在处理中等参数模型的 4-bit 量化推理或 LoRA 训练时,比 24GB 显存的 RTX 4090 留出了更宽裕的 KV Cache 和 Batch Size 余量(若想了解何时该升级显卡,可阅读《消费级显卡什么时候不够用:四条越界信号和换卡的判断口径》)。
- 3D 图形渲染与语音处理:Blender、V-Ray 等多台实例分段并行渲染(详见《GPU云渲染怎么选方案和显卡》),以及 Whisper、faster-whisper、WhisperX 批量音频转文字(详见《Whisper部署怎么选方案和GPU》)。
2. 数据中心级显卡(A100 / H100 / H200 / B200 等)
当单卡显存突破 32GB/48GB 门槛,或者进入生产级高吞吐推理与大规模分布式训练时,就需要切换到数据中心级显卡:
- 大参数模型与长上下文高并发推理:70B 乃至更大参数的模型、MoE 架构模型,或者需要承载极长上下文与高并发请求的在线 API 服务。H200 与 B200 提供超大显存容量与极高的显存带宽,能显著减少张量并行(TP)拆分的卡数,降低首字延迟并提升解码吞吐。
- 多卡全量微调与预训练:使用 DeepSpeed、FSDP 或 Megatron 进行多卡并行训练(选卡逻辑可参考《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》)。
如果你不确定手头的开源模型具体要占多少显存,不用自己手算权重和激活值,可以先查 NexGPU 模型选卡指南。里面涵盖了文本大模型(如 Qwen 选卡与部署步骤)、图片生成、视频生成、语音识别与合成、OCR、数字人、3D 生成及 AI Agent 等十几个品类,逐一写明了主流模型当前版本、量化后的显存门槛以及推荐显卡;也可以在 场景做法页 按业务类型直接查看推荐的卡型、镜像和大致开销。
二、 筛机器与配环境:避开算力不透明与配环境的耗时坑
在传统的租卡流程里,用户经常遇到两类麻烦:一是只看每小时算力标价,开机后才发现磁盘、网络带宽或环境配置还要额外收费,或者机器网络质量满足不了拉取几十 GB 权重的需求;二是拿到一台裸机后,光装驱动、配 CUDA、解决 PyTorch 与依赖库版本冲突就花掉两三个小时,白白消耗算力费。
在按台租用的算力市场中,这两个环节可以通过前置筛选和镜像模板在开机前一次性解决(详细筛选说明见 如何选择 GPU 文档):
- 看清真实机器参数与分项单价
在 GPU 市场 中,每一行都代表一台真实可租的物理机器节点。你可以直接按显存大小、价格、所在地区、可靠性、网络带宽、最少卡数进行过滤。每台机器都会把“算力单价”和“磁盘单价”分开标出;如果需要租用多卡节点,平台按整机出租,下单金额直接等于“单卡价 × 卡数”,账目一目了然。 - 先选环境再筛卡,自动防呆
如果你先选定了运行环境或目标模型再去筛机器,系统会自动检测硬件条件——显存不够的机器会被直接标出并注明原因,防止出现“开机拉完权重才发现显存报错”的尴尬。 用预置镜像或自有 Docker 镜像省去搭建时间
进入 镜像模板库,所有模板均不分档且无额外授权费,预装好驱动、CUDA 和对应框架,开机即用:- 大模型推理:预置 vLLM、TGI、Ollama、SGLang,拉起后直接提供 OpenAI 兼容接口。
- 训练与微调:预置 PyTorch、TensorFlow、JAX 以及 LLaMA Factory、Axolotl、Unsloth。
- 图像视频、语音与数据:包含 ComfyUI、AUTOMATIC1111、Whisper 全家桶、RAPIDS 与 Jupyter,以及纯净的 Ubuntu + CUDA 环境。
- 自定义 Docker 镜像:如果你的项目代码严格锁定了特定的 CUDA 小版本或私有依赖,官网建议直接填写你自己的 Docker 镜像(支持公开或私有仓库),并自定义启动命令和环境变量。
三、 开机与连接:从无门槛注册到直连实例
很多突发性的实验、短期渲染或紧急微调任务,最怕卡在平台繁琐的实名认证、企业资质审批和 GPU 配额申请上(关于不同平台的准入规则对比,可参考《租 GPU 要不要实名认证和配额申请?按平台类型分三种情况》)。
为了缩短从“有算力需求”到“跑起代码”的路径,NexGPU 将注册与连接流程做了极简化处理(新手可对照 快速上手指南 操作):
- 免实名与免绑卡看价:仅需邮箱即可完成注册,不需要实名认证,也不用提交配额申请。注册后无需绑定支付方式就能查看所有节点的实时价格;充值支持支付宝和 USDT(TRC20),同时开启的实例数量没有硬性上限,仅受账户余额约束。
三种直接连接方式:实例启动后,你可以根据习惯选择连接方式(详见 连接实例文档):
- 网页终端:直接在浏览器里打开具有 root 权限的终端,适合快速执行命令或查看状态。
- SSH 直连:每台实例分配公网 IP 加映射端口,不经过跳板机,支持设置默认公钥,方便直接用本地 VS Code Remote-SSH 或 Cursor 连接开发。
- Jupyter 一键打开:所选镜像带 Jupyter 时,点击即可在浏览器进入,访问令牌已自动带好。
- 端口与可视化管理:除了默认连接端口,每台实例还预留了一组备用端口,方便你对外暴露自己部署的 WebUI 或推理 API 服务;如果不习惯纯命令行管理大文件,还可以一键安装可视化管理面板(aaPanel),在浏览器里直观管理文件、进程与计划任务(注意面板本身会占用一部分磁盘空间)。
四、 账单透明与生命周期管理:把每一分预算花在刀刃上
2026 年不少用户在复盘算力开支时发现,账单超支往往不是因为显卡单价贵,而是栽在了“隐性杂费”和“忘记关机/未释放存储”上。因此,理解计费规则与实例状态切换是控制 GPU 租用成本的核心(此前我们也专门写过《GPU 租用账单太高怎么排查:按算力、存储、流量三项逐条对账》)。
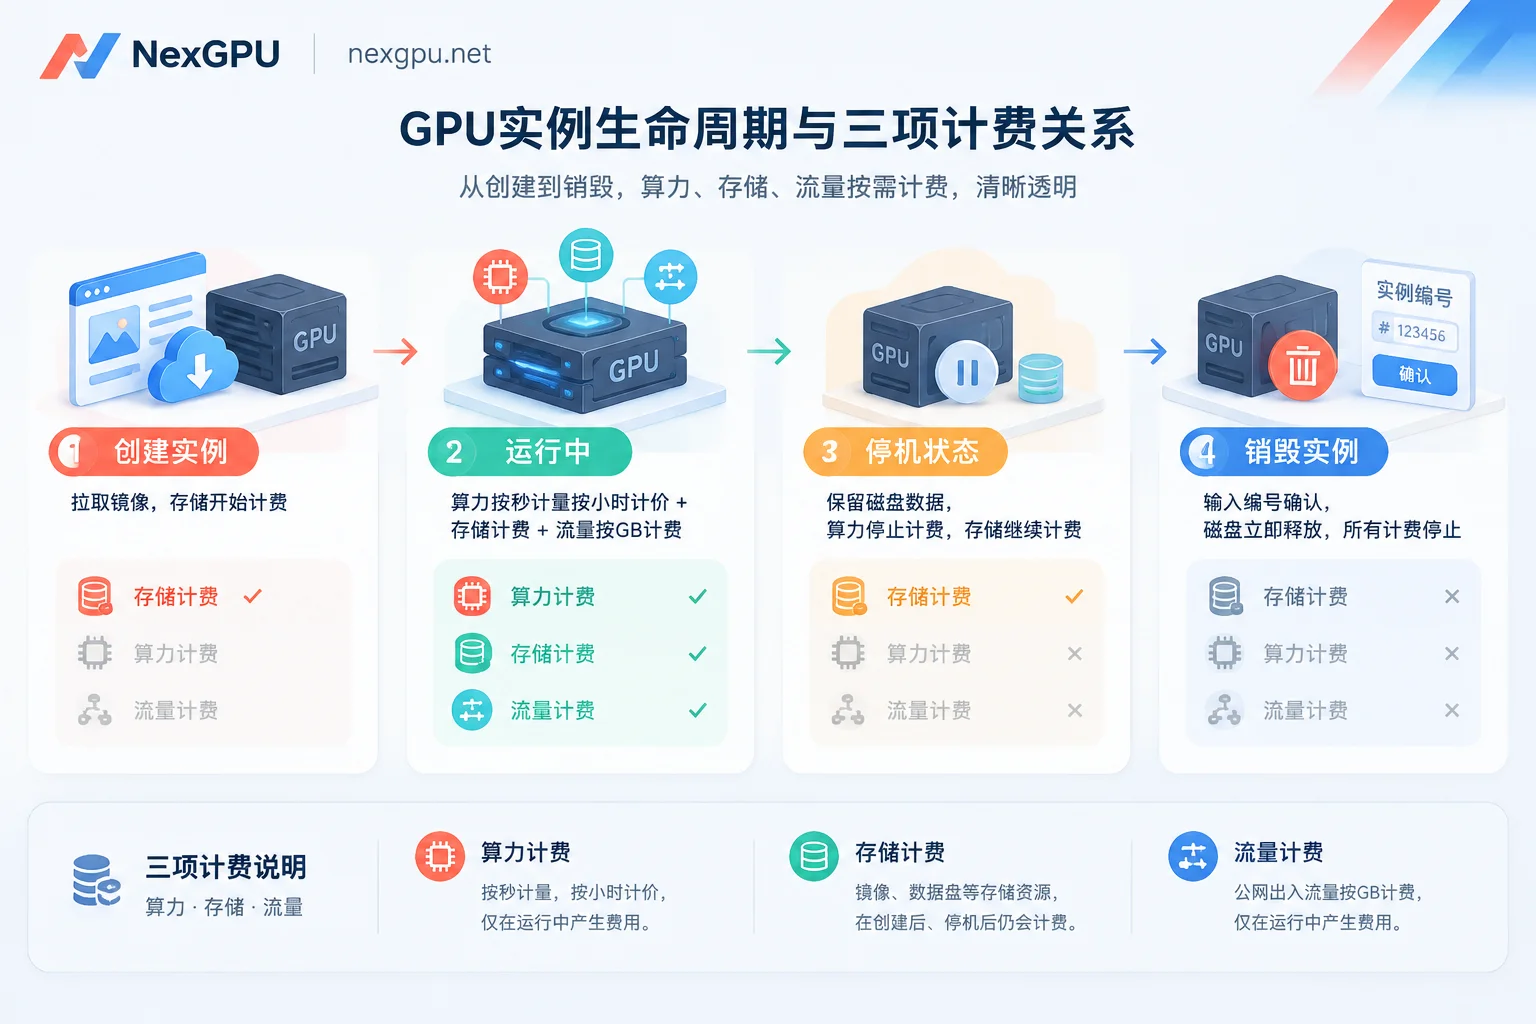
在 NexGPU 计费规则 下,费用结构与实例管理有几条必须掌握的铁律:
1. 账单只有三项,下单锁价
实例详情页的费用明细只包含算力、存储、流量三项。没有任何最低消费、开通费、端口映射费或镜像授权费,也没有起租时长限制。更重要的是,下单时的单价会一直锁定到该实例销毁为止,即便租用期间外部算力市场价格波动,你正在运行的实例也不会临时涨价。
2. 分清“停机”与“销毁”的计费差异
- 算力费:按秒计量、按小时计价。从实例进入“运行中”状态开始计费,只要执行停机或销毁,算力费立即停止。
- 存储费:按 GB/月计费,从实例创建时(包含拉取镜像期间)起算。需要特别注意:停机状态下,为了替你保留磁盘和环境数据以便随时再次启动,存储费是照常收取的;只有当你确认任务彻底结束、执行销毁操作后,磁盘立即释放,存储计费才会停止。
3. 注意使用边界与数据安全
每台实例都是独占容器,平台不读取但也不备份你的磁盘内容。同时,平台不支持创建后动态扩容磁盘或增删端口映射,销毁实例时需要输入实例编号确认,一旦销毁磁盘立即释放且不可恢复。因此:
- 创建实例前,请预估好模型权重、数据集和 Checkpoint 所需的磁盘空间一次给足。
- 余额偏低时系统会发送预警邮件;若余额耗尽,实例会先自动停机(不销毁),留出充值恢复的缓冲期,只有负余额超过设定时长才会自动销毁。
- 决定销毁实例前,务必把训练好的权重、渲染成片和关键日志同步回本地或外部对象存储(更多细节见 实例管理文档 与 常见问题 FAQ)。
五、 多卡节点与企业级需求:从自助下单到专属集群
如果你的需求不止于单卡开发,而是研发团队要评估多卡训练效率,或者算力采购需要稳定的长期供给,租用策略也可以分两步走:
- 多卡节点自助验证:在 GPU 市场直接按“最少卡数”筛选 2 卡、4 卡或 8 卡的 A100、H100、H200 等高显存节点,自助下单测试 DeepSpeed、FSDP 或 Megatron 并行跑通情况。
- 企业定制与长期方案:当业务进入稳定期,需要 RDMA 高速互联、严格的数据隔离、私有网络或专属算力集群,或者财务流程需要预留实例、包月包年、专属算力池、签订合同、对公付款与开票、PO 采购时,可以准备好需求清单(参考《企业GPU集群和预留实例怎么咨询:先备好这份需求清单再联系》),直接通过 联系销售页面 或双语客服对接。
无论你是第一次租卡跑 ComfyUI 和开源模型的新手,还是日常与显存、吞吐打交道的算法工程师,现在就可以前往 NexGPU 价格与市场页 查看各型号实时可租节点,选好预置镜像,几分钟内拉起你的第一台 GPU 实例。


