 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在准备租用大模型微调GPU之前,许多开发者的第一反应是直接拿“模型参数量 × 字节数”去套显存公式。但在 2026 年的工程实践中,决定你该租 24GB 消费级显卡还是 8×80GB 数据中心节点的,往往不只是模型本身,而是你选用的微调框架与底层算子实现。
如果说我们在《大模型微调GPU怎么选:按显存账、微调方法与开源框架三步定卡》中解决的是基础显存账本的核算,在《2026大模型训练GPU怎么选:从SFT到GRPO强化学习后训练的显存账与多卡成本实操》中拆解的是不同后训练阶段的差异,那么当真正进入动手调优阶段,开发者最常遇到的现实问题是:
- 为什么同样微调一个 8B 稠密模型或 20B/30B MoE(混合专家)模型,有人用单张 RTX 4090 几个小时就跑完了,有人租了 A100 却频频触发 OOM(显存溢出)?
- Unsloth、LLaMA Factory、Axolotl 这三大主流开源微调框架,各自适合配什么样的 GPU?
- 在按小时计费的算力平台上,怎么利用预置镜像、备用端口和“停机保盘”机制,把清洗数据、调参试错到合并导出权重的总账单压到最低?
本文将从“框架特性 × 硬件边界”的交叉视角,给出一套可直接落地的大模型微调GPU配卡与成本控制指南。
一、 为什么微调框架直接决定了你的 GPU 账单?
在 2026 年的开源后训练生态中,Unsloth、LLaMA Factory 和 Axolotl 底层虽然都依托于 PyTorch 与 Hugging Face 生态,但它们的工程优化重心截然不同,直接改写了不同任务对 GPU 显存和卡间互联的硬件门槛:
- Unsloth(单卡极限压榨与手写内核派):不走标准的 PyTorch 自动求导黑盒,而是用 OpenAI Triton 手写了前向与反向传播内核,在零精度损失的前提下省去了大量冗余梯度缓冲。在单卡场景下,它能带来 2~5 倍的训练加速并削减 40%~70% 以上的峰值显存。尤其在 2026 年大热的 MoE 模型与长上下文(8K~16K)微调中,Unsloth 通过改良的 Split-LoRA 机制避免了在矩阵乘法前将 LoRA 增量在所有专家层上全量物化,使原本在原生框架下必爆显存的任务能轻松塞进单卡。
- LLaMA Factory(零代码可视化与全模型覆盖派):支持 100+ 主流文本大模型与多模态视觉模型(VLM),自带直观的 WebUI(LlamaBoard),点选菜单就能切换 SFT、DPO、GRPO、KTO、ORPO 等多种对齐算法。更实用的是,它支持勾选开启 Unsloth 作为单卡加速后端,同时也能通过命令行调用 DeepSpeed 或 Megatron 跑多卡分布式训练。
- Axolotl(多卡分布式编排与企业级扩展派):通过一份声明式 YAML 配置文件统管全局,原生深度整合了 FSDP2、DeepSpeed ZeRO-3、张量并行(TP)、序列并行与专家并行(EP),并引入了针对 MoE 微调的 SonicMoE LoRA 与 FlashAttention 3/4 等算子优化。当你的任务跨出单卡边界、需要用 4 卡或 8 卡节点跑 30B~70B+ 全量微调或超长序列训练时,Axolotl 的多卡扩展效率远胜单卡工具。
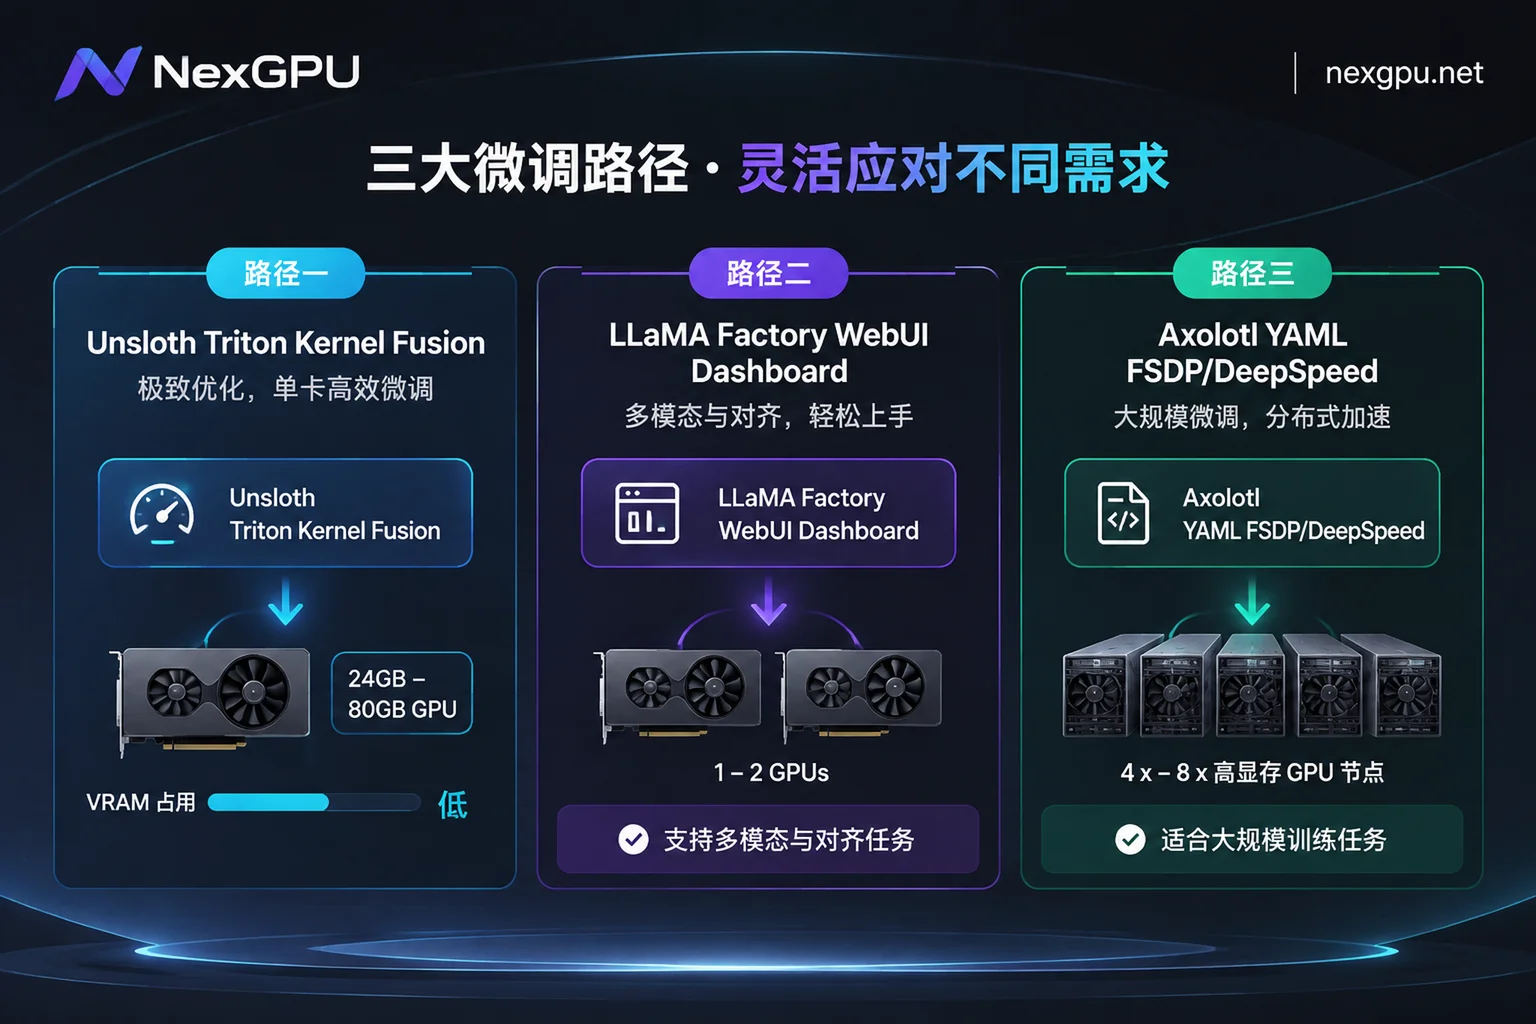
三大微调框架与 GPU 硬件匹配速查表
| 微调框架 | 核心工程优势 | 典型显存与速度表现 | 最优 GPU 配卡方向 | 适用微调场景 |
|---|---|---|---|---|
| Unsloth | 手写 Triton 内核、手动推导反向传播、MoE Split-LoRA 优化、一键导出 GGUF | 8B QLoRA 仅需 6~8GB;70B QLoRA 约 41~48GB;长上下文 MoE 提速最高达 7 倍 | 单卡优先:RTX 3090 / 4090 / 5090,或单卡 A100 / H100 80GB | 个人开发者与中小团队单卡极速 QLoRA/LoRA、长文本指令微调、微调后直接转 Ollama 本地推理 |
| LLaMA Factory | LlamaBoard 可视化界面、覆盖 100+ LLM 与多模态 VLM、对齐算法最全 | 原生 8B QLoRA 约 16GB;开启 Unsloth 后端可大幅降显存并提速 2 倍以上 | 单卡至中小型多卡:RTX 4090 / 5090(1~2 卡),或 A100 80GB | 零代码快速实验、多模态图文微调、频繁对比不同数据集与超参、导出 HF 权重接 vLLM 部署 |
| Axolotl | YAML 配置化驱动、FSDP2 / DeepSpeed ZeRO-3 / 序列并行组合度最高 | 单卡开销略高于 Unsloth,但 4~8 卡线性扩展度好;SonicMoE 节省约 30% 显存 | 多卡整机节点优先:4×/8× A100、H100、H200 或 B200 节点 | 13B~70B+ 全参数微调(Full Fine-Tuning)、企业级大规模语料继续预训练、跨卡长序列训练 |
💡 免配环境提示:在 NexGPU 镜像模板库 的“训练与微调”分类下,Unsloth、LLaMA Factory、Axolotl 以及 PyTorch 均已作为预置模板提供,驱动、CUDA 与核心依赖开机即用,且模板不分档、无任何额外授权费。
二、 按微调任务定卡:三类高频场景的 GPU 选型方案
明确了框架差异后,我们可以在 NexGPU 算力市场 中按“消费级显卡”与“数据中心级显卡”两大序列来精准选卡。平台将每一台真实可租的机器逐行展开,算力单价与磁盘单价分开标明,你可以直接按显存、价格、地区、可靠性、带宽和最少卡数进行筛选。
场景 1:7B~14B 稠密模型 / 中小 MoE 模型的单卡快速微调
如果你的目标是针对垂直行业问答、JSON 结构化输出或代码辅助,对 Qwen、Llama 3.3 或 DeepSeek 蒸馏版等 7B~14B 模型做 QLoRA / LoRA 微调:
- 首选组合:Unsloth 预置镜像 + 单张 RTX 3090 / RTX 4090(24GB)或 RTX 5090
- 为什么这样配最省钱:在 24GB 显存边界内,原生框架跑 8B~14B 模型一旦把上下文拉长到 4K~8K,激活值很容易撑爆显存;而借助 Unsloth 的内核融合与显存优化,不仅 8B QLoRA 显存占用可压到 8GB 以内,多出来的显存还能让你拉大 Batch Size 或开启更长的序列长度,将原本三四个小时的训练缩短到数十分钟至一两个小时内完成。
- 进阶提醒:关于 24GB 显存单卡在训练与推理中的具体能力边界,可以参考我们此前的《RTX 4090云服务器怎么租:24GB显存的能力边界、选卡防坑与单卡向多卡平滑扩容指南》。如果你还不确定手头开源模型的具体版本与量化显存门槛,建议先查阅 NexGPU 模型选卡指南(例如 Qwen 选卡与部署页)。
场景 2:零代码可视化调优、多模态(VLM)微调与多轮对齐实验
当业务团队需要把图文表格数据喂给多模态视觉大模型,或者算法工程师需要在 SFT 之后紧接着对比 DPO、KTO、ORPO 等偏好对齐效果时,手写脚本调试往往耗时费力。
- 首选组合:LLaMA Factory 预置镜像 + 单卡 RTX 5090 / A100 80GB(或 2×RTX 4090 节点)
为什么这样配最省钱:
- WebUI 交互提效:NexGPU 的每台实例除了提供网页 root 终端、免跳板机的 SSH 直连和一键带令牌打开的 Jupyter 外,还自带公网 IP 与端口映射,并额外预留了一组备用端口给用户自己的服务。你可以直接将 LLaMA Factory 的 LlamaBoard WebUI 绑定到备用端口上,在本地浏览器里点选数据集、实时观察 Loss 曲线与评测指标,无需为端口映射支付任何额外费用(详见实例连接文档)。
- 多模态显存留白:多模态微调在处理高分辨率图像 Token 时会产生较大的瞬时激活值,若预算充足,直接租用单张 A100 80GB 可以彻底告别频繁调小
per_device_train_batch_size的烦恼(A100 不同规格的取舍详见《2026年A100租用指南:40GB与80GB、PCIe与SXM怎么选?》)。
场景 3:30B~70B+ 全量微调、中大型 MoE 与长上下文分布式训练
当微调进入深水区——例如对 70B 模型做 16-bit LoRA / 全参数微调,或者对 30B+ 规模的 MoE 模型在 8K~16K 长上下文下做领域知识注入:
- 首选组合:Axolotl(或 LLaMA Factory CLI + DeepSpeed)+ 4卡/8卡 A100 / H100 / H200 / B200 整机节点
为什么这样配最省钱:
- 单卡高显存 vs 多卡并行的拐点:如果只是跑 70B 模型的 4-bit QLoRA,单张 80GB 的 A100 或 H100 配合 Unsloth(峰值显存约 41~48GB)就能在数小时内跑完,单卡租用综合成本最低。但一旦涉及 13B~70B 全量微调(Full Fine-Tuning) 或大规模数据集,单卡不仅装不下优化器状态,训练时长也会拉长到数十小时。
- 多卡节点整机直租:在 NexGPU 价格与市场页 中,你可以直接按“最少卡数”筛选出 4 卡或 8 卡的高显存多卡节点(多卡节点整机出租,下单金额 = 单卡价 × 卡数),配合 Axolotl 的 FSDP2 或 DeepSpeed ZeRO-3 实现跨卡梯度与优化器分片。如果企业团队需要更高规格的 RDMA 高速互联、数据隔离、私有网络或专属算力集群,也可以直接通过 联系销售 定制企业方案与对公合同开票。
三、 NexGPU 微调全周期省钱实操:把每一分预算花在刀刃上
很多开发者在复盘微调账单时发现,真正跑 trainer.train() 的时间只占了租卡总时长的 40%,剩下 60% 的算力费都浪费在了拉取百 GB 权重、清洗转换 JSONL 数据集、排查 CUDA 依赖冲突以及人工看日志的空窗期上。
结合 NexGPU 计费规则 与 实例管理特性,按照以下五步操作,可以将微调综合成本压缩 30%~50%:
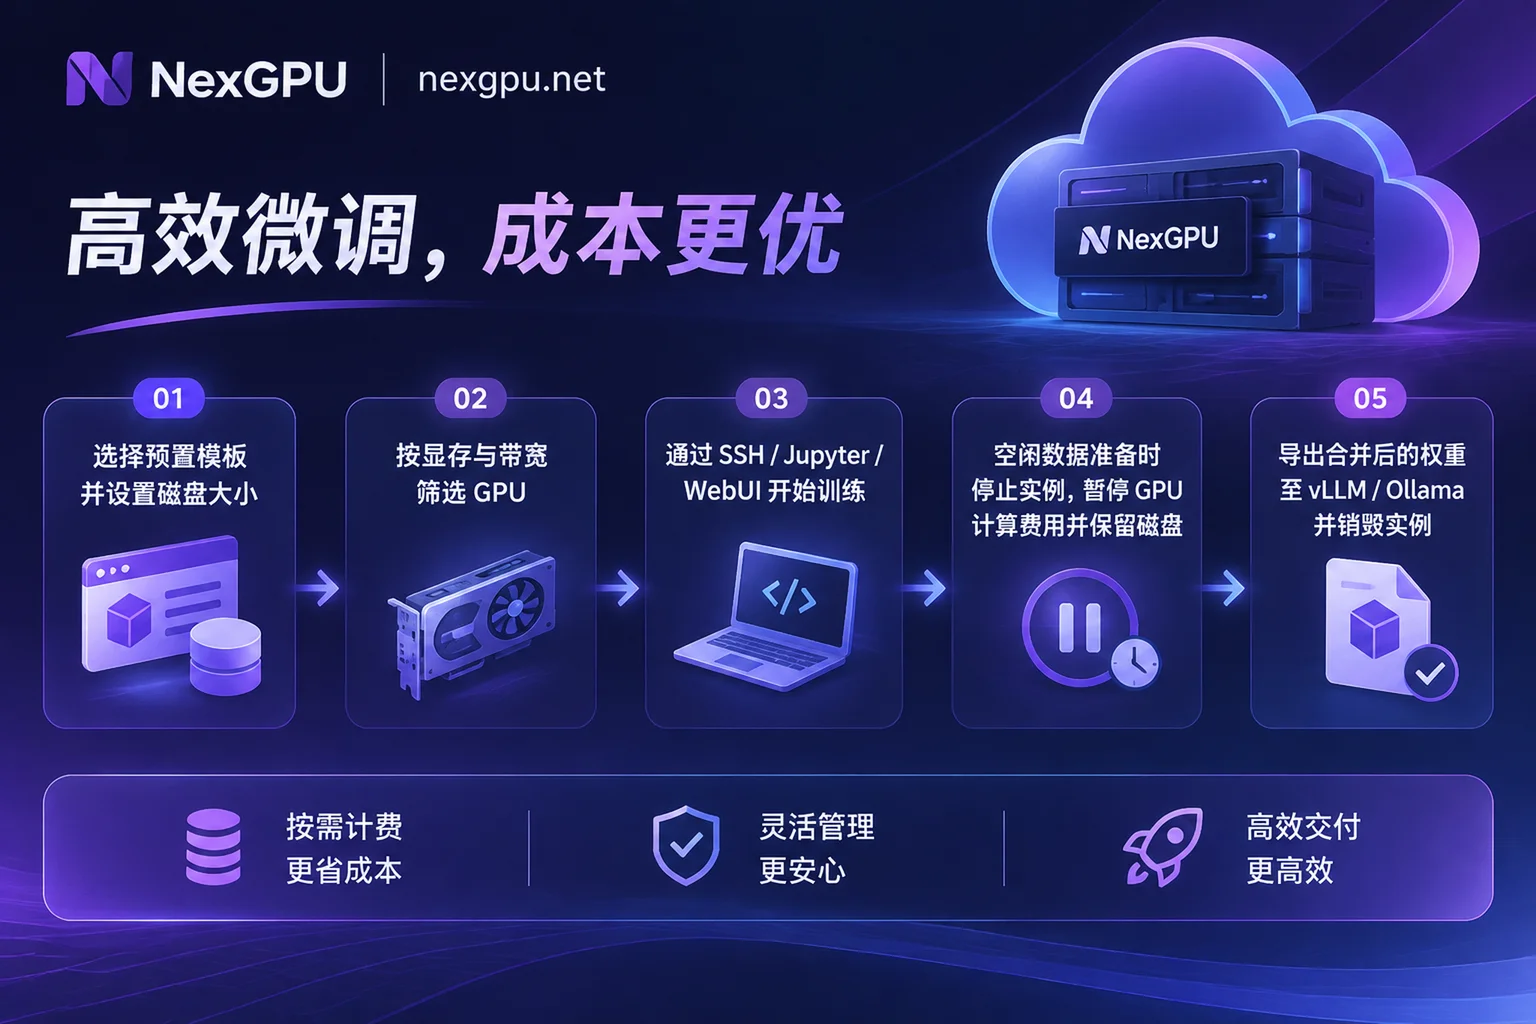
1. 先选镜像环境再筛机器,避开“开卡即 OOM”与漫长配环境
在创建实例时,建议遵循“先选环境、再筛机器”的顺序。当你选定目标环境后,显存不够的机器会在列表中被自动标出并注明原因,从源头杜绝租错卡(参见 如何选择 GPU 文档)。
此外,如果你的训练代码或特定算子(如自定义 FlashAttention 或特殊 MoE 内核)严格锁定了某一个特定的 CUDA 小版本,官网建议直接使用自定义 Docker 镜像功能(支持公开或私有仓库,可自定义启动命令和环境变量),开机即进入预配好的确定性环境,省去每次开机重编译算子的高昂算力耗时。
2. 创建实例时一次算准磁盘容量与机器带宽
微调大模型通常包含四个体积大户:原始基座权重 + 训练数据集 + 多个 Step 的 Checkpoint 存档 + 最终 Merge 后的完整模型权重。
在使用 NexGPU 时,有两个必须提前规划的硬件边界:
- 磁盘不支持创建后扩容:请务必在下单创建实例时,根据“基座模型体积 × 3 + 数据集与 Checkpoint 预留空间”一次性把磁盘容量给够。如果你想在浏览器里用可视化界面管理文件、进程和计划任务,可以一键安装 aaPanel 可视化管理面板,但也要记得把 aaPanel 占用的磁盘空间一并算入。
- 带宽由所选机器决定,不支持单独设置:微调前通常需要从 Hugging Face 或 ModelScope 拉取数十至上百 GB 的基座权重。在 GPU 市场筛选机器时,优先挑带宽充裕的节点,能把拉镜像和下载权重的时间大幅缩短。
3. 善用“按秒计量”与“停机保盘”,切断非训练时段的算力计费
NexGPU 的账单非常透明,只有算力、存储、流量三项,无最低消费、无开通费、无起租时长,且下单时的单价会一直锁定到该实例销毁为止:
- 算力费:按秒计量、按小时计价,实例进入“运行中”才开始计费,一旦停机或销毁立即停止计算力费。
- 存储费:按 GB/月计费,从实例创建时起算(含拉取镜像期间),停机后照常收取,只有销毁实例才停止。
这意味着,当你跑完一轮 Epoch 需要花几个小时人工抽检生成质量、清洗第二批 Bad Cases,或者晚上休息暂停实验时,只需在控制台点击“停机”。此时磁盘里的环境、数据集和 Checkpoint 完好保留,而占大头的 GPU 算力费直接归零;等你改好数据配方再一键启动继续训练即可。
4. 训练后无缝验证:从微调环境切换到 vLLM / Ollama 推理验证
微调跑完并导出 LoRA 适配器或合并(Merge)成完整权重后,千萬不要直接留在高价的多卡训练实例上长期挂着做低并发人工测试:
- 如果是用 Unsloth 导出了 GGUF 量化权重,可以切到轻量级实例配合 Ollama 模板快速验证对话手感。
- 如果是准备上线高并发业务接口,可以在 NexGPU 镜像模板库 中选用 vLLM、SGLang 或 TGI 等大模型推理模板(拉起后直接提供标准 OpenAI 兼容接口),具体生产迁移步骤可参考《vLLM部署实战指南:从Ollama迁到高并发生产环境,如何选卡、配镜像与开放OpenAI兼容接口》。
5. 导出权重后及时“销毁”实例,注意平台不提供自动备份
由于存储费在停机状态下仍会按月折算持续计费,当你的微调任务彻底收工后,请务必第一时间通过 SSH / SFTP 或对象存储工具,将微调产出的 LoRA 权重、Merged 模型以及训练日志传输备份到你自己的外部存储中。
⚠️ 重要安全提醒:NexGPU 的实例为独占容器,平台出于隐私保护既不读取也不备份用户的磁盘内容。当你输入实例编号确认“销毁”后,磁盘将被立即释放且数据不可恢复;同时请留意账户余额预警邮件,避免因余额耗尽自动停机后、长时间处于负余额状态而触发系统自动销毁。
四、 结语:如何开启你的第一次低成本微调?
在 2026 年,大模型微调早已不再是动辄需要包月租用昂贵集群的重资产工程。只要理清 “单卡提速选 Unsloth、可视化与多模态选 LLaMA Factory、多卡分布式扩展选 Axolotl” 的框架分工,再配合按秒计量的弹性 GPU 算力,哪怕只有几美元的预算,也能在几小时内训出一个高度贴合业务语境的专属模型。
如果你已经准备好了微调数据集,现在就可以按以下路径快速上手:
- 零门槛看价与注册:使用邮箱即可完成注册(无需实名认证与繁琐的配额申请,注册后无需绑定支付方式即可查看实时算力价格,充值支持支付宝与 USDT-TRC20,详见 快速开始指南)。
- 对号入座查方案:前往 NexGPU 场景做法页(AI 微调) 查看不同模型规模对应的显存需求、推荐显卡、镜像搭配与预算估算。
- 挑卡开机:打开 NexGPU GPU 市场 与 镜像模板页,选定你的微调框架模板与高性价比显卡,立即开启极速微调之旅!


