 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在2026年的技术语境下,「GPU集群」已不再是巨头企业的专属。无论是专注于AI Agent开发的初创团队,还是需要处理大规模渲染任务的视觉工作室,当业务规模从单卡推理扩展到大模型训练、高性能微调或并行渲染时,如何构建一套具备弹性、高性价比且低门槛的GPU集群,成为了研发团队的“必修课”。
为什么开发者都在转向弹性集群化?
最近的行业热点显示,单纯追求单卡极致性能已无法满足复杂的并行任务。无论是利用 DeepSpeed 进行模型分布式训练,还是通过 Megatron 优化超大参数模型的推理,集群化部署已是绕不开的门槛。
然而,自建集群面临设备折旧、维护高昂、扩展不灵活等痛点。开发者需要的,是一个“随用随取,按需扩展”的虚拟化集群方案。
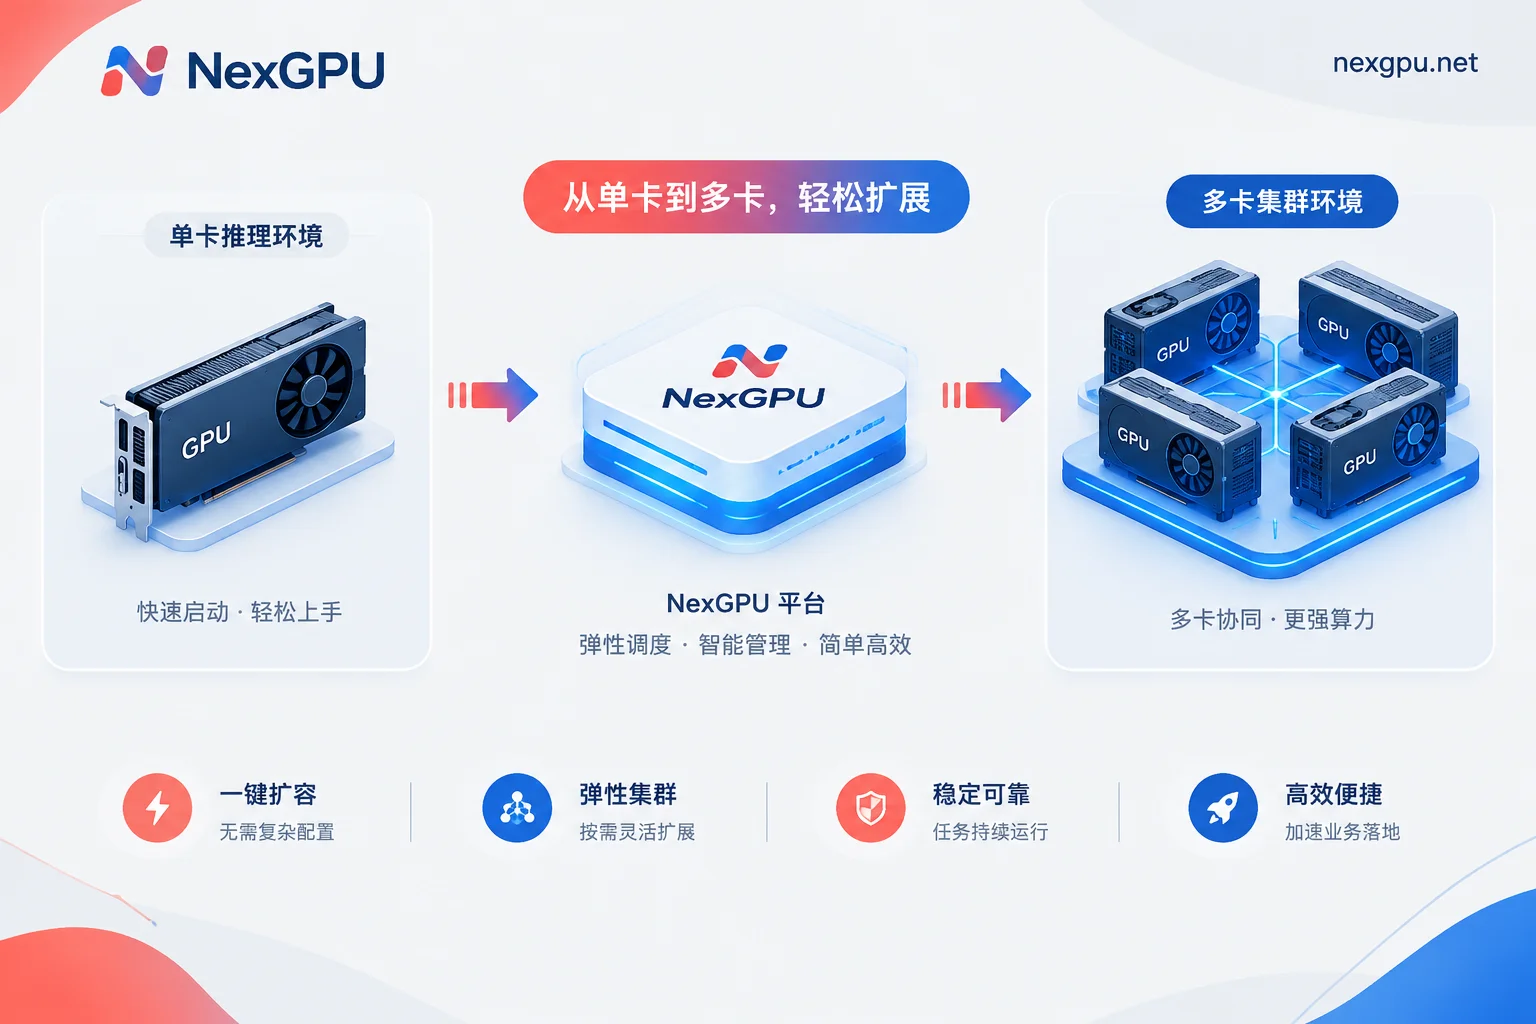
从单卡到集群:NexGPU的弹性演进逻辑
NexGPU 旨在消除算力资源获取的阻力,帮助开发者实现算力的无缝切换:
- 按需选卡,无感扩展:在 GPU 市场,你可以像挑选商品一样挑选 GPU。从 RTX 4090/5090 等高性能消费级显卡,到 A100、H100、H200、B200 等顶尖数据中心级显卡,每一台机器都实时标明算力单价。你需要扩容时,只需按需下单,系统支持多卡节点整机出租,轻松应对分布式算力需求。
- 开箱即用的集群环境:在 镜像模板 中,我们预置了包括 PyTorch、JAX 等在内的主流训练框架,以及针对分布式任务优化的环境。无论你是要做模型微调、推理部署,还是 Blender 分段并行渲染,开机即用,避免繁琐的环境配置。
- 灵活的连接与管理:提供网页终端、SSH 直连及 Jupyter 环境,让集群管理如同本地开发一般直观。通过详情页,你可以实时监控每台实例的负载,停机保留数据,灵活控制成本。
企业级方案:满足更高阶的互联需求
对于需要处理极致性能任务的团队,NexGPU 同样提供了深度支持:
如果你需要 RDMA 高速互联、数据隔离或专属算力集群,我们支持企业方案定制。你可以通过联系销售进行预留实例、包月包年或建立专属算力池,满足对稳定性与网络吞吐有严苛要求的科研或生产级任务。
成本控制:按秒计费的极致性价比
放弃昂贵的预付费模式,NexGPU 采用纯粹的按秒计量、按小时计价方式。算力、存储、流量三项账单清晰,没有隐形消费和起租门槛。让你的预算完全投入到有效的计算时长中。
想要开始你的集群化之路?
无需实名认证,注册即用。立即前往 NexGPU 官网,开启你的高效算力之旅。


