 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在 2025 年下半年,不少技术团队曾预期:随着 H200 与 Blackwell(B200)系列芯片陆续交付,问世多年的 NVIDIA H100 租赁价格将一路走低。然而进入 2026 年,全球算力市场却走出了一条截然相反的曲线。
据半导体研究机构 SemiAnalysis 及多家算力价格追踪指数在 2026 年披露的数据,受多智能体(Multi-Agent)工作流普及、原生视频生成应用爆发以及开源权重模型调用量激增的拉动,H100 的一年期租约与按需租用价格自 2025 年底触底后反弹了近 40%。更值得研发团队与算力采购注意的是,同一颗 H100 芯片在不同云服务商之间的按需时租差价高达 3.8 倍至 4.7 倍——传统大型公有云(Hyperscalers)的报价往往是专业 GPU 算力市场的 2 到 4 倍。
在“一卡难求”与“跨平台巨幅差价”并存的 2026 年,团队在进行 H100租用 时不能再只看表面的标称单价,而需要从硬件能力边界、跨代卡型对比以及计费机制三个维度重新精算成本。
一、为什么在 2026 年,H100 依然是主力算力锚点?
尽管 H200 和 B200 已经上市,但 H100 依然是当前软件生态适配最成熟、现货流动性最好的数据中心级旗舰卡。决定一张显卡租用价值的并非“发布年份”,而是它在当前主流任务中的单 Token 产出成本与训练收敛耗时。
H100(80GB HBM3)之所以在生产环境中难以被消费级显卡或前代卡型轻易替代,核心在于三项硬指标:
- 原生 FP8 Tensor Core 引擎:H100 的第四代 Tensor Core 原生支持 FP8 混合精度计算,稠密算力接近 1,979 TFLOPS(稀疏模式下翻倍)。在 2026 年主流的 vLLM 或 SGLang 生产环境部署 中,开启 FP8 量化几乎成为标准动作——既能将权重显存占用减半,又能在几乎不损失模型精度的前提下让推理吞吐翻倍。
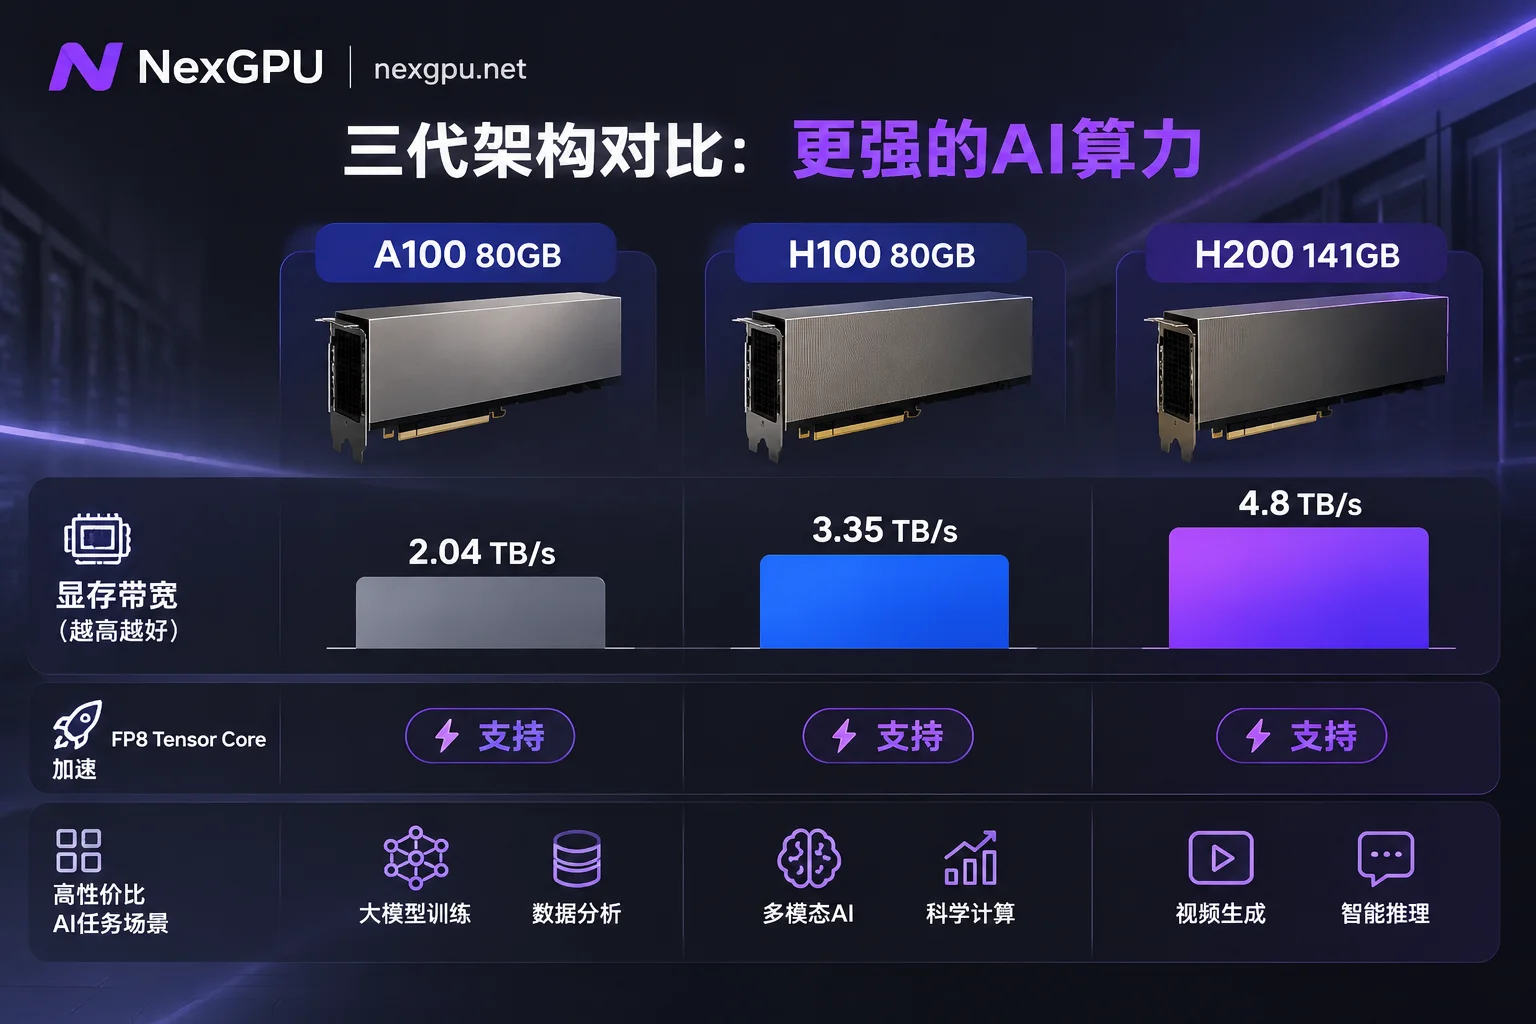
- 3.35 TB/s 的 HBM3 显存带宽:大模型推理的 Decode(生成)阶段是典型的访存受限(Memory-bound)任务。相比 A100 80GB 的 2.04 TB/s 带宽,H100 提升超过 60%,在高并发与长上下文场景下能显著压低首字延迟(TTFT)与生成延迟(TPOT)。
- 高带宽多卡互联能力:在多卡并行训练或超大模型跨卡张量并行(TP)推理中,卡间通信往往是吞吐瓶颈。H100 节点提供的高速互联能力,使其在运行 DeepSpeed、FSDP 或 Megatron 分布式任务时具备极高的扩展效率。
二、选卡决策:什么时候必须租 H100?对比 A100 与 H200
面对数据中心级显卡列表里的 A100、H100、H200 和 B200,很多开发者容易陷入“盲目追新”或“只挑便宜卡”的误区。之前我们在探讨 A100 80GB 跑推理是不是浪费 时曾分析过显存与算力的匹配关系,而在评估 H100 租用时,可以按以下三条分水岭直接对号入座:
| 对比维度 | A100 (80GB) | H100 (80GB) | H200 (141GB) |
|---|---|---|---|
| 显存容量与类型 | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e |
| 显存带宽 | ~2.04 TB/s | ~3.35 TB/s | ~4.8 TB/s |
| FP8 原生加速 | 不支持(主用 FP16/BF16/INT8) | 原生支持(Transformer Engine) | 原生支持(同 Hopper 架构) |
| 最划算的租用场景 | 显存刚需 80GB、但并发度中等的批处理或传统微调 | 高并发 FP8 在线推理、中大型模型全参/LoRA 微调、多智能体高频调用 | 单卡需装下 70B+ 模型及超大 KV Cache、避免跨卡拆分的极长上下文任务 |
1. 什么时候从 A100 升级到 H100 反而更省钱?
虽然 H100 的每小时单价高于 A100,但在计算密集型微调(详见 大模型微调GPU怎么选)和 FP8 高并发在线推理中,H100 的实际吞吐往往能达到 A100 的 2 到 3 倍。这意味着原本需要租用 10 小时的训练任务,在 H100 上可能 3.5 小时就能跑完并关机——算力按秒计量、按小时结算下来,单次任务的总账单反而更低。
2. 什么时候选 H100,什么时候上 H200?
H200 与 H100 共享相同的 Hopper 计算核心,核心差异在于显存容量(141GB vs 80GB)和带宽(4.8 TB/s vs 3.35 TB/s)。如果你的 70B 模型在 FP8 精度下配合业务所需的 KV Cache 刚好能塞进 80GB 显存(或双卡 160GB),租用 H100 的性价比最高;只有当单卡显存溢出导致被迫增加卡数、且卡间通信代价过高时,才需要考虑单卡 141GB 的 H200。
如果不确定手头的开源模型量化后究竟占多少显存,可以直接查阅 NexGPU 的 模型选卡指南,里面逐个列出了主流文本大模型、视频生成、多模态视觉及 AI Agent 模型的当前版本、量化显存门槛与推荐卡型。
三、H100 租用避坑:比“每小时单价”更关键的四笔账
在 2026 年云厂商频频调价的背景下,我们在 主流云厂商GPU算力价格怎么比 一文中强调过:千万不要只看宣传页上的“最低起步价”。在实际租用 H100 时,以下四个隐性环节往往决定了最终的财务支出:
1. 警惕中途涨价与抢占式中断:认准“下单锁价”与“独占实例”
市面上部分低价 H100 属于抢占式(Spot)实例,训练跑了一半随时可能被平台回收;另一些平台则会跟随市场供需动态上调存量实例价格。
在 NexGPU 价格市场 中,每一行代表一台真实可租的物理机器,消费级(RTX 4090、5090 等)与数据中心级(A100、H100、H200、B200 等)分开列价。最核心的保障在于:下单时的单价将直接锁定到该实例销毁为止,不受后续市场波动影响;且所有实例均为独占容器,无最低消费、无开通费、无起租时长限制。
2. 算力、存储与流量分项透明:善用“停机保盘”
很多团队租用 H100 调试环境时,大量时间花在写代码、清洗数据或排查 Bug 上,此时让昂贵的 H100 空转是极大的浪费。
NexGPU 的 计费规则 非常直接,账单只有算力、存储、流量三项并在实例详情页实时列出:
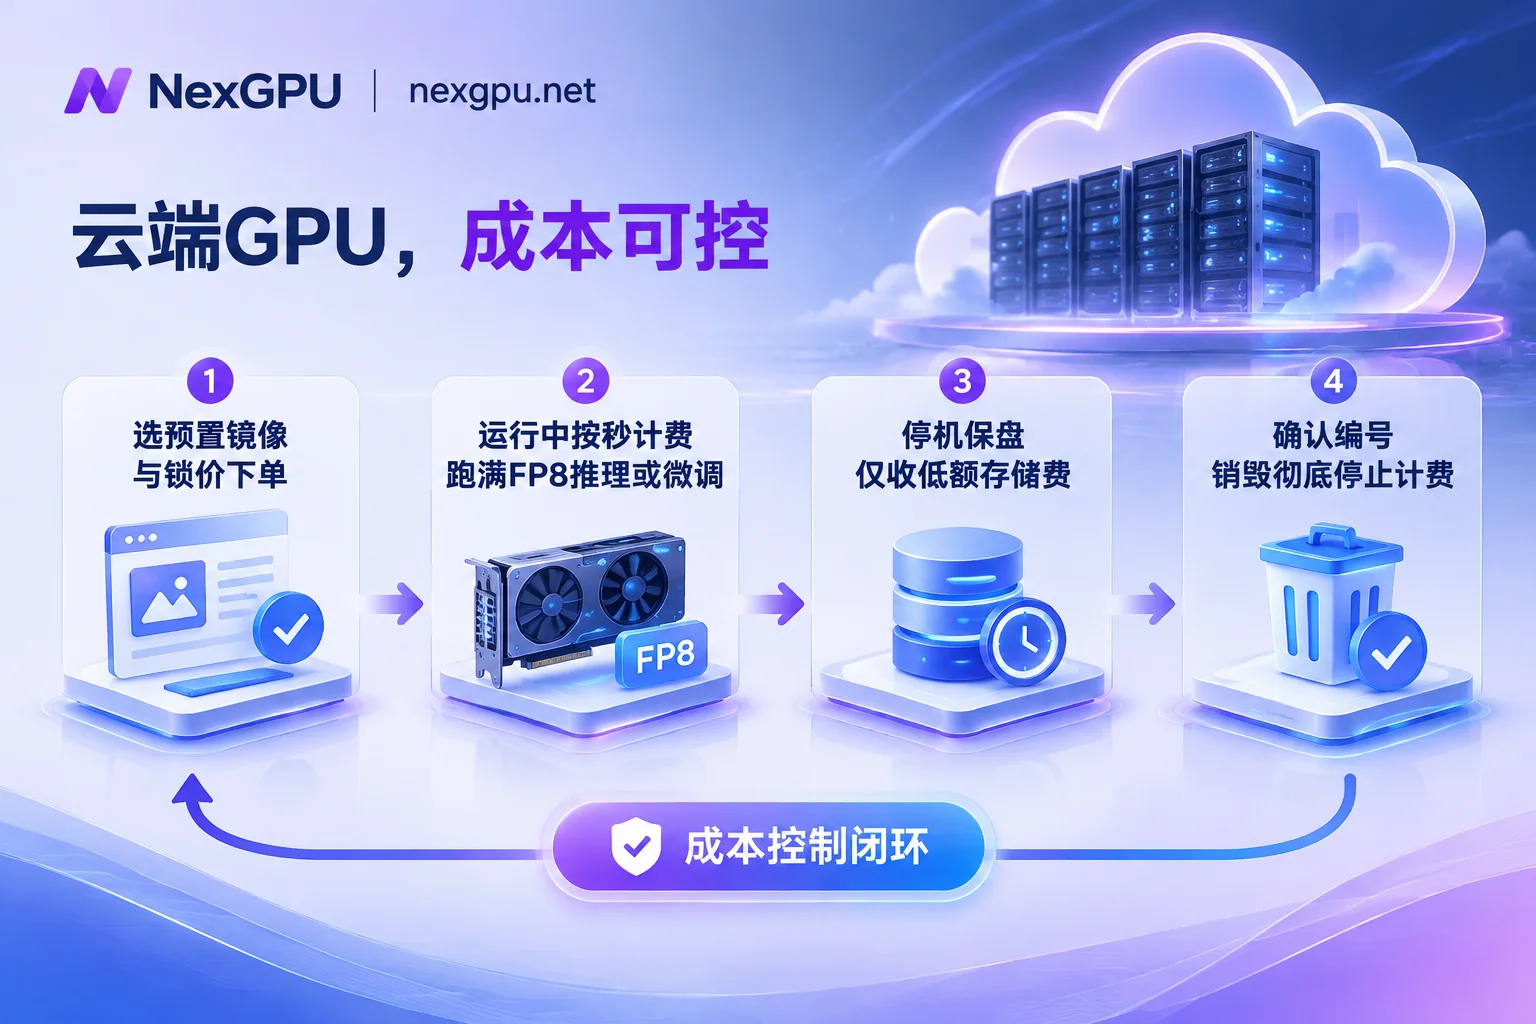
- 算力费:按秒计量、按小时计价,实例进入“运行中”才开始计费,停机或销毁即刻停止计费。
- 存储费:按 GB/月计费,在机器列表选卡时即与算力单价分开标出。平时不跑训练时,将实例停机即可保留磁盘和全部环境数据,期间只收取极低的磁盘存储费,随时可再次启动。
- 确定不需要时再销毁:销毁实例需要输入实例编号确认,确认后磁盘立即释放,所有计费彻底终止(注意:平台不读取也不备份磁盘内容,销毁前请务必自行导出重要权重与数据)。
3. 免去配额审批与环境折腾:预置镜像开机即用
在传统大厂云平台申请 H100,往往要经历企业实名认证、提交工单申请 GPU 配额、等待数天审批的漫长流程。而在 NexGPU,只需邮箱即可完成注册,无需实名认证与配额申请,充值支持支付宝与 USDT(TRC20),注册后无需绑定支付方式就能直接查看实时价格与可用节点(参见 快速开始指南)。
为了省去动辄一两个小时的驱动与 CUDA 编译时间,NexGPU 提供了开箱即用的 镜像模板库:
- 大模型推理:预置 vLLM、SGLang、TGI、Ollama,拉起后直接提供 OpenAI 兼容接口。
- 训练与微调:预置 PyTorch、TensorFlow、JAX 以及 LLaMA Factory、Axolotl、Unsloth。
- 图像视频与语音:预置 ComfyUI(支持 FLUX、视频扩散模型)、WhisperX 等。
- 自定义私有镜像:如果项目代码严格锁定特定 CUDA 版本,也支持直接填写自己的 Docker 镜像(公开或私有仓库均可),并自定义启动命令与环境变量。
更贴心的是,当你采取“先选环境再筛机器”的流程时,系统会自动把显存不够的机器标出并注明原因(详见 如何选择 GPU 文档),彻底避免新手租错卡导致 OOM(显存溢出)的尴尬。
4. 从单卡验证到多卡整机集群的平滑演进
不少研发团队的典型路径是:先租 1 张 H100 跑通 Pipeline 并核算单步耗时,随后迅速扩展到 4 卡或 8 卡节点进行全量训练(可参考 从小规模尝试到万卡算力:如何低门槛构建弹性GPU集群)。
在 NexGPU 的 GPU 市场中,你可以直接按显存、价格、地区、可靠性、带宽、最少卡数进行筛选:
- 多卡节点自助下单:高显存多卡节点整机出租,下单金额清晰透明(单卡价 × 卡数),原生支持 DeepSpeed、FSDP、Megatron 等主流分布式框架。
- 直连开发体验:每台实例自带公网 IP、SSH 直连端口(不经跳板机,可设默认公钥)、浏览器网页 root 终端以及一键免输令牌的 Jupyter,同时预留备用端口供你对外暴露自定义 API 服务。
- 企业级定制方案:如果你的团队需要 RDMA 高速互联、私有网络与数据隔离、预留实例、包月包年锁价,或者需要签合同、走 PO 采购、对公付款与开具发票,可以直接通过 联系销售页面 获取专属算力集群方案。
四、结语:把预算花在真正的有效算力上
2026 年的 AI 竞争早已进入拼工程效率与单位 Token 成本的阶段。面对 H100 市场的高企需求与跨平台价差,最理性的策略是:避开传统公有云的高额溢价与繁琐配额审批,利用聚合全球分布式供给的算力市场,按需锁价租用。
无论你是正在推进 大模型私有化部署或 AI 微调 的研发团队,还是需要评估多卡节点的算力采购,现在都可以直接前往 NexGPU GPU 市场 筛选实时在售的 H100 节点,用按秒计量的弹性算力加速你的下一次模型迭代。


