 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
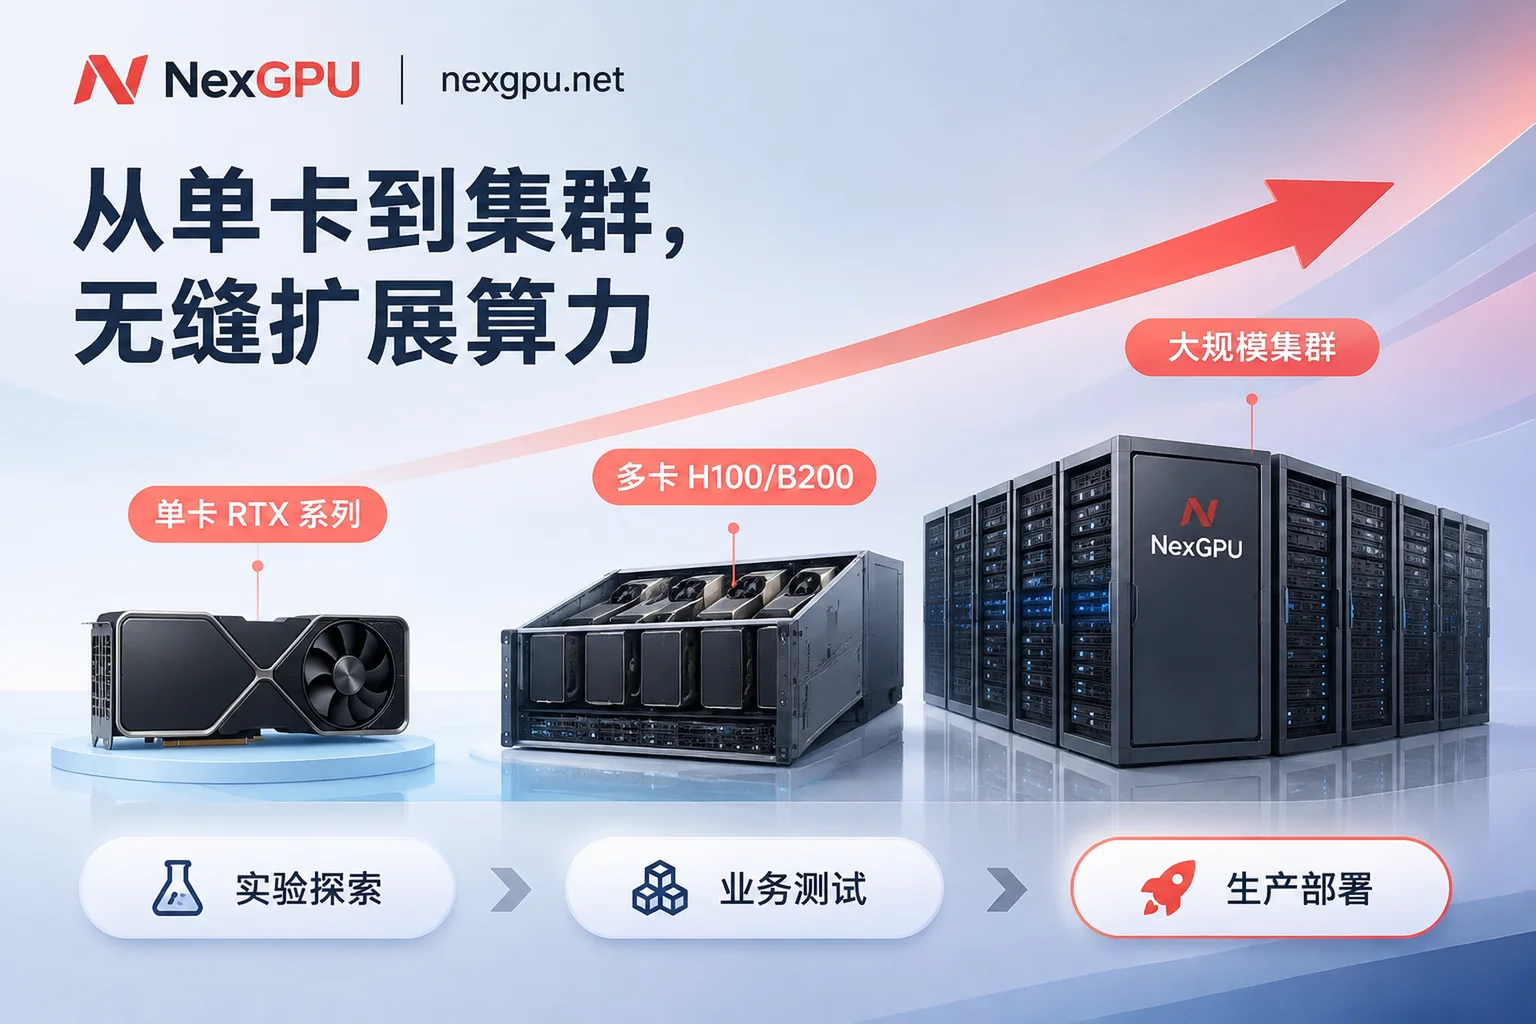
在AI技术的演进浪潮中,我们常听到开发者面临这样的困境:从个人实验室的“一张显卡跑模型”到企业级的“大规模分布式训练与推理”,中间似乎隔着一道难以逾越的算力鸿沟。
当你的AI业务从Prototype(原型)迈向Production(生产环境),单一消费级显卡已不足以支撑高并发请求与庞大的模型微调参数。此时,GPU集群的搭建不仅是硬件的堆叠,更是对弹性、效率与成本控制的综合考验。
从单卡“作坊”到多卡“工厂”的转型关键
许多团队在扩容时容易陷入“硬件焦虑”,担心采购高昂的A100或H100硬件不仅交付慢,且闲置时成本难以承受。NexGPU GPU市场 提供的按小时计费模式,正是为了解决这一痛点。
通过聚合全球分布式算力,我们让你无需面对繁琐的服务器运维,即可直接租用包括 H100、H200、B200 在内的高性能多卡节点。无论是进行DeepSpeed加速,还是部署Megatron框架,你都可以按需筛选具备高速互联能力的机器,实现算力资源随业务波动即时伸缩。
为什么选择NexGPU构建你的弹性集群?
- 透明的成本精算:没有最低消费,按秒计费,存储与带宽精细拆分,避免隐形成本。对于研发团队,这不仅是一张账单,更是评估模型性价比的精准仪表盘。
- 开箱即用的预置镜像:集群搭建最耗时的环境配置,我们已通过镜像模板彻底解决。无论是微调常用的 Unsloth/LLaMA Factory,还是推理必备的 vLLM/SGLang,只需开机,即可通过网页终端或SSH直连进入状态。
- 灵活的扩展逻辑:在 模型选卡指南 中,我们详细标注了主流模型的显存门槛。你可以从一张RTX 4090起步测试,当模型量化需求增加时,一键平滑扩展至多卡节点集群,整个过程代码迁移成本极低。
破局生产级瓶颈:不仅仅是算力
对于需要私有化部署、高并发推理的企业级需求,除了基础的算力,NexGPU 还提供定制化的企业方案。针对需要RDMA高速互联、数据隔离的复杂任务,我们能协助构建专属的私有算力池,确保你的核心模型在隔离、安全的环境下高效运行。
别让硬件门槛锁住了你的AI创意。无论是探索多卡分布式训练,还是优化大规模推理管线,访问 NexGPU,让你的算力储备与AI业务同步成长。
想进一步了解如何避开性能陷阱?查看我们的解决方案页,掌握不同业务场景下的算力配置最优解。


