NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
只是一个默认分类
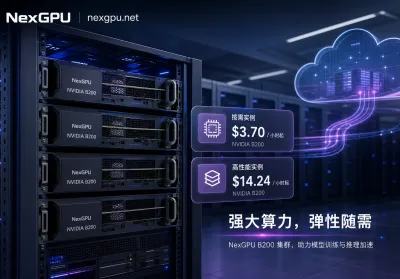
B200 GPU 按量价格差 3-4 倍:从 $3.70 到 $14.24/小时,怎么算清 Blackwell 的单位算力账
同一张 B200 GPU,按量单价为何能相差 3-4 倍?2026 年 6 月到 8 月的第三方云价格监测给出了一个相当惊人的分布:Spheron 报出每小时 3.70 美元,Lambda Labs 在 4.99 到 5.29 美元之间,Nebius 是 5.50 美元,Runpod 在 5.89 到 5.98 美元,而 AWS 的 p6-b200 实...
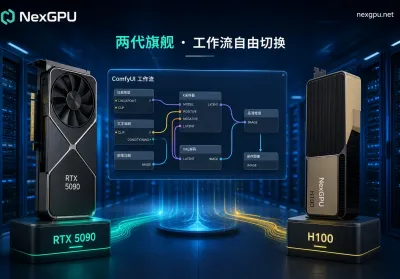
ComfyUI云GPU怎么选:FLUX.2 与视频生成下,RTX 5090 与 H100 的显存、带宽与每张图成本账
2026 年,FLUX.2(32B 参数的 DiT 模型)和 Wan 2.1/2.2、HunyuanVideo 等视频生成模型已经全面进入 ComfyUI 生产工作流。这时候再讨论 ComfyUI云GPU 怎么选,问题已经不再是“哪张卡算力最强”,而是“在同样的工作流下,32GB 显存的 RTX 5090 够不够用?比 H100 慢多少?每张图、每段视...
vLLM部署实战:并行推测解码与零开销 Prefix Caching 更新后,GPU 显存与并发怎么配
2026 年 7 月 28 日,vLLM 官方博客宣布集成 P-EAGLE、DFlash 和 DSpark 等并行草稿推测解码算法。在引擎更新之后,vLLM部署该选多大显存、并发与预填参数怎么配?一、开篇:vLLM 本轮更新到底改了什么,为什么它直接影响你的显存账单这轮更新改变的是生成阶段的调度方式:多个候选 Token 可以并行生成与验证,不再受单 ...