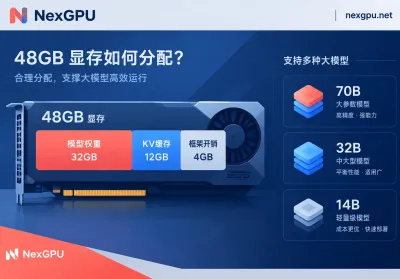
先说结论。48GB 显存单卡(RTX 6000 Ada、L40/L40S、A6000、A40 这一档)的能力边界如下。推理:最大能跑 70B 级模型的 4-bit 量化版,前提是单用户或小并发、上下文在 4K~8K 左右。想留出更多余量,可以选 32B/34B 的 8-bit 版,或 14B 的 FP16/BF16 原精度版。微调:极限是 70B 的 ...
先把结论摆出来,你可以直接跳到自己那一档:16GB 显存:主干换 FP8,文本编码器换 fp8 版本,1024×1024 基本能跑满流程,画质损耗很小。10~12GB:GGUF Q5_K_M 或 Q4_K_S 主干 + fp8 的 T5,配合 ComfyUI 的低显存模式。8GB:GGUF Q4 档 + fp8 T5 + CPU 卸载,能出图,但要接受...
一、DeepSeek部署第一步不是选卡,而是先把显存台阶算清楚很多团队在考虑DeepSeek部署时,第一反应是“上什么卡”,但更合理的顺序应该是先算显存。因为不同精度下,同一个模型的显存需求可能相差数倍。以DeepSeek-R1蒸馏系列为例,在FP16/BF16原生精度下,32B和70B模型需要64GB-181GB显存,这个区间大到足以让单卡方案直接出...
0 条留言
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客