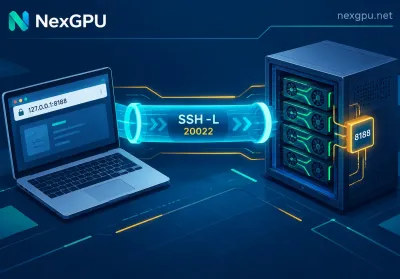
租来的 GPU 实例多数跑在容器和 NAT 网络后面,对外只开一个高位 SSH 端口,控制台上并没有一排随你勾选的端口。所以"端口映射"在实际操作里是两条路:SSH 本地端口转发(隧道)——不在公网上多开任何端口,本地浏览器访问 http://127.0.0.1:端口 就直达实例里的服务。第一次跑通、自己一个人用、调试阶段,选这条。平台公网端口映射——...
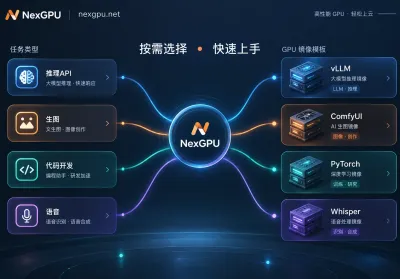
先问自己要跑什么任务租云 GPU 之前,先明确交付目标:是对外提供高并发 API 推理服务,还是自己做创意生图生视频,或是写代码做微调实验,还是批量转写音频?任务性质直接决定镜像模板的类型。生产级大模型推理或高并发 API 服务:直接选 vLLM 或 TGI(Text Generation Inference)镜像。这类镜像预编译好 PagedAtte...
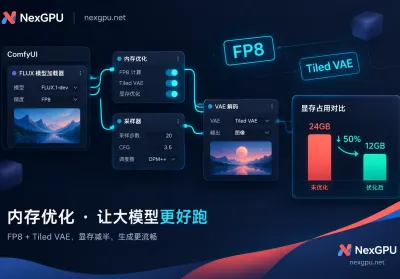
为什么 FLUX.1 在 ComfyUI 里容易爆显存FLUX.1(dev 或 schnell)采用约 120 亿参数的 Diffusion Transformer 架构,全精度(FP16/BF16)权重文件本身就需约 24GB 显存。加载后还要同时运行体积接近 10GB 的 T5-XXL 文本编码器,以及在高分辨率解码阶段调用 VAE,峰值显存需求轻...
先把结论摆出来,你可以直接跳到自己那一档:16GB 显存:主干换 FP8,文本编码器换 fp8 版本,1024×1024 基本能跑满流程,画质损耗很小。10~12GB:GGUF Q5_K_M 或 Q4_K_S 主干 + fp8 的 T5,配合 ComfyUI 的低显存模式。8GB:GGUF Q4 档 + fp8 T5 + CPU 卸载,能出图,但要接受...
这份 Flux.1模型云端GPU部署教程先给结论:FLUX.1 [dev] 与 [schnell] 的云端显存需求按精度和用途分三档——FP8 量化 12-16GB 可跑单图,FP16 全精度需 24GB 以上且通常要开 CPU 卸载,生产级复杂工作流建议 32GB+。这个结论源自 Black Forest Labs 官方模型卡的数据,下面逐步拆解每笔...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客