 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
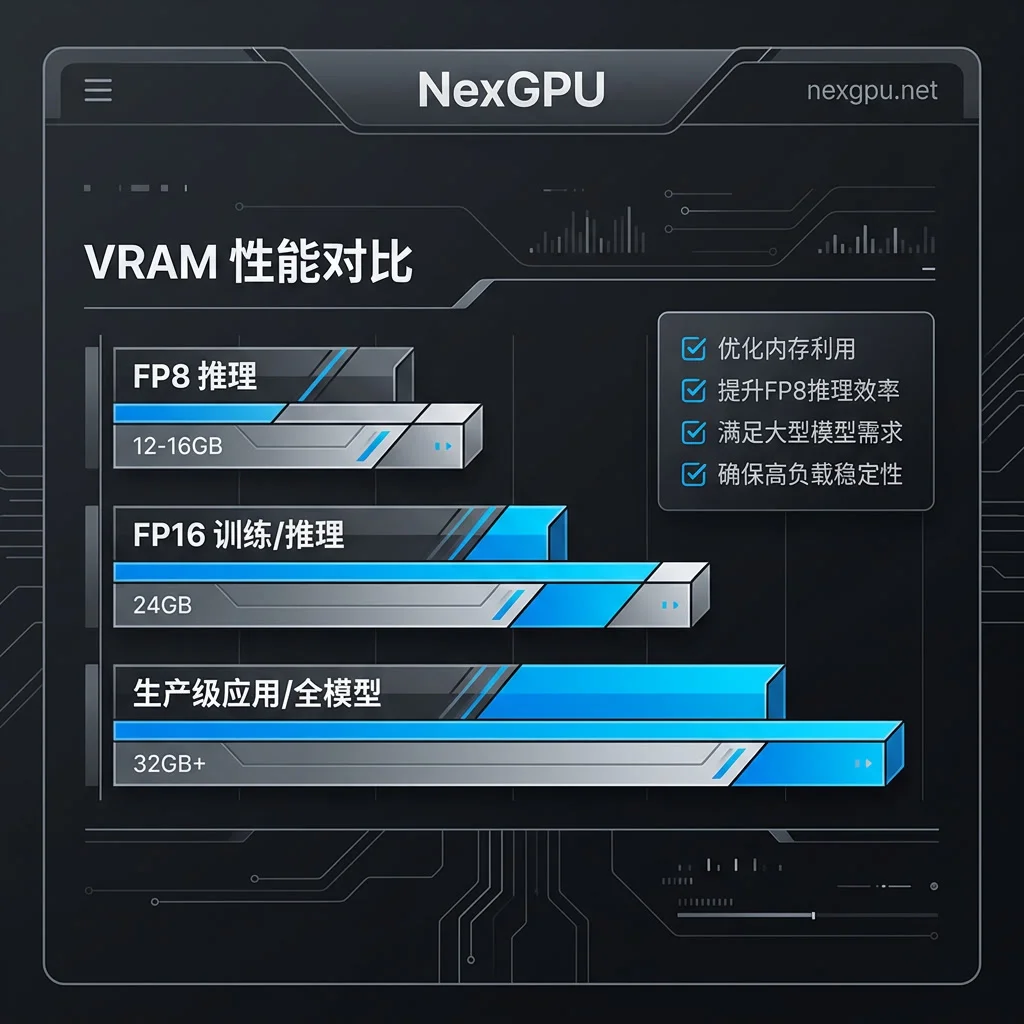
这份 Flux.1模型云端GPU部署教程先给结论:FLUX.1 [dev] 与 [schnell] 的云端显存需求按精度和用途分三档——FP8 量化 12-16GB 可跑单图,FP16 全精度需 24GB 以上且通常要开 CPU 卸载,生产级复杂工作流建议 32GB+。这个结论源自 Black Forest Labs 官方模型卡的数据,下面逐步拆解每笔显存账,并给出可直接上手的云端部署步骤。
部署前先问自己三件事:分辨率、扩展节点、并发
在选卡之前,先明确你的实际出图场景,因为这三项直接决定你落入哪一档显存:
- 出图分辨率:512×512 与 1024×1024 的中间张量占用差异巨大,直接推高峰值。
- 是否叠加扩展节点:LoRA、ControlNet、高分辨率放大(Upscale)都会在 DiT 主干的中间特征图上额外增加显存。
- 是否需要并发:批量出图或多任务同时跑,显存峰值按并发数近似线性叠加。
如果你只跑单张 1024 基础分辨率、不加任何扩展,FP8 档位的 16GB 卡就能胜任;但一旦叠上 ControlNet 或想稳定并发,就要看后文的三笔账重新评估。
第一笔账:12B DiT 主干在 FP16 与 FP8 下各占多少
FLUX.1 的架构核心是一个约 12B 参数的整流流(Rectified Flow)Transformer 主干。在全精度 FP16/BF16 下,仅这一部分的权重和推理峰值就相当可观。根据官方 FLUX.1-dev 模型卡 与 推理仓库 描述,整体 FP16 推理峰值约在 24-33GB 区间。
而通过 FP8 量化(如 FP8-E4M3FN),主干权重可以被压缩到 12-16GB 左右——这是 16GB 显卡能运行单图生成的关键。但要注意,主干只是第一笔账,文本编码器才是压垮 24GB 的“隐形杀手”。
第二笔账:T5-XXL 与 CLIP-L 文本编码器,才是压垮 24GB 的那一项
FLUX.1 还配有两个文本编码器:T5-XXL(约 4.5B 参数)和 CLIP-L。在全精度常驻显存时,它们与 VAE 解码一起会把整体峰值进一步推高。按官方模型卡说明,24GB 卡在不启用 enable_model_cpu_offload 时无法让全部权重常驻显存完成推理。
要回答“flux.1 schnell 24g显存够吗”,得分开看:schnell 与 dev 的权重规模接近,单独跑单图、开 CPU 卸载可以勉强运行,但若追求稳定并发或叠加扩展,24GB 就不是舒适区间。官方给出的 33GB 上限,往往就是在编码器与 VAE 常驻时出现的。
第三笔账:LoRA、ControlNet 与高分辨率中间张量
在 ComfyUI 中叠加多层 LoRA 或 ControlNet 结构控制时,附加权重与中间特征图会显著推高显存峰值。这就是“comfyui跑flux加controlnet爆显存怎么办”的根源——不是主干权重翻倍,而是中间张量在控制和放大时激增。
以 1024 分辨率生成并叠加 ControlNet,FP8 档位 16GB 卡可能会在解码阶段 OOM。此时要么降分辨率、开 VAE Tiling,要么换更大显存卡型。建议优先保证权重常驻,再考虑扩展节点,否则频繁换入换出会明显变慢。
三档显存路线怎么选:16GB、24GB、32GB+ 的边界在哪
把三笔账汇总成下表,方便按场景对号入座:
| 显存档位 | 适用场景 | 边界与注意事项 |
|---|---|---|
| 12-16GB(FP8) | 单图、1024 基础分辨率、不叠扩展 | 叠加 ControlNet 或高分辨率放大易 OOM |
| 24GB(FP16+卸载) | 单图、可叠加少量 LoRA | 需 CPU Offload,跨总线搬运有延迟 |
| 32GB+(全精度常驻) | 生产级工作流、批量并发 | 消除总线瓶颈,稳定出图 |
对于“flux.1 用4090还是L40S”的问题,单卡 4090 的 24GB 在 FP16 下需卸载,而 L40S 48GB 可让 DiT 和 T5-XXL 全权重常驻显存——后者是生产环境的稳妥选择。想深入了解可参考 GPU显存怎么选。
Flux.1模型云端GPU部署教程:环境准备、权重拉取与工作流启动
下面是这份 Flux.1模型云端GPU部署教程的可复制落地流程,结合 NexGPU 的按量计费实例,可以先用小时级资源实测一次:
- 环境准备:确认驱动与 CUDA 环境,安装 PyTorch 与 diffusers/ComfyUI 依赖。
- 拉取权重:从 Hugging Face 官方仓库下载 FLUX.1-dev 或 schnell 权重,注意同时下载 T5-XXL 与 CLIP-L 编码器。
- 选择精度档位:若要跑 16GB 卡,使用 FP8 量化(如 FP8-E4M3FN);若显存充足,用 FP16/BF16 全精度。
- 加载工作流:在 ComfyUI 中导入工作流 JSON,或使用 Diffusers 编写推理脚本。
- 跑通首图并记录:观察显存峰值与单图耗时,为后续成本核算做准备。
如果遇到 OOM,可参考 GPU Out of Memory显存溢出解决方法 排查节点内存释放问题。
CPU 卸载与量化的取舍:省了显存,慢在哪一步
CPU 卸载(enable_model_cpu_offload)、Sequential CPU Offload 和 VAE Tiling 都能压缩显存峰值,但代价是每批次通过 PCIe 总线动态搬运权重,显著增加出图延迟。延迟主要出现在权重换入换出的那一两步,而不是计算本身。
在批量生产场景,频繁卸载会让每张图的时间变成“搬运+计算”相加,效率大打折扣。因此,企业级应用通常选择 32GB 以上大显存卡型(如 L40S租用、A100),让 DiT 与 T5-XXL 全权重常驻。
把时租换算成每张图成本:该记录哪些指标
要回答“flux.1 云端GPU一小时多少钱”,不能只看小时单价,得结合你的实际用量换算。按量计费的云平台(如 NexGPU)适合先小时级实测再定长期规格,避免浪费。
建议记录四个指标:
- 显存峰值:判断所用卡型是否合适。
- 单图端到端耗时:包括加载、推理与解码。
- 批量并发数:同时出图数量。
- 失败重跑率:OOM 导致的资源浪费。
用“小时单价 ÷(3600 ÷ 单图秒数)”即可得出每张图的 GPU 成本。别忘了把失败重跑算进去,否则估算会偏低。也可以阅读 ComfyUI多GPU并行渲染优化 了解多卡分摊成本的方法。
部署检查清单:四项必查
- [ ] 实测显存峰值,而不是只看模型权重大小
- [ ] 确认文本编码器是否常驻,避免隐性的 24GB 占用
- [ ] 为 LoRA/ControlNet 预留明确的显存余量(以你实测的空载峰值为基准,不要贴着上限跑)
- [ ] 判断是否值得为并发升级 32GB+ 卡型
常见问题
flux.1 dev 需要多少显存?
FP8 量化下 12-16GB 可跑单图,FP16 全精度建议 32GB+ 以常驻全部权重。若开 CPU 卸载,24GB 可勉强运行,但延迟会增加。
flux.1 schnell 24g显存够吗?
单独跑单图开 CPU 卸载可以,但并发或叠加扩展时可能 OOM。建议 32GB+ 以获得稳定体验。
flux.1 fp8量化后画质会下降吗?
FP8 量化在原理上会带来一定精度损失,具体影响程度官方资料未给出量化结论,建议用你自己的真实 prompt 做 FP8 与 FP16 的同参数对比后再决定档位。
comfyui跑flux加controlnet爆显存怎么办?
优先降低分辨率或开启 VAE Tiling,同时确保 T5-XXL 和 CLIP-L 常驻;若仍爆,换 32GB 以上卡型或减少 ControlNet 层数。
flux.1 用4090还是L40S?
单卡 4090 的 24GB 在无卸载下跑 FP16 会爆,需 CPU Offload;L40S 48GB 能让全权重常驻,生产环境更稳。预算有限可先租 4090 实测,否则直接上 L40S。
在选型落地时,可以关注 NexGPU 提供的多档 GPU 型号选择与按量计费,先用小时级资源实测一次完整工作流的显存峰值与单图耗时,再决定长期规格;预制模型与应用模板能省去环境配置时间。本篇 Flux.1模型云端GPU部署教程的建议是:先按 FP8 档位租一台小时级实例跑通自己的工作流并记录显存峰值,再决定是否升到 32GB+。



评论(0)