到 2026 年底,Ollama 早已不再只是开发者在笔记本上尝鲜 7B 小模型的“本地玩具”。随着团队级代码助手(如 OpenCode)、内部 RAG 知识库以及多步骤 AI Agent 工作流的普及,越来越多研发团队选择在云端租用 Ollama GPU服务器,将其作为私有、零 Token 计费、支持 OpenAI 兼容接口的后端推理底座。然而,把 ...
在本地通过 Ollama 运行开源大模型,已经成为开发者和 AI 爱好者的“标准操作”。然而,随着模型参数量的提升和对上下文长度要求的增加,显存往往成为了难以逾越的瓶颈。很多人面临的现状是:模型跑不起来,或者为了跑模型而被迫购买昂贵的硬件。与其投入巨大成本购买难以升级的物理机,不如尝试 NexGPU 按小时计费的云端算力方案。通过 NexGPU,你可以...
据 Ollama 官方 GitHub Release Notes(v0.32.6,2026-08-05),Ollama 在 2026 年 8 月 5 日发布了 v0.32.6,带来了基于 MTP Head 的自动投机解码,并改进 /v1/chat/completions 的 OpenAI 协议兼容性。对于想在云 GPU 服务器上快速搭建内部大模型 AP...
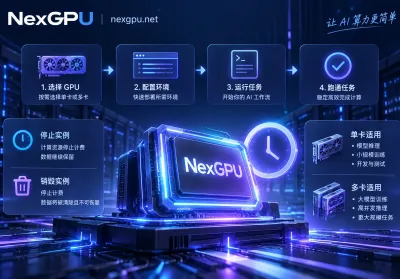
TL;DR:借助 NexGPU 平台,选用预设模板后,大约 10 分钟就能完成 Qwen3.5 Aggressive 去审查版部署,整个过程无需手动搭建环境。继续选择在L站内测,各位佬通过我们的连接注册,前言最近逛论坛时看到有大佬分享了 Qwen3.5 的部署方法,不过对很多新手来说,实际操作依然不太友好,或者受限于本地设备性能,没办法亲自体验。正好公...
 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客