两张L40S能替代一张A100吗?按任务瓶颈分四类判断

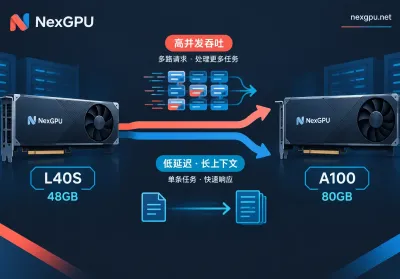
先给结论两张 L40S 凑在一起是 96GB 显存(单张 48GB),FP8 和 BF16 算力都高过单张 A100 80GB;代价是两张卡之间没有 NVLink,只能走 PCIe 4.0,单卡显存带宽 864 GB/s,大约只有 A100 HBM2e 的一半。所以能不能替代,取决于你的任务卡在哪一头:卡在算力和显存总量上,两张 L40S 更划算;卡在...

L40S 跑 Stable Diffusion 够用吗?按 SD 1.5、SDXL、Flux 和 LoRA 训练分开看

结论是够用,而且对大多数生图任务来说显存有富余。L40S 有 48GB GDDR6 ECC 显存,SD 1.5 和 SDXL 单张出图只用得到其中一小部分。所以更该问的是:你的任务能不能用上 48GB?用得上,L40S 很合适;用不上,消费级 24GB 卡通常就能完成,速度也不会差多少。下面先按模型看显存,再按任务判断要不要租 L40S,最后说明在 N...
L40S 租一小时多少钱?先看实时单价,再按算力、存储、流量算整次任务

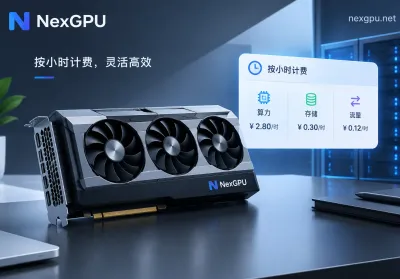
在 NexGPU 上,L40S 租一小时的价格不是一个固定数字。单价由节点的规格、网络带宽和当时的供需情况决定,所以平台不写死统一价格。你在价格与可租节点页看到的当前单价,就是下单时会用的价格。创建实例后,这个单价会锁定,一直用到你销毁这台实例为止。另外要注意,“一小时多少钱”通常只算到了算力费。一次任务的实际账单由三部分组成:算力、存储、流量。如果只...

L40S 和 A100 哪个适合推理?按模型大小、并发和上下文长度来选

先说结论:单卡装得下、请求多、能用 FP8 的推理,优先选 L40S;单路对话要求快、上下文很长、模型大到必须多卡张量并行的,优先选 A100(尤其是 80GB SXM 版)。 如果说不清自己的任务属于哪一类,可以用同一个镜像在两张卡上各跑一轮同样的请求,这比反复对照参数表更可靠。下面按你手上要跑的任务逐项判断。先用三个问题对一下自己的任务模型多大,打...

L40S 与 A100 跑大模型推理,哪张卡的 Token 成本更低?按并发、上下文和精度来选

先说结论:请求并发高、模型能放进单卡(7B/13B,或 FP8 量化后的 30B 级),并且推理框架能开启 FP8 时,L40S 的每百万 Token 成本通常更低。并发低、要求逐字输出快、上下文很长,或者要把 70B 以上未量化模型切到多张卡上跑,A100 80GB 更合适,多卡时最好选 SXM 版本。两张卡的优势对应的是推理过程中的不同阶段。弄清楚...