 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
推理延迟高,先别急着换卡。建议先把延迟拆成两段:首字延迟(TTFT)和逐字延迟(TPOT,也叫 ITL)。首字慢通常出在预填充阶段,原因多是 prompt 太长,或者请求在排队。出字卡顿通常出在解码阶段,常见原因是显存带宽不够,或者正在生成的请求被新请求打断。这两类问题的瓶颈不同,处理方法也不同,搞错方向时调参往往没有效果。
下面按排查顺序展开:先测,再排除最常见的部署问题,然后分别处理首字慢和出字慢,最后再考虑多卡。
第一步:测出慢在哪一段
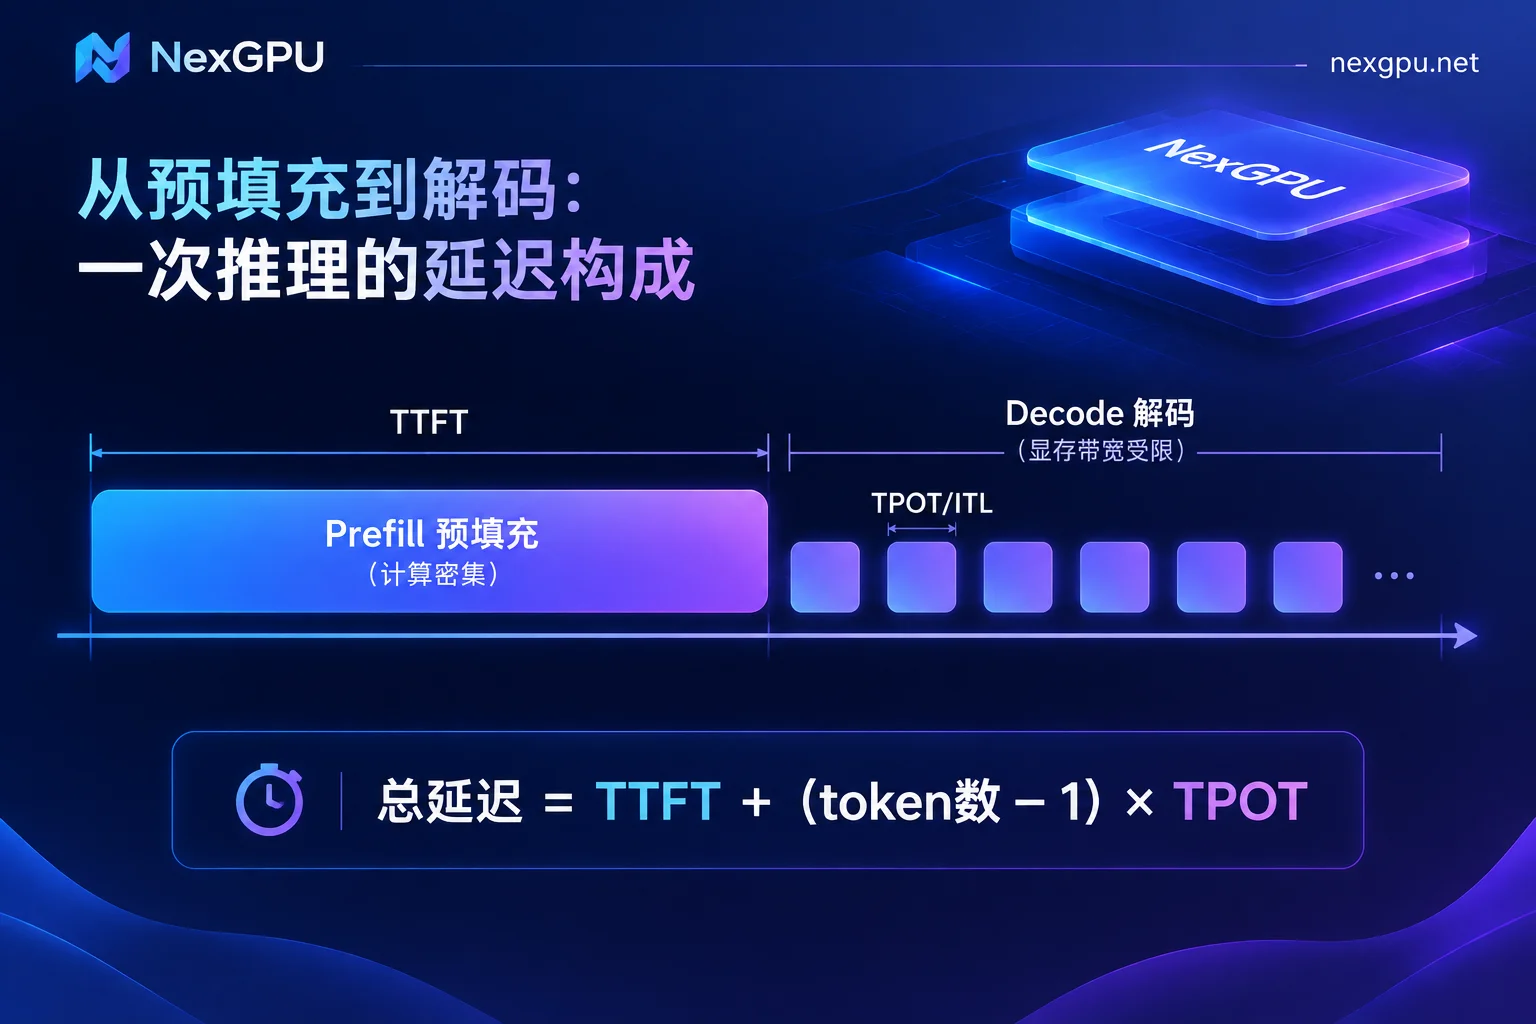
一次请求的端到端延迟大致可以这样算:
总延迟 = TTFT +(生成的 token 数 − 1)× TPOT
- TTFT:从请求发出到收到第一个 token 的时间,对应预填充(Prefill)阶段。模型要一次性并行处理全部输入,这是计算密集型任务。
- TPOT / ITL:之后每个 token 之间的间隔,对应解码(Decode)阶段。每生成一个 token,都要把模型权重和上下文的 KV Cache 从显存读一遍,计算量很小,速度主要受显存带宽限制。
测量方法:
- 用流式接口发请求,分别记下第一个 token 到达的时间和后续 token 的间隔。vLLM 这类引擎自带指标端点,可以接 Prometheus,直接查看 TTFT 和 token 间延迟的分布。
- 压测时固定三件事:输入长度、输出长度、并发数。每次只改一个参数,否则结果没法对比。
- 分别测单请求和目标并发两种情况。单请求就慢,和并发上来才慢,处理方法完全不同。
测完一般能对上下面某一行:
| 现象 | 大概率原因 | 优先尝试 |
|---|---|---|
| 单请求首字就慢,prompt 很长 | 预填充计算量大 | 精简输入、前缀缓存 |
| 并发一上来首字变慢 | 请求排队 | 专用引擎的连续批处理、调调度参数 |
| 单请求出字就慢 | 显存带宽到顶 | 量化、投机采样、换高带宽卡 |
| 并发时出字一顿一顿 | 长 prompt 的预填充插队 | 分块预填充 |
先排除:是不是还在用 Transformers 直接跑服务
如果服务是用 HuggingFace Transformers 的 generate 外面包一层 Web 框架搭起来的,这通常就是最大的问题。原生管道缺少这几项关键能力:
- 连续批处理(Continuous Batching):新请求不用等整批跑完才能加入;
- PagedAttention:按页管理 KV Cache,减少显存碎片,能同时跑更多请求;
- CUDA Graph:减少每步解码的启动开销。
线上服务和正式压测,建议直接用封装了这些能力的推理引擎,比如 vLLM、TGI 或 TensorRT-LLM。换完引擎之后,再做下面那些细调才有意义。
在 NexGPU 上可以直接从镜像模板里选 vLLM 或 TGI 一键部署,省掉自己编译和对齐 CUDA 版本的时间。模板怎么挑、有哪些坑,可以参考云 GPU 镜像模板怎么选。
另外还要确认一件事:模型是否完整加载在显存里。如果因为显存不够,部分层被卸载到 CPU 或内存,延迟会明显变高,这时后面的参数怎么调都难以弥补。
首字慢(TTFT 高)怎么处理
1. 先缩短输入。 预填充的计算量随输入长度增长。RAG 场景里一次塞进十几段检索结果,或者对话历史一直不截断,TTFT 都会明显上升。先减少召回片段数、压缩历史,这一步不花钱,效果也最直接。
2. 固定前缀开启 Prefix Caching。 如果每个请求都带同一段 System Prompt、同一套工具说明或同一份文档,可以开启前缀缓存(vLLM 中是 --enable-prefix-caching)。这样相同前缀的 KV Cache 可以复用,不必每次重算。前缀越长、复用率越高,收益越大;如果每个请求的开头都不一样,就基本没有作用。
3. 并发下首字变慢,先看是否在排队。 单请求 TTFT 正常、并发时变差,说明请求在等调度。这种情况先确认已经用上专用引擎的连续批处理,再结合下一节的分块预填充一起调。
4. 长上下文场景要考虑算力。 预填充是计算密集型任务。如果业务就是要处理很长的输入,卡的算力会直接影响 TTFT。
出字慢(TPOT / ITL 高)怎么处理
单请求出字就慢:显存带宽到顶了
解码阶段每出一个 token 都要把权重和 KV Cache 读一遍,所以提高核心频率帮助不大,关键是少读数据,或者换带宽更高的卡。
- 权重量化:用 INT4(如 AWQ)或 FP8 版本的模型,每步要搬运的数据量会成倍减少,出字速度随之提升。代价是可能损失一些精度,上线前要用自己的业务样例对比输出质量。
- KV Cache 量化:长上下文时 KV Cache 占比很大,量化后既能减轻带宽压力,也能腾出显存。FP8 等格式需要较新的 GPU 架构支持,能否使用取决于卡型和引擎版本,请以引擎文档为准。
- 投机采样(Speculative Decoding):用一个轻量草稿模型(或 Medusa 头)一次预测多个 token,再由主模型并行验证。资料显示,在低并发、单用户交互场景下,生成速度可以提升 1.5 到 2 倍以上。但在高并发场景下,它会和主推理争抢算力,可能拉低整体吞吐。所以它更适合聊天助手、个人工具这类并发不高的服务。
- 换带宽更高的卡:配备 HBM 的数据中心卡,显存带宽通常高于使用 GDDR 的消费级卡。量化和投机采样都试过、单请求速度仍不达标时,再考虑换卡。某个模型具体需要多大显存、适合哪几张卡,可以在模型选卡页按模型查询。两张常见推理卡怎么取舍,可以看L40S 与 A100 跑大模型推理的成本对比;消费级卡什么时候明显不够用,可以看这四条越界信号。
并发时出字一顿一顿:长 prompt 在插队
多个请求同时在跑时,如果来了一个长 prompt,默认调度可能先处理它的预填充,正在生成的请求就会卡一下,表现为 ITL 忽高忽低。
这时可以用分块预填充(Chunked Prefill):把长 prompt 切成小块,和解码请求混在同一批里调度。vLLM 中相关参数是 --enable-chunked-prefill,部分新版本已默认开启,请以所用版本的文档为准。配合调整 max_num_batched_tokens:
- 调小,每步预填充占用少,解码更平稳,ITL 更好(资料中给出的参考起点是 512);
- 调大,预填充推进得快,TTFT 和整体吞吐更好。
具体取值没有通用答案,要看你更在意首字还是出字的平稳,按压测结果逐步调整。
单卡不够时:多卡怎么分
如果单卡显存装不下,或者单卡延迟到了上限,想降低单个请求的延迟,应该用节点内的张量并行(TP),把矩阵计算切分到多张卡上同时算。
有两点需要注意:
- TP 非常依赖卡间高速互连(如 NVLink)。在普通 PCIe 或跨节点的环境下把 TP 开得太高,通信开销会抵消计算收益,延迟可能反而变高。租多卡实例前,先确认卡间互连方式。
- 流水线并行(PP)主要解决显存放不下和提升批处理吞吐的问题,对降低单请求延迟帮助不大。只为了降延迟,不建议优先用 PP。
如果需要多机或更大规模的部署,建议先整理好模型、并发量和延迟目标再去沟通,可以参考企业 GPU 集群咨询前的需求清单。
调优期间的费用
压测和反复调参需要实例一直开着,算力按时长计费。有两点要分清:
- 停机:算力费停止,但磁盘上的模型权重和日志还在,存储费继续收取。适合明天还要接着测的情况。
- 销毁:所有费用停止,但数据会被清空。销毁前先把压测结论、配置文件和需要保留的量化模型转存出去。
具体的计费边界可以看GPU 实例关机还收不收费。
排查顺序小结
- 用流式请求和引擎指标,分清是 TTFT 高还是 TPOT/ITL 高,并分别测单请求和目标并发;
- 确认使用的是 vLLM、TGI、TensorRT-LLM 等专用引擎,且模型完整加载在显存里;
- 首字慢:精简输入,对固定前缀开启 Prefix Caching;
- 出字慢:先做权重/KV Cache 量化,低并发场景再试投机采样;并发时出字卡顿,调整分块预填充;
- 以上都做过仍不达标,再换更高带宽的卡,或在有 NVLink 的单节点内开张量并行。



评论(0)