NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先说结论: 2026 年用开源模型跑 AI 视频生成,决定你“跑不跑得动”的不是网上流传的单一数字,而是两条完全不同的显存线——「能启动不报错(靠卸载硬扛)」和「权重全驻留显存(全速出片)」。
- 16GB–24GB 显卡(如 RTX 4090):适合跑 LTX-2.3(FP8)、HunyuanVideo 1.5(8.3B 蒸馏/卸载) 或 Wan 2.2 TI2V-5B,生成一条 5 秒 480p/720p 视频通常在 数十秒到 9 分钟 之间。
- 32GB 显卡(如 RTX 5090):是个人与工作室创作者的高性价比甜点线,跑 LTX-2.3 仅需约 4 秒(接近实时),也能稳跑 LTX-2.5 蒸馏/FP8 版,在音画同步与 720p/1080p 迭代上比 24GB 从容得多。
- 80GB–96GB+ 显卡(如 A100 80GB、H100、H200、RTX PRO 6000):如果你想跑满血 Wan 2.2 A14B 或全精度 LTX-2.5,这是绕不开的门槛。一旦在 48GB 或更小的卡上硬加载 Wan 2.2 14B 级模板,ComfyUI 不会报显存溢出(OOM),而是悄悄通过 PCIe 从内存流式读取权重,直接把 5 秒视频的耗时拖慢 3~4 倍(从十来分钟变成三四十分钟甚至一小时),算下来单条出片成本反而比租大显存卡更贵。
如果你不是每天 24 小时满载出片,自购 80GB 级别硬件并不划算,通过 AI视频生成GPU 市场按秒/小时动态切换卡型——轻量抽卡用消费级卡、重型出片切大显存卡——是目前更稳妥的解法。
一、为什么 24GB 甚至 48GB 显卡跑视频“不爆显存却慢 3~4 倍”?
很多刚入坑视频生成的用户都有过同一个困惑:明明租了一张 24GB 甚至 48GB 显存的卡,加载 ComfyUI 官方视频工作流后既没报错也没崩溃,但进度条却像卡死了一样,跑一条 5 秒钟的片段动辄半小时起步,同时后台监控显示的峰值显存竟然只有 10GB~15GB。
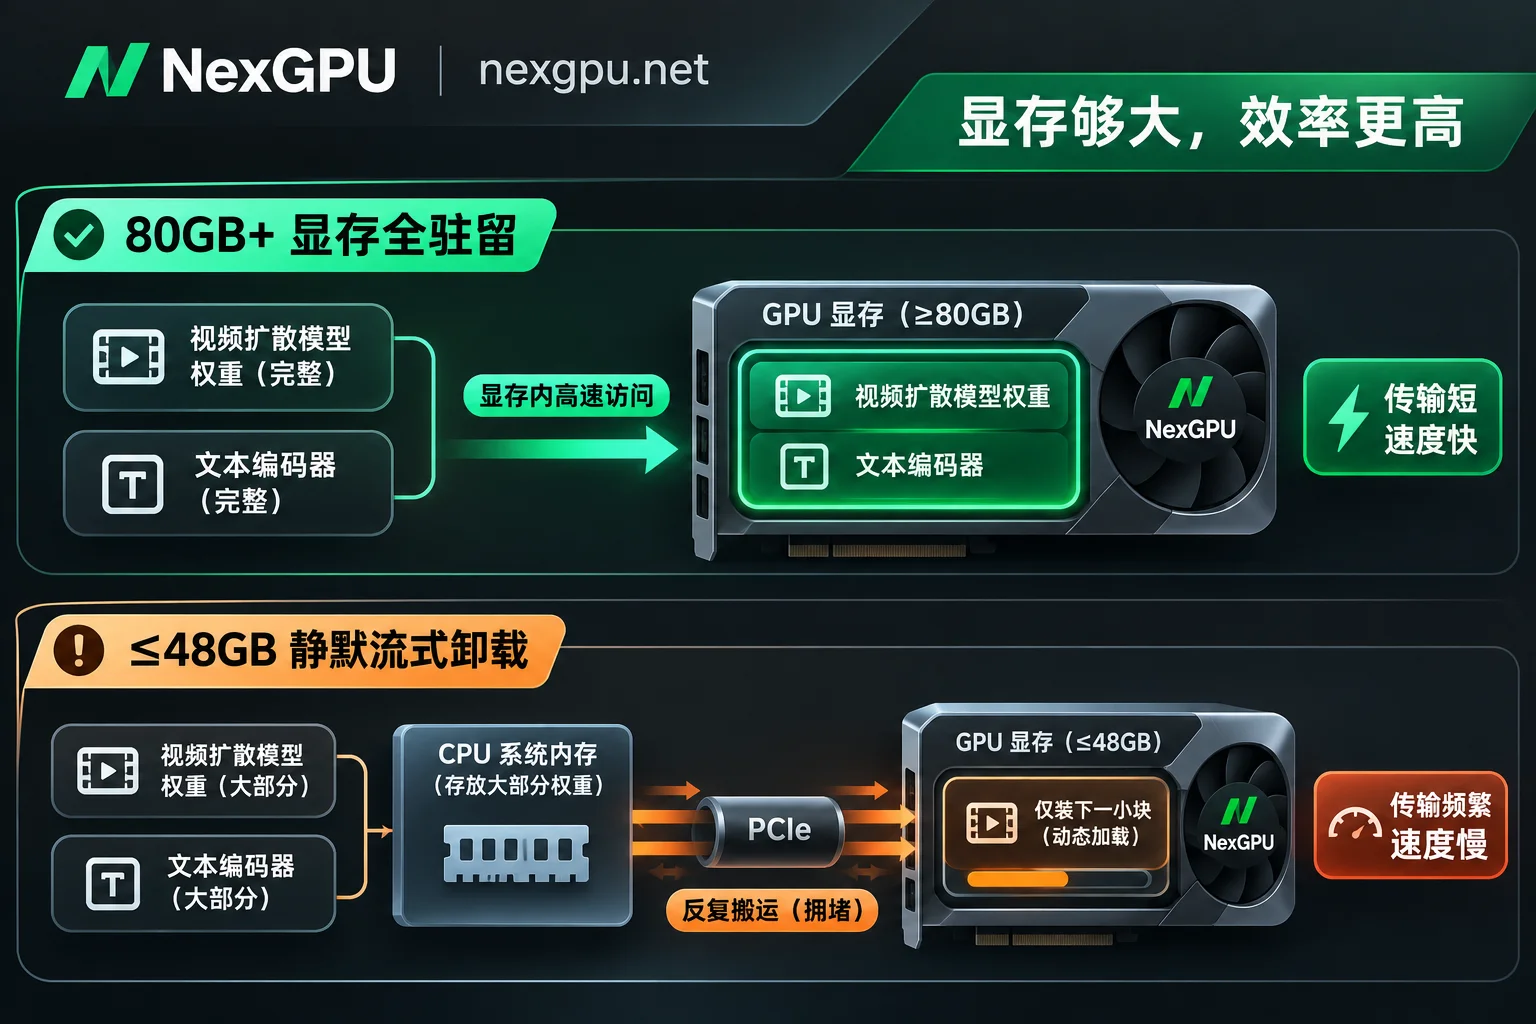
原因在于视频扩散模型的显存账和静态出图完全不在一个量级,而现代框架为了“让你能跑通”,默认开启了静默流式卸载(Streaming / CPU Offloading):
- 像素规模呈几何级放大:生成一张 1024×1024 图片大约处理 100 万像素;而生成一段 5 秒 24fps 的视频是 120 帧连续画面,算上 3D VAE 的时空压缩与帧间一致性计算,显存和算力吞吐压力比出图高出 5~10 倍。
- 文本编码器体积惊人:像 Wan 2.2 依赖 T5-XXL、HunyuanVideo 1.5 依赖 Qwen2.5-VL + Byt5,光文本编码器就占掉 10GB~20GB。
- 跨过“驻留线”后的隐形带宽税:根据 2026 年 10 月一项涵盖 23 种 GPU 配置的 ComfyUI Wan 2.2 实测基准,Wan 2.2 在 FP16 下约需 64GB 显存、FP8 权重约 36GB(加上运行时激活值仍会突破 48GB 卡的安全线)。当显卡显存低于 80GB 时,ComfyUI 并不会报 OOM,而是只把一小部分层留在显存里(监控显示峰值仅 10.5GB–15.5GB),其余权重每一轮采样都在系统内存(RAM)与显存之间通过 PCIe 反复搬运。
实测数据最直观地说明了这道分水岭的威力(同样跑一条 5 秒 Wan 2.2 FP16 片段):
- 能完整装下模型的卡:96GB 的 RTX PRO 6000 峰值显存吃满 60.7GB,耗时 734 秒(约 12.2 分钟);80GB 的 H100 PCIe 峰值 47.8GB,耗时 1,059 秒(约 17.6 分钟);H100 SXM 仅需 652 秒(约 10.9 分钟)。
- 触发流式卸载的 32GB/48GB 卡:RTX 5090(32GB)峰值只用到 14.1GB,耗时拉长到 1,297 秒(约 21.6 分钟);48GB 的 L40S 峰值 10.5GB,耗时 1,464 秒(约 24.4 分钟);RTX 6000 Ada(48GB)耗时 1,984 秒(约 33 分钟);A40(48GB)甚至要 2,810 秒(近 47 分钟)。
更反直觉的是:指望把 Wan 2.2 量化到 FP8 来拯救小显存卡,往往并不管用。 实测中,在 80GB+ 卡上切 FP8 确实能省下约 11% 的时间(如 RTX PRO 6000 从 734 秒降到 656 秒,H100 SXM 从 652 秒降到 616 秒);但在同样装不下的 48GB 卡上,A40 从 2,810 秒变成 2,749 秒(只快了 2%),RTX A6000 甚至从 2,616 秒略微变慢到 2,654 秒——因为瓶颈卡在 PCIe 搬运,而不是算力精度。
二、2026 年底主流开源视频模型:真实显存门槛与出片耗时对照
官方仓库或社区经常把“开了卸载参数后的最低启动显存”当成“推荐配置”来宣传,导致大量创作者选错显卡。下表把 2026 年 11 月最主流的四款可下载权重开源视频模型拆开对比:
| 模型(2026 主流版本) | 核心特点与音画能力 | 官方最低显存(及前提) | 不触发流式减速的舒适显存 | 5 秒片段参考耗时 | 商用授权关键边界 |
|---|---|---|---|---|---|
| LTX-2.3 | 速度极快、支持原生音画同步,可至 4K 50fps | 16GB–32GB(FP8/蒸馏) | 24GB–32GB(RTX 5090 极佳) | RTX 5090 约 4 秒;RTX 5060 Ti 16GB 约 15–20 秒 | LTX-2 社区协议(年营收低于 1,000 万美元免费商用) |
| LTX-2.5 (22B) | 2026 新一代音画同步模型,最高两阶段放大至 4K | 32GB(蒸馏+量化) | 80GB+(官方推荐 A100 80GB / H100) | 蒸馏版消费卡分钟级内;全精度集群数秒至数十秒 | 同 LTX-2 社区协议(年营收 < 1,000 万美元免费商用) |
| HunyuanVideo 1.5 (8.3B) | 动作物理感强、人像写实,原生 480p/720p 可超分 1080p,无原生音频 | 14GB(必须开启模型卸载) | 24GB–48GB | 步数蒸馏 I2V 在 RTX 4090 约 75 秒内;常规 FP8 约数分钟至十余分钟 | 腾讯混元社区协议(商用与部分地区存在限制,需核对条款) |
| Wan 2.2 TI2V-5B | 轻量密集模型,720p@24fps,无原生音频 | 24GB(需开 offload 与 --t5_cpu) | 24GB–48GB | RTX 4090 未深度优化约 9 分钟内 | Apache 2.0(商用最宽松,无营收与地区限制) |
| Wan 2.2 A14B (27B MoE) | 14B 激活参数,画质与指令遵循顶尖,无原生音频 | 80GB(官方单卡命令) | 80GB–96GB+ | 96GB 卡约 11–12 分钟;H100 SXM 约 10–11 分钟 | Apache 2.0(商用最宽松) |
选型一条铁律:如果你追求 10 秒内快速抽卡、带原生声音且公司营收在授权门槛内,优先用 LTX-2.3 / LTX-2.5;如果你看重 商业合规干净无忧,选 Wan 2.2;如果你只有 16GB–24GB 显存且主要跑图生视频(I2V),HunyuanVideo 1.5 蒸馏版或 Wan 2.2 5B 才是能让你顺畅迭代的合理起点。
关于不同业务阶段(量化抽卡、全精度出片、LoRA 训练)的具体模型搭配,还可以结合站内的《AI视频生成GPU怎么选:从ComfyUI量化抽卡、全精度出片到LoRA训练的选卡指南》以及《ComfyUI云GPU怎么选:FLUX.2 与视频生成下,RTX 5090 与 H100 的显存、带宽与每张图成本账》一起对照来看。
三、算清成本账:为什么“小时单价便宜的卡”,出一条视频反而更贵?
很多创作者租卡时只盯着“每小时多少钱”,觉得能省一半单价就选 24GB 或中低端 48GB 卡,却忽略了一个基本公式:
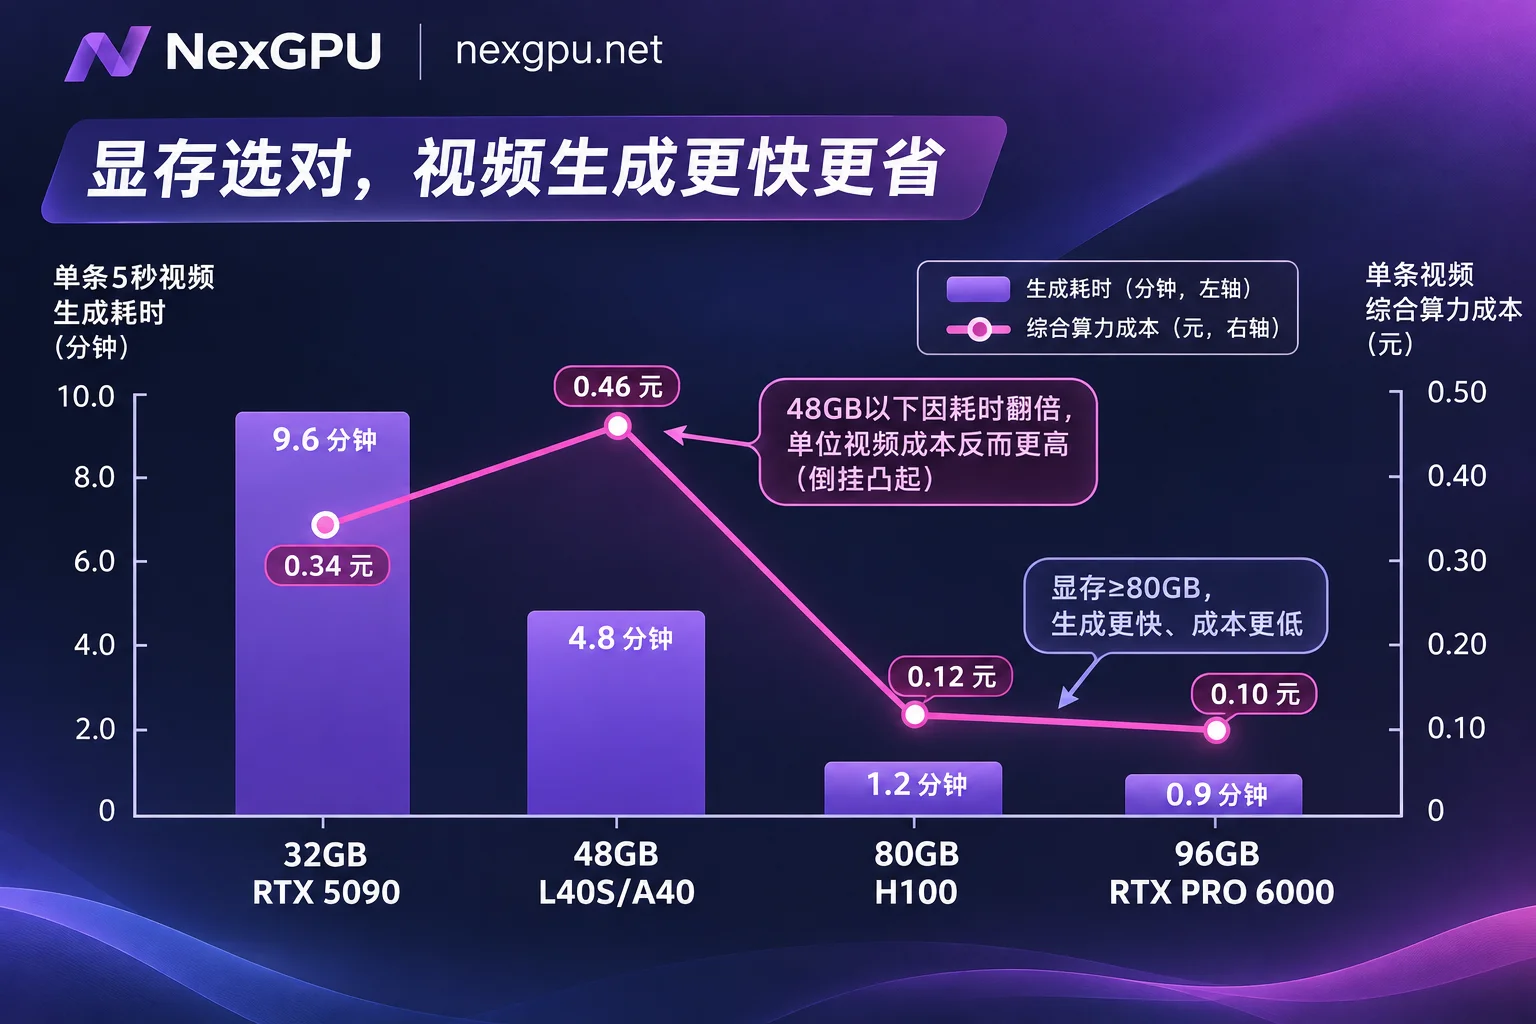
单条视频实际算力成本 = 显卡小时单价 × 实际耗时(小时)
一旦进入前面提到的“流式卸载”区间,耗时直接翻 3~4 倍,账面瞬间倒挂。在 RunPod 公开的 23 卡同模板实测中,96GB 的 RTX PRO 6000 虽然时租更高,但跑一条 Wan 2.2 FP8 片段只需约 11 分钟,折算单条算力成本约 $0.38;而小时单价看起来低得多的 L4 卡整整跑了 69 分钟,单条出片成本反而比 RTX PRO 6000 更高,同时还白白多等了近一个小时。即便是 48GB 里的 RTX A5000 勉强拉低了单条账面费用,代价比也是苦等 57 分钟才出一条 5 秒素材——只要你中途提示词写偏了一点,整整一小时就沉没了。
除了显卡算力本身,还有两项隐形消耗经常把“看似便宜”的任务拖垮:
- CPU 内存不够导致卡死:视频模型普遍需要把 10GB–20GB 的文本编码器或部分权重卸载到系统内存(RAM)。对于视频生成工作流,64GB 系统内存只是舒适线;如果机器本身只有 32GB 内存,系统会频繁读写磁盘 Swap,耗时可能直接再翻一倍。
- 权重体积与磁盘存储账:千万别按跑 SDXL 的习惯只留二三十 GB 硬盘。根据公开模型文件清单,HunyuanVideo 1.5 FP8 整套约占 21GB,Wan 2.2 A14B FP8(含编码器与 VAE)约 37GB,LTX-2.5 低显存套件约 40GB(官方建议预留 100GB 可用空间)。在云端按量租卡时,如果开机磁盘选太小,拉到一半模型直接写满报错;选太大又会涉及持续的存储月租费。
四、在 NexGPU 上按需跑通视频工作流的 4 个避坑步骤
如果你不想被本地显存锁死,又希望把单条出片的时间和费用都压在可控范围内,可以按下面的顺序在 NexGPU 上开实例:
1. 先核对模型门槛,再定卡型档位
下单前先看一遍 NexGPU 的 模型选卡指南 与 场景做法页(包含「AI 图像与视频」专题),确认当前版本模型的显存与框架要求:
- 跑 LTX-2.3 / HunyuanVideo 1.5 / Wan 2.2 5B:去 GPU 市场筛选 24GB(RTX 4090) 或 32GB(RTX 5090) 节点,单卡性价比最高。
- 跑 Wan 2.2 A14B 或 全精度 LTX-2.5:不要为了省小时费去赌 48GB 卡,直接筛 80GB+(A100 80GB / H100 / H200 / B200) 节点。
2. 先选镜像模板,让系统帮你拦截显存不足的机器
在 NexGPU 镜像模板 中,直接选用预装驱动、CUDA 与依赖的 ComfyUI 图像与视频模板(模板不分档、开机即用);如果你的工作流锁定了特定 CUDA 版本(例如 LTX-2.5 要求 CUDA 12.7+ 或部分新仓库推荐 CUDA 13+),也可以直接填入公开或私有仓库的自定义 Docker 镜像与启动命令。
在 GPU 市场采用“先选环境再筛机器”时,平台会自动标出显存不够的机器并注明原因,帮你提前规避上机后反复试错的时间。NexGPU 无需实名认证和配额申请,邮箱注册即可看到实时算力单价与磁盘单价,充值支持支付宝与 USDT(TRC20)。
3. 创建时一次留足磁盘,善用「停机保盘」控成本
开单前务必注意 NexGPU 的三个资源边界:创建后不支持扩容磁盘、不支持增删端口映射、平台也不提供自动数据备份。
- 磁盘容量:如果计划同时测试 Wan 2.2 和 LTX-2.5,建议创建时直接给足 100GB–150GB 以上磁盘空间,避免权重拉到一半报满盘。
计费与停机策略:NexGPU 账单只有算力、存储、流量三项,没有最低消费、开通费、端口费或模板授权费。算力费按秒计量、按小时计价,实例停机或销毁就立刻停收;存储费从创建起按 GB/月计,停机期间照收(具体边界可参考《云GPU存储费怎么算:按容量乘时长计,关机不停、销毁才停》)。
- 最佳实践:今天抽完卡明天还要接着调参数,选停机保盘,几十 GB 的模型权重和 ComfyUI 节点全保留,一分算力钱都不多花;项目交付、成片通过 SSH 或网页终端传回本地后,输入实例编号销毁实例,存储费即刻归零。
4. 从单卡抽卡平滑升级到 LoRA 微调或多卡批量生产
当个人测试变成商业交付——比如需要对特定角色/产品微调视频 LoRA(LTX-2.5 官方建议 LoRA 微调 80GB 起步或 32GB INT8 低显存配置,全参数微调需 4–8 张 80GB 卡),或者批量生成分镜素材——无需更换平台:在 NexGPU GPU 市场按“最少卡数”直接筛选多卡节点自助下单(下单金额 = 单卡价 × 卡数);若涉及多机 RDMA 高速互联、专属算力池或对公合同开票,可直接通过 企业方案页 联系销售团队。
五、30 秒下单自查清单
下次打开算力市场准备租卡跑 AI 视频前,先核对这 5 项再点创建:
- 模型与卡型对齐了吗? Wan 2.2 A14B / 全精度 LTX-2.5 直接上 80GB+;消费级 24GB/32GB 优先跑 LTX-2.3、HunyuanVideo 1.5 蒸馏版或 Wan 2.2 5B。
- 看的是真实显存,而不是“最低启动显存”吗? 确认不是靠 48GB 以下卡硬扛重型权重,避免交 3~4 倍的“流式卸载时间税”。
- 磁盘一次给够了吗? 按每个模型 25–45GB + 系统与缓存余量预留,防止中途无法扩容。
- 商用授权核对了吗? 商业项目优先确认 Apache 2.0(Wan 2.2)或自身营收是否符合社区协议门槛(LTX-2.5 / HunyuanVideo 1.5)。
- 成片下载后记得销毁实例吗? 停机只停算力费、不停存储费,长期不用请及时导出成果并销毁释放磁盘。