 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
先说结论。48GB 显存单卡(RTX 6000 Ada、L40/L40S、A6000、A40 这一档)的能力边界如下。
- 推理:最大能跑 70B 级模型的 4-bit 量化版,前提是单用户或小并发、上下文在 4K~8K 左右。想留出更多余量,可以选 32B/34B 的 8-bit 版,或 14B 的 FP16/BF16 原精度版。
- 微调:极限是 70B 的 4-bit QLoRA,需要把序列长度限制在 2048~4096,并开启梯度检查点和 FlashAttention。比较稳妥的做法是 14B 的 16-bit LoRA。全参数微调只能做到约 2B~3B。
下面说明这些数字怎么来的,方便你换一个模型时自己估算。
先算清显存花在哪
显存占用由三部分组成:
- 模型权重 ≈ 参数量 × 每参数字节数。FP16/BF16 每个参数占 2 字节,INT8/FP8 占 1 字节。4-bit 量化(AWQ、GPTQ、NF4 等)算上缩放系数等元数据,大约占 0.55~0.6 字节。
- 框架运行开销:一般预留 1~2GB。
- KV Cache:随上下文长度和并发数线性增长,是最容易被忽略的一项。
举个例子:70B 模型用 FP16 加载,权重约 140GB。量化到 4-bit 后约 35~42GB,可以放进 48GB 的卡,但剩给 KV Cache 的空间只有 6~13GB。权重能装进去只是第一步,还要看剩下的显存够不够你要的上下文长度和并发数。
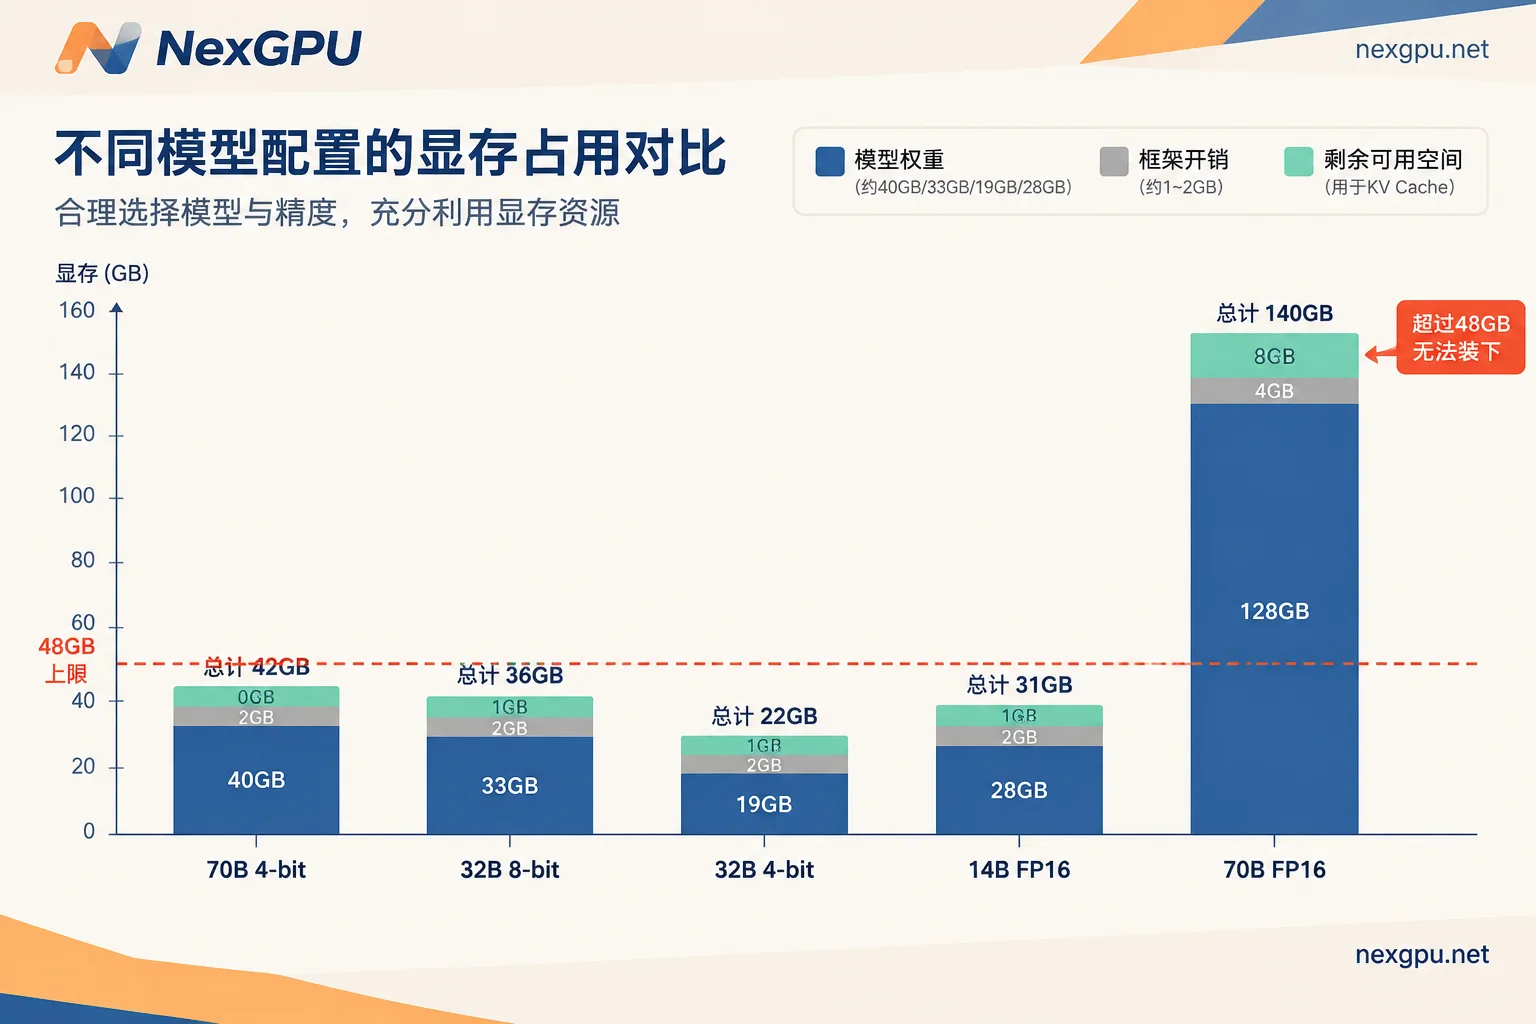
推理:按模型规模对照
| 模型规模 | 精度 | 权重约占 | 48GB 剩余(未扣框架开销) | 适合的用法 |
|---|---|---|---|---|
| 70B~72B(Llama-3-70B、Qwen-2.5-72B) | FP16 | ~140GB | 装不下 | — |
| INT8 | ~70GB | 装不下 | — | |
| 4-bit | 35~42GB | 6~13GB | 单用户或小并发,4K~8K 上下文 | |
| 32B~34B(Qwen-2.5-32B、Yi-34B) | FP16 | 64~68GB | 装不下 | — |
| INT8/FP8 | 32~34GB | 约 14GB | 常规上下文推理 | |
| 4-bit | 18~20GB | 约 28GB | 32K~64K 长上下文,或多并发 | |
| 14B(Qwen-2.5-14B) | FP16 | ~28GB | 约 20GB | 长文本或中等并发 |
| 7B/8B(Llama-3-8B) | FP16 | ~16GB | 约 30GB | 超长上下文(如 128K)、高并发生产部署 |
可以按用途来选:
- 个人使用,想要 70B 的效果:选 70B 的 4-bit 版。它能流畅对话,但不要指望处理长文档或同时服务多人。
- 要处理长文档,或给小团队提供服务:32B 的 4-bit 版余量最大。如果更在意精度,可以退到 8-bit,代价是上下文和并发空间变小。
- 对精度敏感,不想承担量化损失:14B FP16 是 48GB 能放下的最大原精度档位。
量化格式要和推理框架对应。vLLM、TGI 常用 AWQ/GPTQ 格式,Ollama 使用 GGUF(如 Q4)。下载权重前,先确认格式和你的框架匹配。
微调:方法决定能调多大的模型
微调要在权重之外额外存放梯度、优化器状态和激活值,所以同一张卡能微调的模型比能推理的小得多。
- 全参数微调:使用 AdamW 时大约每参数需要 16 字节。48GB 除以 16 约等于 3B,实际一般只能做 2B~3B 的模型。
- LoRA(底座以 16-bit 冻结):可以稳定微调 13B~14B 模型。大多数定制任务用这一档就够了。
- QLoRA(底座以 4-bit NF4 冻结):开启 FlashAttention 和激活检查点后,单张 48GB 卡刚好能在序列长度 2048~4096 内微调 70B。这是勉强能跑的状态,batch 和序列长度都没有多少调整空间。
如果训练数据大多是长样本,需要更长的序列,单卡 70B QLoRA 就不够了。
这几种情况,48GB 单卡不够
- 70B 模型需要 32K 以上上下文,或需要用连续批处理承载高并发:要用多卡张量并行。
- 32B 级模型想用 FP16 原精度推理:权重本身就超过 48GB。
- 70B QLoRA 要用超过 4096 的序列长度。
- 要对 3B 以上的模型做全参数微调。
遇到这些情况,可以换更大显存的卡,或上多卡。显存和带宽怎么权衡,可以参考 L40S 和 A100 哪个适合推理。
另外,2×24GB 的显存总量也是 48GB,但模型需要通过张量并行切到两张卡上,每张卡单独只有 24GB。vLLM、TGI 这类框架支持这种切分。不过如果模型在单卡 48GB 上放得下,用单卡部署和排查问题都更简单。
动手:选卡、选镜像,留意存储费
- 选卡:先确定模型规模和精度,再挑单卡 48GB 或 2×24GB 的规格。每个模型推荐什么卡、显存门槛是多少,可以直接查 NexGPU 模型选卡指南。
- 选镜像:做推理服务用 vLLM 或 TGI 模板。想先用 GGUF 量化版快速试效果,可以用 Ollama。微调可以从 PyTorch 镜像开始,再装训练框架。这些模板都在 镜像模板页,一键部署,不用自己配 CUDA 环境。
- 留意存储:70B 的 4-bit 权重就有约 40GB,下载一次要花不少时间。实例停机后算力停止计费,但存储继续计费;销毁后费用全部停止,数据也会一起清空。如果几天后还要接着用,可以停机保留磁盘。用完了就先把需要的权重和训练产物转移出去,再销毁。具体的计费边界见 GPU 实例关机还收不收费。



评论(0)