 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
在 NexGPU 上,L40S 租一小时的价格不是一个固定数字。单价由节点的规格、网络带宽和当时的供需情况决定,所以平台不写死统一价格。你在价格与可租节点页看到的当前单价,就是下单时会用的价格。创建实例后,这个单价会锁定,一直用到你销毁这台实例为止。
另外要注意,“一小时多少钱”通常只算到了算力费。一次任务的实际账单由三部分组成:算力、存储、流量。如果只看小时单价来做预算,常见的偏差是忘了存储费:实例停机后,存储费还在继续计。
单价怎么看,为什么同是 L40S 价格不一样
打开价格页筛选 L40S,你可能会看到不同节点标价不同。差别一般来自三个方面:
- 节点配置:同样是一张 L40S,搭配的 CPU、内存和本地盘不一样。
- 网络带宽:如果任务要频繁上传、下载数据或模型权重,带宽对实际体验影响很大。
- 供需变化:NexGPU 的算力来自全球分散的节点,空闲卡多的时候和紧张的时候价格会有差别。
选节点时别只挑最便宜的。先确认这个节点的内存、磁盘和带宽能撑住你的任务,再在满足条件的节点里比价格。下单后单价就锁定了,任务跑到一半价格不会变。
一次任务的总费用怎么估
比起问“一小时多少钱”,更有用的问题是“这件事做完要花多少钱”。可以按三项分开估:
- 算力费 ≈ 锁定单价 × 实例运行时长。平台按小时计费、按秒计量,没有最低消费,也不用签合约。跑二十分钟就按实际运行时长算,不需要凑满整小时。
- 存储费 ≈ 磁盘容量 × 保留时长。从实例创建开始,到销毁为止都在计费,停机的那段时间也算在内。
- 流量费:按公网传输量计。下载大模型权重、批量拉取数据集、把生成的视频传回本地,都会产生流量。
举个例子:你用 L40S 跑 3 小时 LoRA 微调,跑完停机,留着磁盘打算第二天接着调参。这时候账单是这样的:3 小时算力,加上从创建到最终销毁这段时间的存储,再加上下载底模和导出权重产生的流量。三项单价都以价格页为准,这里不代入具体数字。
存储费的详细算法可以看云GPU存储费怎么算。如果账单已经比预期高,可以按算力、存储、流量三项逐条对账。
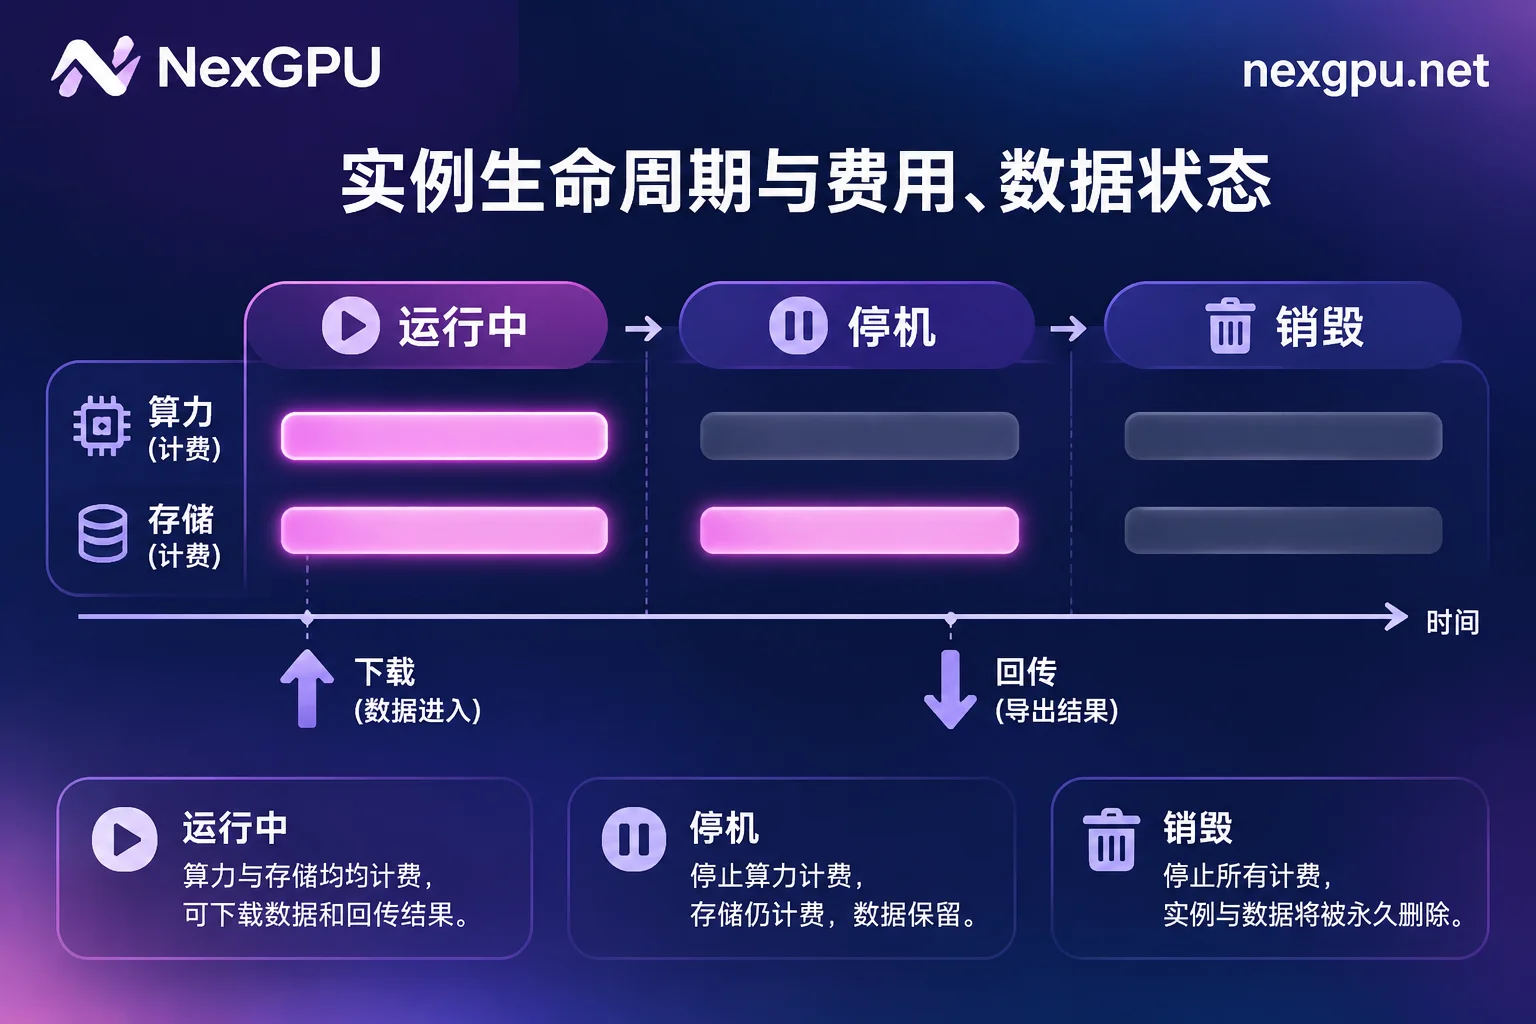
停机和销毁:哪一步会停掉哪项费用
| 实例状态 | 算力费 | 存储费 | 磁盘数据 |
|---|---|---|---|
| 运行中 | 计费 | 计费 | 保留 |
| 停机 | 停止 | 继续计费 | 保留 |
| 销毁 | 停止 | 停止 | 不再保留 |
怎么选:
- 当天或这几天还要接着用,比如环境刚配好、模型已经下载完,可以停机。这样只付存储费,下次开机省去重新部署和重新下载的时间。
- 任务已经结束,先把结果、权重和日志下载到本地或其他存储,再销毁实例。只停机不销毁,存储费会一直计下去。
- 销毁后还能不能找回数据、停机能保留多久,可以参考停机与销毁的数据和费用边界。
先确认 L40S 是不是这件事该用的卡
租错卡比单价高低更费钱。卡太小,任务跑不起来,还要重来;卡太大,就白花了钱。L40S 的几项关键规格:
- 48GB GDDR6 ECC 显存,显存带宽 864 GB/s;
- Ada Lovelace 架构,第四代 Tensor Core,支持 FP8 Transformer Engine;
- 带 3 个 NVENC 视频编码引擎。
这些规格适合以下任务:中等规模大模型的推理和 LoRA 微调、ComfyUI 或 Stable Diffusion 这类图像视频生成,以及 3D 渲染。模型能不能放进 48GB,取决于参数量、精度和上下文长度,可以对照48GB显存能跑多大的模型。如果你在 L40S 和 A100 之间犹豫,可以看按模型大小、并发和上下文来选。
多卡任务要多想一步。L40S 走 PCIe 接口,不支持 NVLink。如果你的训练需要多卡之间大量交换数据,卡间通信可能成为瓶颈,单卡价格再合适,总耗时也可能被拉长。这种情况建议先评估互联需求,再决定是否用 L40S 组多卡。
下单前的检查清单
- 模型和精度能放进 48GB 显存,并且留出了 KV Cache 或激活值需要的空间;
- 估一下系统盘和数据盘要多大,模型权重、数据集和输出结果都要算进去;
- 估一下要下载和回传的数据量,这会影响流量费;
- 想清楚任务结束后是停机保留,还是导出结果后直接销毁;
- 确认是单卡任务。如果需要多卡,先评估互联要求。
这几项都确认好以后,到价格与可租节点页看 L40S 的当前单价,挑一个配置合适的节点。然后在镜像模板页按任务选 vLLM、Ollama、PyTorch、ComfyUI 等镜像,一键部署,环境配置的时间也能少一些。



评论(0)