只是一个默认分类

Llama3 70B分布式微调算力需求:要几张卡、多少显存

先把结论摆出来:Llama3 70B分布式微调算力需求取决于微调方式和序列长度两个变量——全参数 FP16 走 FSDP/ZeRO-3 至少 4×80GB,常规配置 8×80GB;FSDP+QLoRA 4-bit 可以压到 2-4 张 24GB/48GB 中端卡;一旦序列长度拉到 8k 以上或卡间没有 NVLink,就要重新评估档位。下面直接给四档对照...

多模态大模型GPU显存配置推荐:11B与90B各要几张卡

结论先行:多模态显存三档卡型怎么落位多模态大模型GPU显存配置推荐可以先记住三个落点:11B 级视觉模型至少 32GB 显存卡型(如 RTX 5090、L40S),单卡吃紧或高并发时上 80GB(如 A100 80GB),90B 级必须 8 卡 TP=8 张量并行。视觉模型上云后,显存规划比纯文本模型更容易失准,原因在于多出三笔增量开销。下面这份速查表...
FP8与INT4量化对GPU显存的影响有多大?4笔账分开算

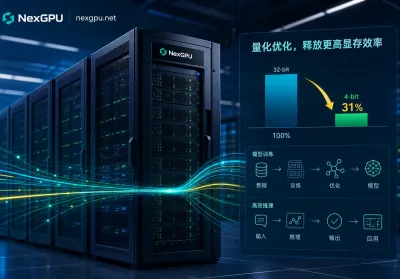
先回答:量化省的不是同一块显存,收益也不能简单相加要算清FP8与INT4量化对GPU显存的影响,第一步先把显存占用拆成四笔互不替代的账:权重占的固定空间、随并发与上下文线性增长的KV Cache、计算过程中的中间张量、以及推理引擎与CUDA上下文的常驻开销。权重量化压的是第一笔,FP8 KV Cache压的是第二笔,中间张量与常驻开销基本不随量化下降—...

Ollama私有云GPU服务器搭建怎么做?GPU直通6步

Ollama私有云GPU服务器搭建的完整路径就是 6 步:装 NVIDIA Container Toolkit、用 docker run 跑通 GPU 直通、写 Compose 固化配置、挂持久化卷保存权重、按卡做隔离、开 OpenAI 兼容接口——全程不需要分布式集群。2026 年 8 月的私有化部署实践已经把这条路径规范成了标准动作,单机单卡或多卡...

Flux.1模型云端GPU部署教程:显存要多大?

这份 Flux.1模型云端GPU部署教程先给结论:FLUX.1 [dev] 与 [schnell] 的云端显存需求按精度和用途分三档——FP8 量化 12-16GB 可跑单图,FP16 全精度需 24GB 以上且通常要开 CPU 卸载,生产级复杂工作流建议 32GB+。这个结论源自 Black Forest Labs 官方模型卡的数据,下面逐步拆解每笔...