 NexGPU-算力租赁,GPU服务器,GPU云算力,AI服务器租用-新闻博客
做播客字幕生成、会议录音纪要、跨语种视频压制或批量语音数据清洗时,把音频上传到第三方商业 API 往往面临按分钟计费累加成本高、单文件大小受限(需手动切片再合并)以及数据隐私合规等问题。因此,自己在 GPU 上完成 Whisper部署 成为了多数开发者和内容团队的首选。
但在实际动手部署时,很多人会被两个问题卡住:一是看到官方写着 large 模型要 10GB 显存、跑起来却发现速度慢且显存占用波动大;二是分不清 openai/whisper、faster-whisper 和 WhisperX 到底该装哪一个,以及 large-v3 和 large-v3-turbo 在业务里怎么取舍。
本文将从模型权重、推理运行时、显存账本和 GPU 选卡四个维度,帮你理清 Whisper 部署的最优路径。
一、模型权重怎么选:large-v3 还是 large-v3-turbo?
OpenAI 开源的 Whisper 权重从 tiny(39M)到 large-v3(1550M)共有多个尺寸。在 GPU 算力充足或按需租用成本极低的前提下,除非是极端受限的边缘端设备,否则生产环境通常只在 large-v3 和 large-v3-turbo 之间做选择:
| 模型版本 | 参数量 | 架构特点 | 核心优势 | 选型避坑提示 |
|---|---|---|---|---|
| whisper-large-v3 | 1550M | 32 层解码器,128 个 Mel 频段 | 多语言、方言、嘈杂环境及专业术语(医疗、法律、技术符号)识别率最高 | 自回归解码层数多,原生推理耗时较长,建议配合加速引擎使用 |
| whisper-large-v3-turbo | 809M | 解码器从 32 层精简至 4 层 | 保持接近 large-v3 识别精度的同时,推理速度大幅提升,显存占用减少约 40% | 不支持跨语言翻译任务(传入 --task translate 仍会返回原语言文本) |
一句话结论:如果是纯同语种转写(如中文录音转中文字幕、英文播客转英文稿),追求高吞吐和低延迟,首选 large-v3-turbo;如果音频带有浓重口音、背景噪音复杂,或者需要直接把外语音频翻译成英文文本,必须选 large-v3。
二、推理框架对比:原生 Whisper、faster-whisper 与 WhisperX
选定权重后,决定显存占用和转写速度的关键在于推理运行时(Runtime)。在 NexGPU 镜像模板库 的语音分类下,预置了 Whisper、faster-whisper 和 WhisperX 三种主流环境,它们解决的是不同阶段的需求:
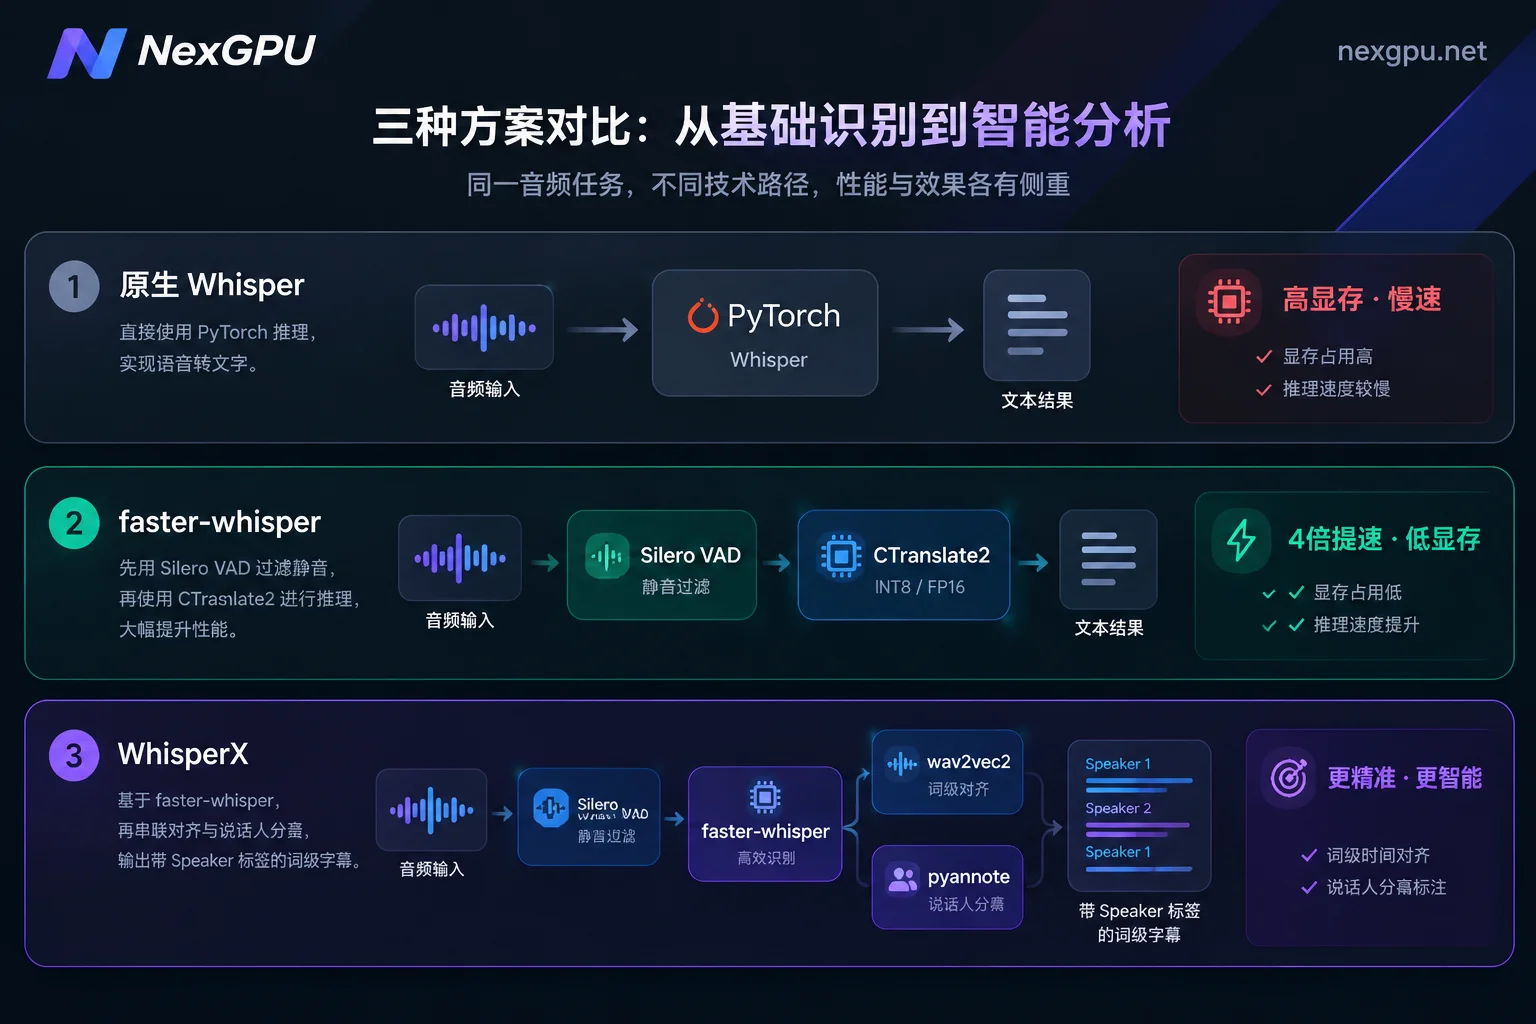
1. 原生 OpenAI Whisper(参考实现)
基于标准 PyTorch 运行,适合用来验证算法或跑通最小 Demo。但在生产环境中,它的短板很明显:显存占用高(large-v3 默认占约 10GB 显存),且长音频转写时容易因为静音段产生“幻觉”或无限重复循环。
2. faster-whisper(生产转写主力)
基于 CTranslate2 引擎重写的推理实现,通过算子融合、内存复用和量化支持,在保持同等准确率的前提下,推理速度比原生版本快 4 倍以上,显存占用降低一半以上。
在 RTX 3070 Ti 级别显卡上实测转写 13 分钟的音频(使用 large-v2 模型,Beam size=5):
- 原生 Whisper (FP16):耗时 2 分 23 秒,显存占用约 4.7GB。
- faster-whisper (FP16, batch_size=8):耗时仅 17 秒,显存占用约 6.1GB。
- faster-whisper (INT8 量化):单流显存可压至 2.9GB 左右;开启
batch_size=8批处理时耗时仅 16 秒,显存仅占 4.5GB。
此外,faster-whisper 内置了 Silero VAD(语音活动检测),只需开启 vad_filter=True 即可自动过滤静音片段,有效根治长音频的重复幻觉问题。
3. WhisperX(词级时间戳 + 说话人分离)
如果你不仅要把声音转成文字,还需要精确到每个词的字幕卡点,或者在多人访谈、会议录音中区分“谁说了哪句话”(Speaker Diarization),单靠 Whisper 是不够的。
WhisperX 以 faster-whisper 为底座,串联了 wav2vec2 语音对齐模型和 pyannote-audio 说话人分离管线。因为一条流水线里同时加载了转写、对齐和声纹聚类多个模型,它的总体显存占用会比单纯跑 faster-whisper 高出 2GB–4GB,整体耗时也会增加,但它能直接输出带说话人标签的高精度结构化字幕。
三、Whisper部署需要多大显存?该租哪张 GPU?
很多教程笼统地说“跑 Whisper 准备 8GB 或 12GB 显存即可”,但在实际工程里,单流串行转写和多路并发/大 Batch 批处理对显存的需求完全不同。
你可以直接参考 NexGPU 模型选卡指南 或 音频转文字场景方案页 查看各语音模型的显存门槛与单卡配置建议,下面按三类典型场景算一笔明白账:
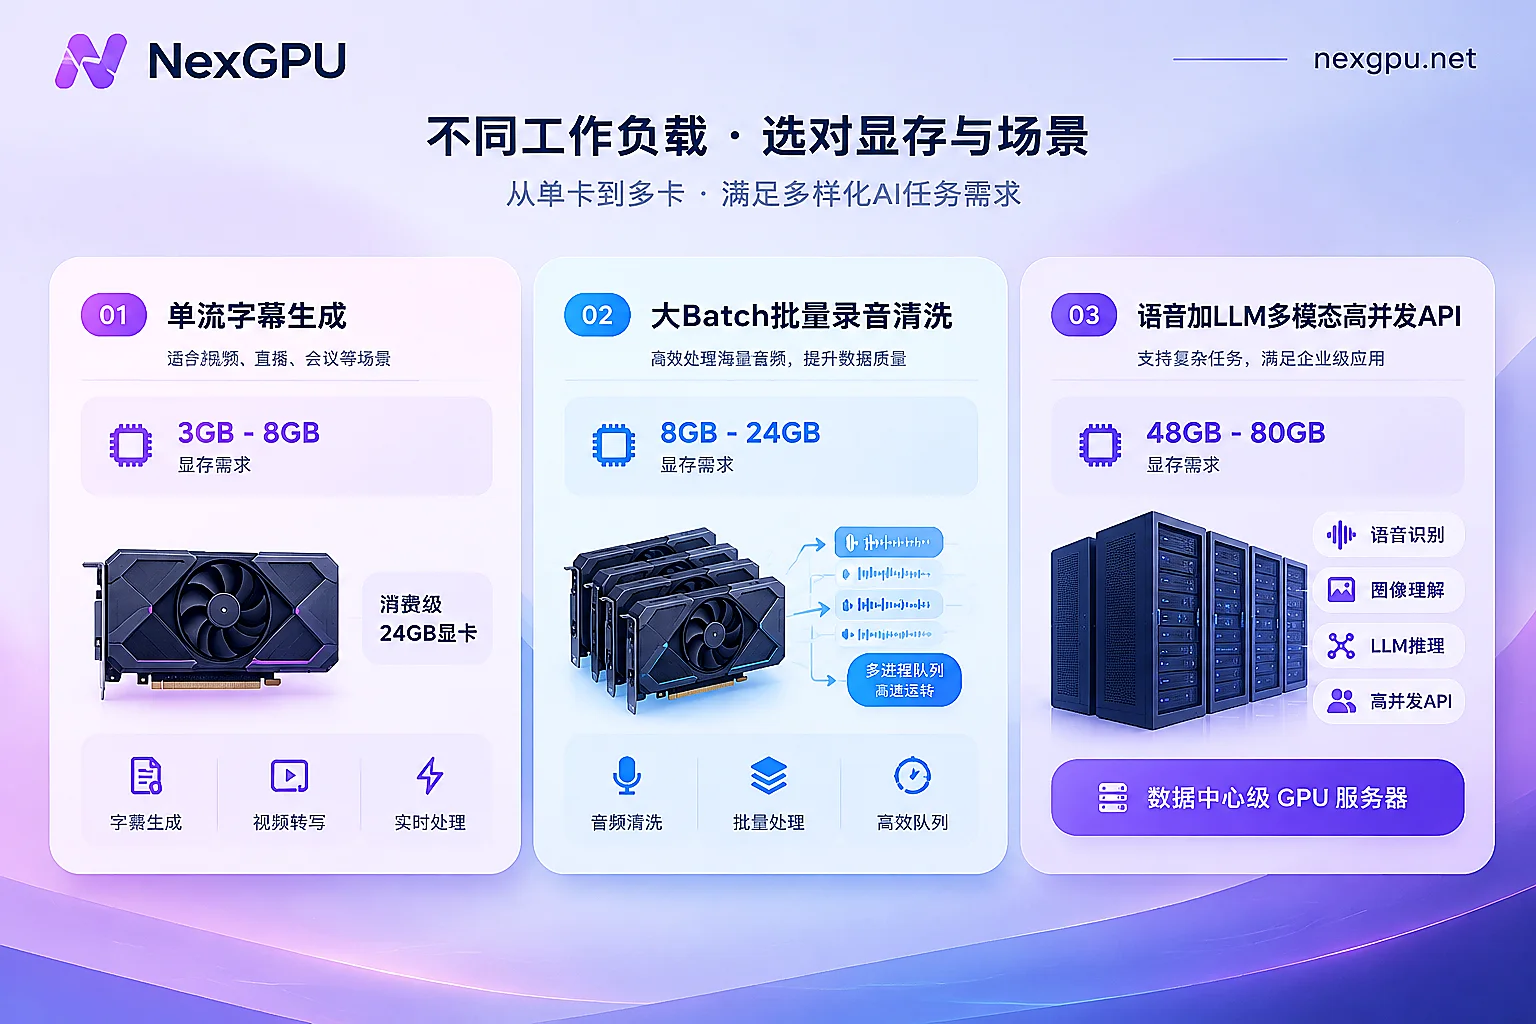
场景 1:日常音视频字幕生成、播客转写(单任务 / 离线轻量处理)
- 软件组合:
faster-whisper+large-v3或large-v3-turbo(FP16 或 INT8) - 显存账本:模型权重加载加推理缓冲区仅需 3GB–6GB 显存。但如果要开启
batch_size=8或16加速长视频转写,或者使用WhisperX挂接说话人分离模型,峰值显存会来到 8GB–12GB 左右。 - 选卡建议:在 GPU 算力市场 选择消费级显卡即可,例如 RTX 3090(24GB) 或 RTX 4090(24GB)。24GB 显存不仅能全精度(FP16)轻松装下
WhisperX全套管线,还能把batch_size拉高,1 小时的音频通常在 1–2 分钟内即可全部跑完。
场景 2:数百小时历史录音清洗、批量视频库建索引(高吞吐批处理)
- 软件组合:
faster-whisper(BatchedInferencePipeline) + 多进程队列 - 显存账本:批量任务的优化目标是“单位时间转写最多的音频时长(高 RTF 实时倍率)”。一张 24GB 或 48GB 显存的卡,可以通过调大
batch_size或在一张卡上起多个 Worker 进程把 GPU 计算单元吃满。 - 选卡建议:单张 RTX 4090 / RTX 5090,或数据中心级的 L40S / A100。如果好奇数据中心卡和消费级卡在批量任务上的成本差异,可以参考本站之前的测算思路:L40S 租一小时多少钱?先看实时单价,再按算力、存储、流量算整次任务。由于百小时级别的音频跑完即可销毁释放,按秒计量、按小时计价的算力总花费往往只有商业按量 API 的几分之一。
场景 3:企业内部语音 API 服务、大模型 + 语音多模态 Agent(在线高并发)
- 软件组合:基于
faster-whisper封装的 API 服务,或与 LLM 统一部署的服务框架。 - 显存账本:如果团队同时在跑文本大模型(如 Qwen、Llama)和 Whisper 语音识别,组装成“语音输入 → Whisper 转文字 → LLM 思考处理的 AI Agent”,两套模型同卡或同节点运行需要充足的显存余量与高带宽支持。
- 选卡建议:建议选择 A100(80GB)、H100 或多卡节点。具体选型逻辑也可延伸阅读 消费级显卡什么时候不够用:四条越界信号和换卡的判断口径。
四、在 NexGPU 上快速完成 Whisper 部署的四步流程
在本地电脑配环境时,开发者最头疼的往往不是 Whisper 本身,而是 CTranslate2、cuDNN 版本、FFmpeg 和 PyTorch CUDA 版本的连环报错。借助 NexGPU 预置镜像模板,可以跳过繁琐的底层驱动编译:
第一步:选镜像模板,自动过滤不匹配的机器
进入控制台后,直接选择语音分类下的 Whisper / faster-whisper / WhisperX 预置镜像(驱动、CUDA 及核心依赖已预装好,开机即用)。如果你有自己打包好的业务服务,也可以直接填写公开或私有仓库的自定义 Docker 镜像,并自定义启动命令与环境变量。先选定环境再去筛机器时,显存不够的机器会被自动标出并注明原因,避免选错配置(详见 选卡文档)。
第二步:按显存、带宽与磁盘单价挑机器
在 GPU 市场列表中,每一行代表一台真实可租的机器。做 Whisper 批量转写时,除了看算力单价,建议重点关注两项指标:
- 网络带宽:由于你要上传大量原始音视频文件并首次拉取约 3GB 的模型权重,选带宽较高的节点能显著缩短传输等待时间。
- 磁盘空间:注意创建实例后不支持动态扩容磁盘,请根据待处理音视频文件的总体积提前留足磁盘容量。
第三步:连接实例与开放 API 端口
实例开机后(参考 实例连接指南),你有三种方式进入环境:
- Jupyter 一键打开:适合边写 Python 脚本边调试转写参数(如测试不同的
vad_parameters和initial_prompt),令牌已自动配置好。 - SSH 直连 / 网页终端:每台实例均带公网 IP 和端口映射,SSH 直连不经跳板机;如果习惯图形化管理音频文件和转写文本,还可以一键安装可视化管理面板(aaPanel),直接在浏览器里上传音频、下载 SRT 字幕和管理后台进程。
- 暴露 HTTP 接口:每台实例除了基础连接端口外,还预留了一组备用端口。如果你用 FastAPI 把
faster-whisper包装成了语音转写微服务,直接绑定到备用端口即可供外部业务系统调用。
第四步:跑完即停,控制存储与算力成本
语音转写任务大多具有明显的波峰波谷特征。在 NexGPU 的 计费规则 中,账单只有算力、存储、流量三项,无开通费或起租时长限制:
- 如果你的音频每周定时攒一批处理,平时可以把实例停机——停机后算力费立即停止,磁盘里的模型权重和代码环境完整保留(停机期间仅按 GB/月收取存储费,详见 GPU 实例关机还收不收费?算力停了,存储还在计)。
- 如果是一次性的大型音频数据集清洗,跑完把生成的文本或字幕拉回本地后,直接输入实例编号确认销毁,算力与存储计费全部清零(注意:平台不读取也不备份磁盘内容,销毁前请务必确认转写结果已导出)。
五、提升 Whisper 生产转写质量的三个实用参数
环境跑通后,为了让 faster-whisper 在中文或多语种场景下输出更干净的文本,建议在代码中加上以下三个关键配置:
- 必开 VAD 过滤与防重复开关:
长音频遇到背景音乐或静音段极易卡死在同一句话循环输出。调用model.transcribe()时,务必设置vad_filter=True以及condition_on_previous_text=False,这是解决长音频幻觉最有效的组合。 - 用
initial_prompt引导标点与简繁体:
Whisper 有时会在中文转写中夹杂繁体字或不打标点。传入一句带标点的简体中文提示词(例如initial_prompt="以下是普通话的句子,包含完整标点符号。"),能把输出格式稳定拉回简体加标点状态。 - 专有名词用
hotwords+ 后处理词表兜底:
针对行业黑话、人名或产品名,可以在推理时传入hotwords提高命中概率,最后再配合一张简单的正则替换表做后处理兜底,即可达到商用级字幕水准。
准备好待转写的音频文件了吗?现在就可以前往 NexGPU 快速入门指南,免实名认证注册账号,挑一台高性价比 GPU 实例拉起预置语音镜像,几分钟内跑通你的专属高速语音转写管线。


